网络层
数据平面与控制平面,IP、路由器、路由选择算法、OSPF、BGP 和 SDN
网络层概述
网络层的核心职责是实现主机到主机的端到端通信。在逻辑体系上,网络层可以清晰地划分为两个组成部分:数据平面(Data Plane) 与控制平面(Control Plane)。
- 数据平面:运行在网络中每台路由器的本地硬件上,决定到达路由器某个输入链路的数据报如何转发到对应的输出链路。数据平面的转发机制主要包含两类:
- 传统 IP 转发:纯粹基于数据报的目的 IP 地址进行查表转发;
- 通用转发(Generalized Forwarding):基于数据报首部中的多个不同协议字段(如源/目的 IP、端口号、协议类型等)执行匹配并触发转发或其他动作。
- 控制平面:负责网络范围内的全局协调逻辑,控制数据报沿着从源主机到目的主机的整条端到端路径中路由器的选路方式。控制平面的核心是路由选择算法(Routing Algorithm)。
- 软件定义网络(Software-Defined Networking, SDN):通过将控制平面功能作为一种独立的软件服务从路由器硬件中剥离出来,实现了数据平面与控制平面的显式解耦。
转发与路由选择:数据平面与控制平面
转发与路由选择是网络层最关键的两个动作:
- 转发(Forwarding):路由器将分组从一个输入链路接口转移到适当输出链路接口的本地动作。转发是数据平面中唯一实现的核心功能,通常由专用硬件在线速(wire-speed)下完成。在转发过程中,分组可能被路由器安全策略阻挡,也可能根据多路径规则冗余地经过多条链路发送。
- 路由选择(Routing):确定分组从源端到目的端所采取的端到端路径的网络范围处理过程,通常由运行路由选择算法的软件来计算与协调。
路由器通过 转发表(Forwarding Table) 建立二者之间的桥梁。当分组到达时,路由器检查分组首部的一个或多个字段值,并以此为键在转发表中快速索引出对应的输出链路接口。
转发表的生成与配置取决于控制平面的实现范式:
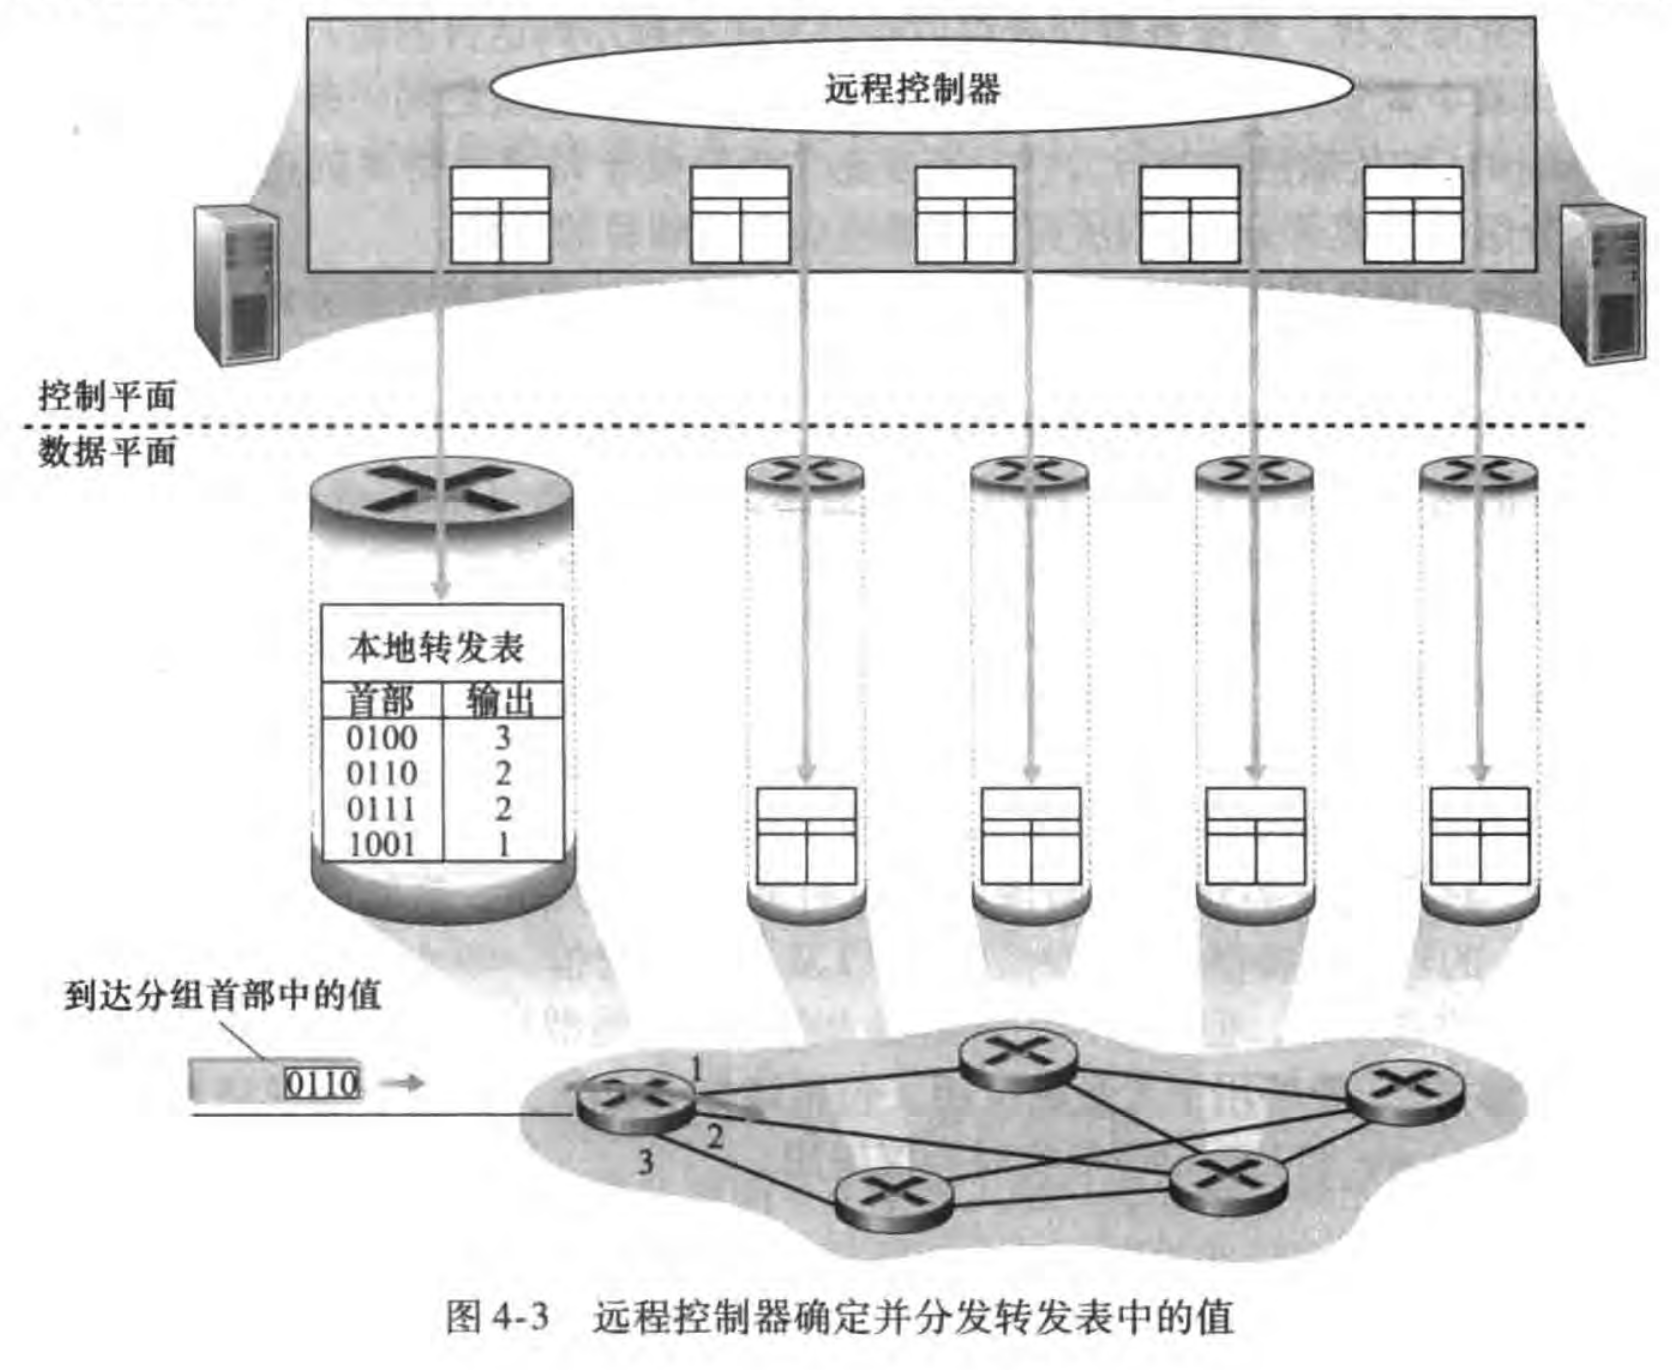
- 传统方法(每路由器控制):每台路由器各自运行路由选择算法组件,通过在网络中相互交换路由信息,彼此协作计算出各自转发表的表项。
- SDN 方法(逻辑集中式控制):底层的物理路由选择设备退化为纯粹的转发引擎,仅执行基于流表的线速转发;而全网的转发表则由远程的集中式控制器(通常部署在具备高可用与容灾冗余的云数据中心)统一计算并分发。
网络服务模型
网络服务模型(Network Service Model)定义了网络层在发送端和接收端系统之间所提供的端到端数据传输特征。
在理想设计中,网络层可以提供多种服务保障(参考可供应用程序使用的运输服务):确保交付、具有时延上界的确保交付、有序分组交付、确保最小带宽以及端到端安全性等。然而因特网的网络层在设计之初追求极致的极简与互联扩展性,上述服务一个也没有原生提供,而是提供了单一且极简的尽力而为服务(Best-Effort Service)——没有服务就是最好的服务。在尽力而为模型下,传送的分组既不保证能够最终送达,也不保证按发送顺序接收,更不保证端到端时延或最小带宽。
⚠️ 转发(Forwarding)和交换(Switching)这两个术语在工程实践和文献中经常被互换使用。
在术语分类上,分组交换机(Packet Switch) 是通用的分组交换设备,根据分组首部字段中的值将分组从输入端口转移到输出端口:
- 链路层交换机(Link-Layer Switch):基于链路层帧首部字段(如 MAC 地址)做出转发决策;
- 路由器(Router):基于网络层数据报首部字段(如 IP 地址)做出转发决策。
路由器工作原理
一台典型的路由器由四个核心组件构成:
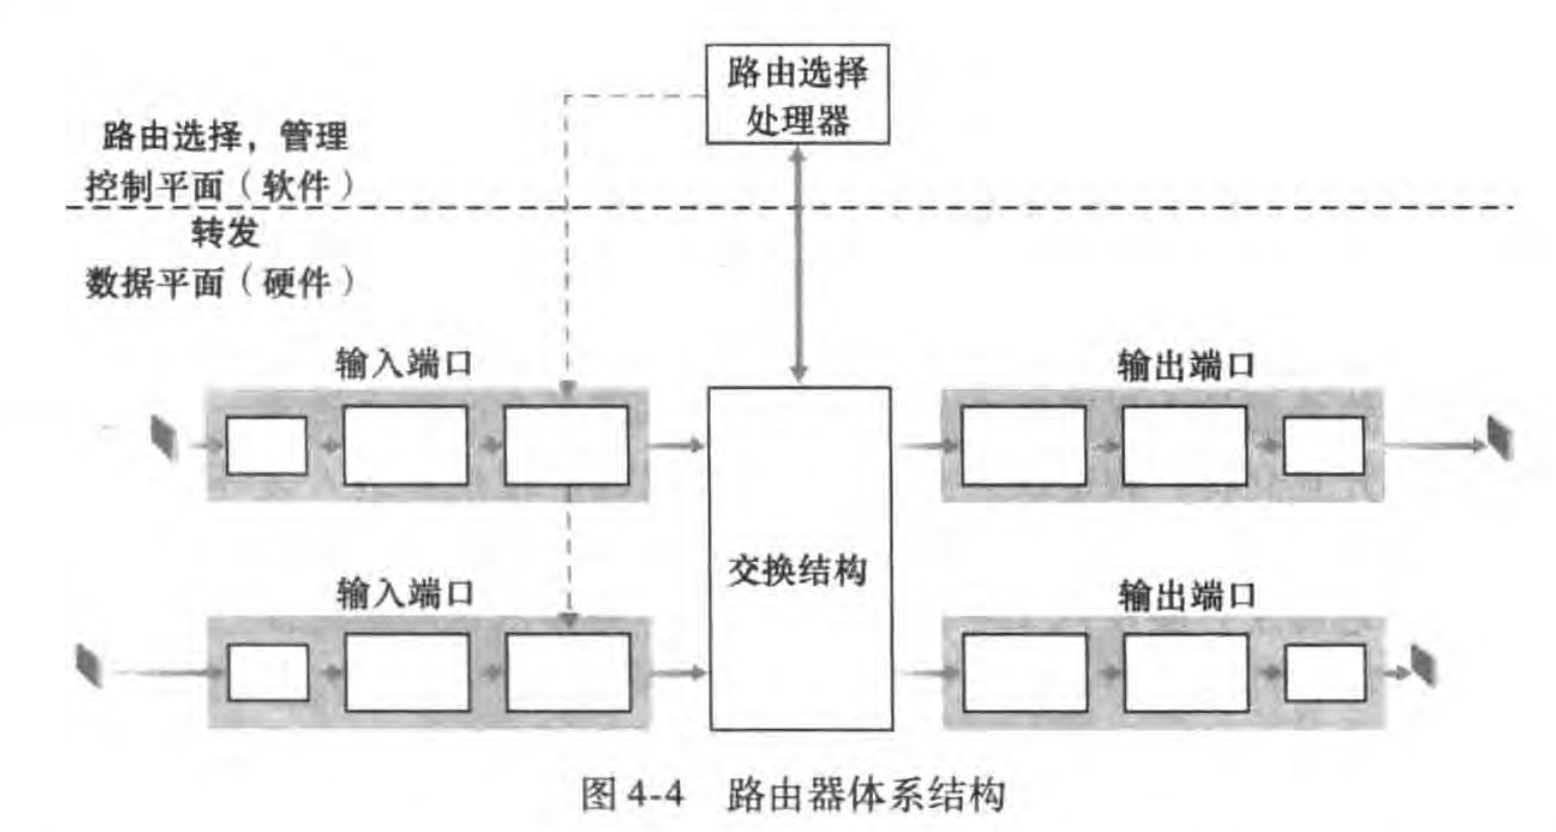
- 输入端口(Input Port):
- 终结物理入链路的物理层功能;
- 与链路另一端的数据链路层实体交互,执行数据链路层解封装;
- 快速查询转发表,决定将分组转发到哪一个输出端口;
- 将控制分组(如携带路由协议信息的数据报)转发至路由选择处理器(这里的端口指物理 I/O 接口,与运输层的软件端口号完全不同)。
- 交换结构(Switch Fabric):连接输入端口与输出端口的高速物理背板,本质上是路由器内部微型的“网络中的网络”。
- 输出端口(Output Port):缓存从交换结构传递过来的分组,并执行链路层封装与物理层调制,将分组发送到输出物理链路上(对于双向链路,输出端口通常与对应的输入端口成对集成在同一块线路卡上)。
- 路由选择处理器(Routing Processor):执行控制平面的管理与计算功能。在传统路由器中,它负责运行分布式路由选择协议、维护路由选择表与链路状态数据库并计算转发表;在 SDN 路由器中,它负责与远程控制器保持通信,接收并安装控制器下发的流表项。
为了匹配外部物理链路的吉比特乃至太比特线速传输需求,路由器的输入端口、输出端口以及交换结构几乎完全通过专用硬件(ASIC / FPGA)实现,而路由选择处理器则由通用 CPU 软件执行。
输入端口处理与最长前缀匹配
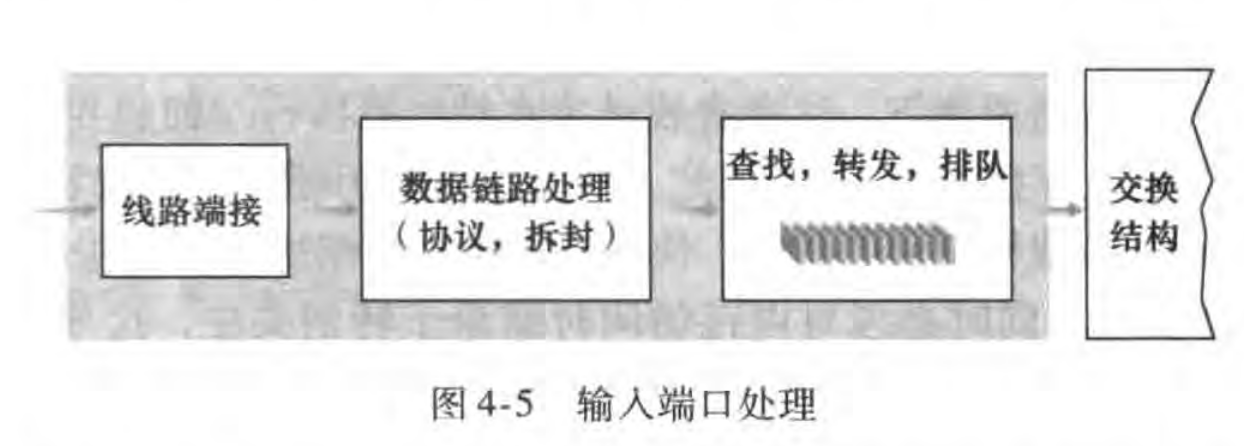
输入端口的物理线路端接和链路层处理完成了分组入站的底层协议转换。为了避免集中式查表成为吞吐瓶颈,路由选择处理器计算生成的转发表会通过内部系统总线(如 PCI-e)复制一份 影子副本(Shadow Copy) 到每块线路卡上。这样,每个输入端口都能完全在本地硬件中独立做出线速转发决策,消除了集中式处理瓶颈。
在基于目的地的 IP 转发中,路由器根据分组的目的 IP 地址在转发表中寻找匹配项。由于 IP 地址采用前缀聚合分配,转发表中可能同时存在多条覆盖同一目的地址的路由条目。路由器必须遵循最长前缀匹配规则(Longest Prefix Matching Rule):在所有匹配的前缀中,选择具有最长子网掩码(即网络位最具体)的表项进行转发。
在吉比特甚至太比特的线速环境下,转发表查找必须在数十纳秒内完成,线性搜索或简单的软件二叉树已无法满足需求。工程实践中普遍采用三态内容可寻址存储器(Ternary Content Address Memory, TCAM)。TCAM 允许在单个时钟周期内将 32 位 IP 地址与所有转发表项并行比对,在 常数时间内直接输出匹配结果及关联的输出接口。
除了地址查找外,输入端口还需要完成以下关键处理:
- 物理层与链路层帧校验和解封装;
- 检查 IP 分组的版本号,检查并校验首部检验和,将寿命字段(TTL)减 1,并重新计算重写首部检验和与 TTL;
- 更新用于网络监控与计费的管理计数器;
- 若目标交换结构或输出端口正被其他输入端口占用,进入交换结构被阻塞的分组将在输入端口的入队缓冲区中排队等待。
交换结构
交换结构是路由器的核心,负责将分组从输入端口跨越内部背板传送到目标输出端口。主流的交换结构演进出三种基本实现方式:
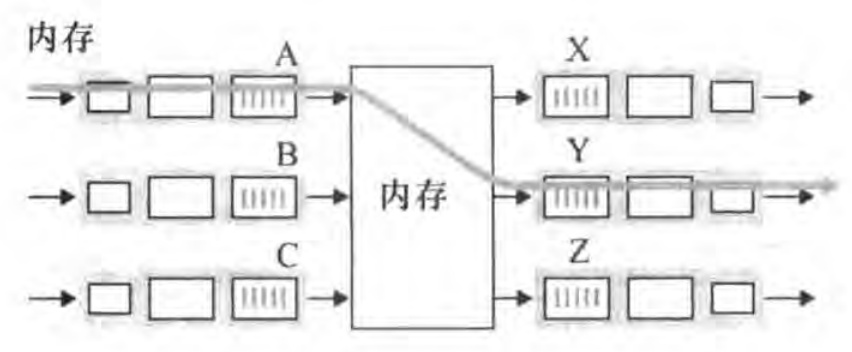
- 经内存交换(Switching via Memory):早期第一代路由器本质上是传统的通用计算机,交换过程完全由 CPU(路由选择处理器)在软件控制下完成。到达的分组首先通过系统总线复制到系统主存中,提取并解析首部后,再由 CPU 将分组复制到目标输出端口的缓存区。由于系统主存带宽有限且共享总线一次只能执行一次内存读/写操作,路由器无法同时转发两个分组,其转发吞吐量受限于主存吞吐上限。现代路由器即使采用内存交换架构,也已改由输入线路卡查表并直接将数据写入目标端口对应的内存存储位置。
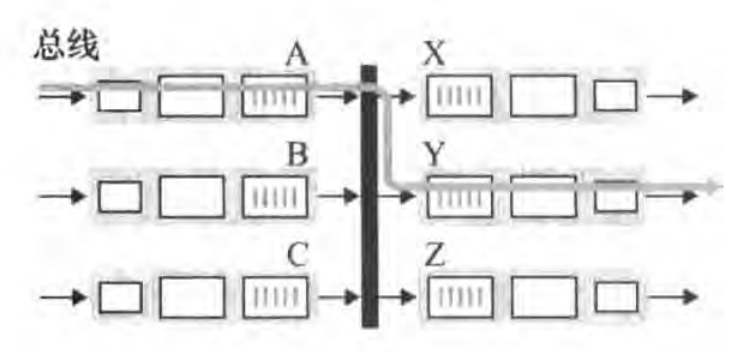
- 经总线交换(Switching via Bus):输入端口通过一条共享的内部高速背板总线将分组直接传送到输出端口,无需主 CPU 的直接介入。输入端口会在分组前追加一个交换机内部标签以指示目标输出端口,分组广播至所有输出端口,但只有标签匹配的输出端口才会接收并保存该分组。因为共享总线同一时刻只能容纳一个分组传输,交换带宽受限于单一总线的传输速率。
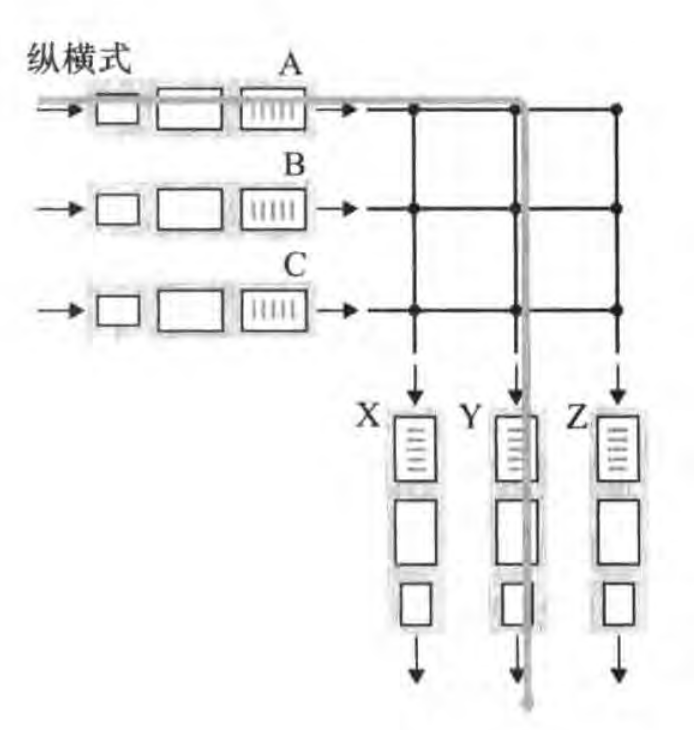
- 经互联网络交换(Switching via an Interconnection Network):为了克服单一共享总线的带宽瓶颈,现代高性能路由器广泛采用复杂的互联网络拓扑(例如纵横式交换机 Crossbar Switch)。纵横式交换机由 条总线组成,将 个输入端口与 个输出端口正交交叉连接,交叉点由交换结构控制器动态开启或闭合。纵横式结构具有 非阻塞(Non-blocking) 特性:只要多个分组前往不同的输出端口,它们就可以在互联网络中并行传输而互不干扰。仅当来自两个不同输入端口的分组试图同时发送到同一个输出端口时,才会产生争用,其中一个分组必须在输入端等待。
输出端口处理
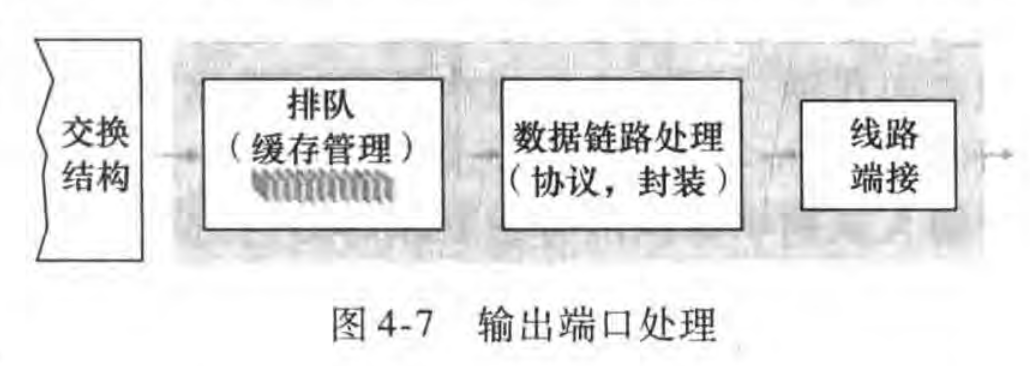
输出端口的主要职责是接收并缓存从交换结构跨越而来的分组,并在输出链路上按序调度发送。它维护着输出传输队列,执行必要的链路层协议封装(如生成帧首部与尾部校验序列),并通过物理层发射器将比特流推送至出站物理信道。
排队与丢包
路由器的输入端口和输出端口均可能产生排队队列。排队的位置与严重程度取决于网络流量负载、交换结构的相对速率以及输出链路的传输速率。当到达的分组速率持续超过处理或排空速率且缓冲区耗尽时,就会发生丢包(Packet Loss)。
输入排队与 HOL 阻塞
当交换结构的内部吞吐速率落后于所有输入端口聚合的输入速率时,分组就会在输入端口处积压排队。
在纵横式无阻塞交换结构中,即使两条输出链路各自空闲,输入排队仍可能引发严重的性能退化,即线路前部阻塞(Head-Of-the-Line, HOL 阻塞)。
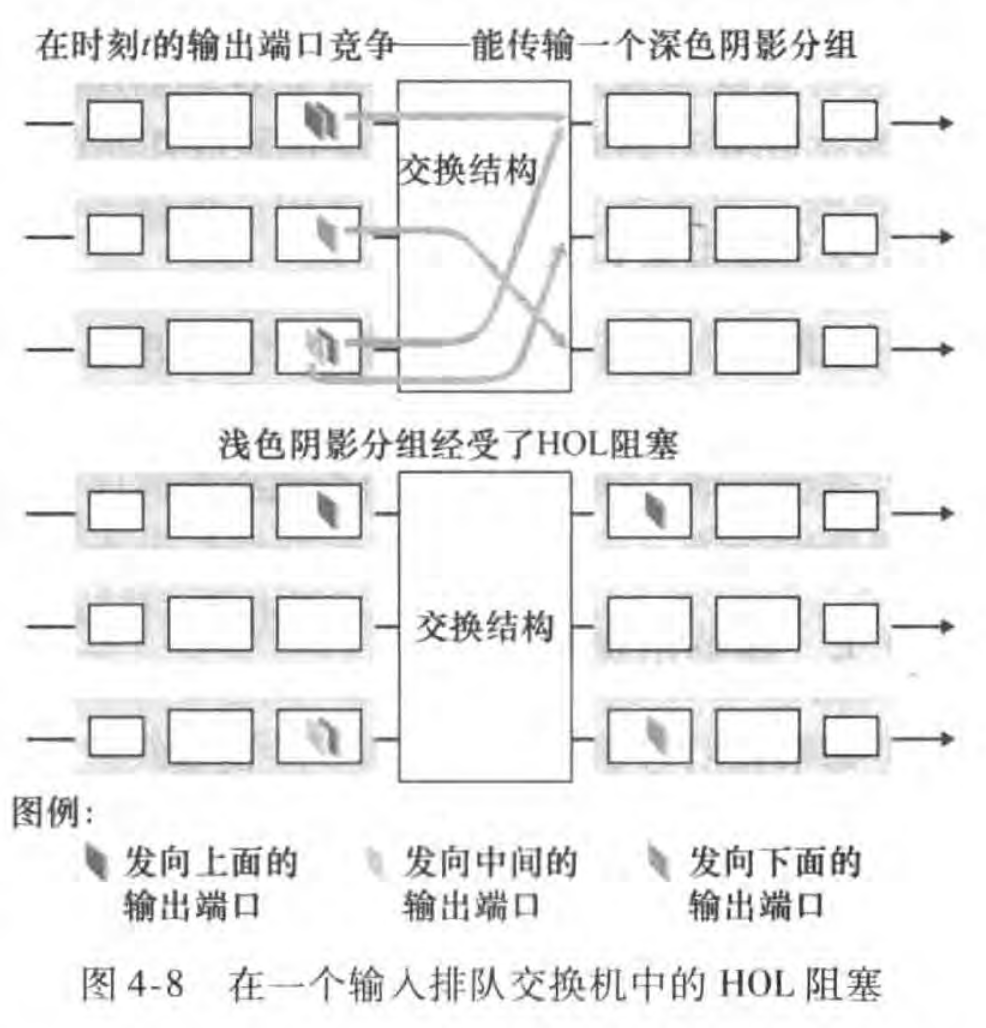
假定各端口链路速率相同且分组以先来先服务(FCFS)排队。如图所示,两个输入队列顶部的分组恰好都要送往同一个输出端口(红色的输出端口),交换结构只能允许其中一个通过,另一个被迫在输入队列头部等待。此时,位于被阻塞分组后面的第二个分组(例如绿色的分组),尽管其目标输出端口完全空闲,却因为排在前面的分组未能出队而同样无法进入交换结构。这种因队列前部受阻而牵连后续无关分组等待的现象即为 HOL 阻塞,它可能导致输入端口的有效吞吐量大幅下滑。
输出排队与主动队列管理
当来自多个输入端口的分组同时涌向同一个输出端口,且交换速率快于该端口的链路发送速率时,分组便在输出端口的发送缓冲区中累积,形成输出排队。
当输出缓存耗尽时,路由器必须采取丢弃策略:
- 弃尾(Drop-Tail):简单粗暴地丢弃最新到达的分组,但这容易引发全局 TCP 连接的同步退避;
- 主动队列管理(Active Queue Management, AQM):在缓存彻底填满之前,根据队列均长按概率主动丢弃或标记一部分分组,从而向发送端提前发送网络拥塞信号。其中最具代表性的是 随机早期检测(Random Early Detection, RED) 算法。

关于路由器输出缓存容量大小的选择,传统的网络工程经验法则认为,缓冲区大小 应当满足:
其中 为端到端往返时延, 为链路带宽容量。然而近年来的理论推导与实验表明,当一条瓶颈链路上并发流动着大量( 条)独立的 TCP 连接时,由于各连接的统计多路复用效应,所需的缓冲容量可以大幅缩减至:
分组调度
当多个分组在输出端口排队等待时,分组调度器(Packet Scheduler) 负责裁决下一个被推送到物理链路上的分组。常见的分组调度算法包括:
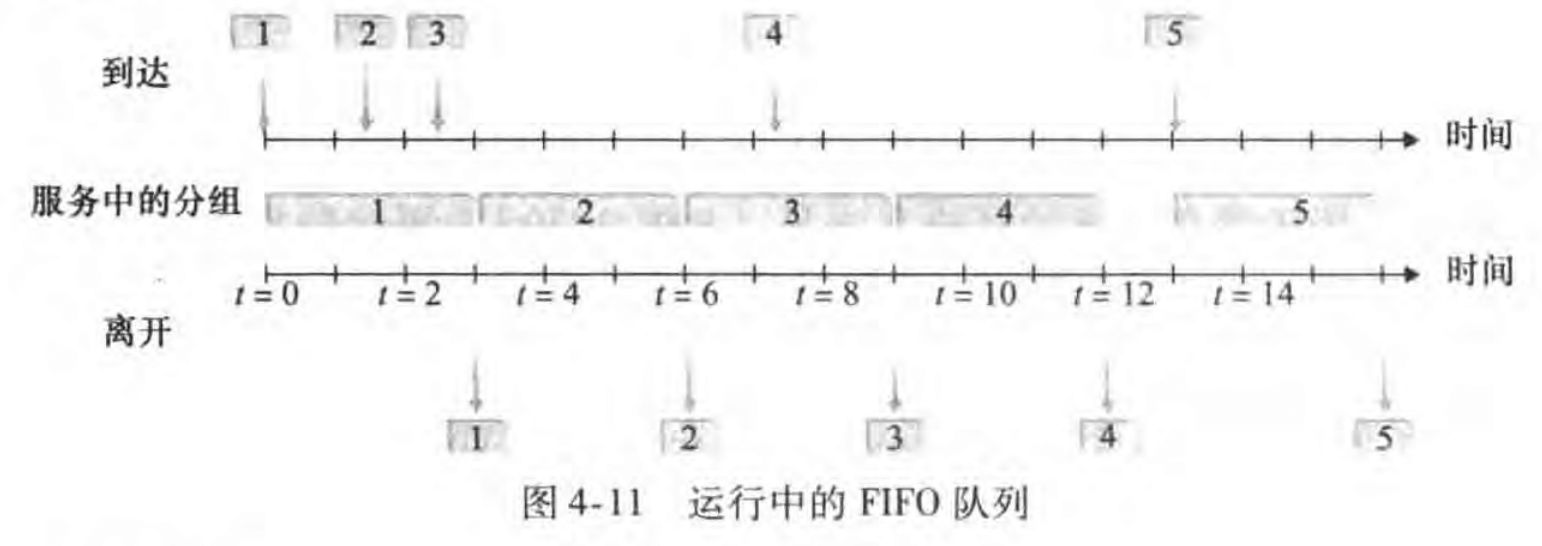
1. 先进先出(FIFO / FCFS)
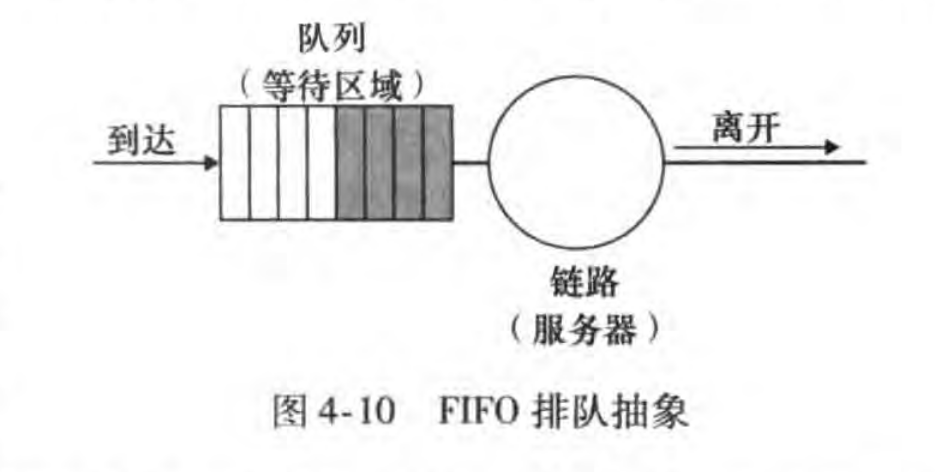
FIFO 是最简单的调度策略,严格按照分组到达队列的自然时间次序进行选拔并发送。如果链路空闲,到达分组立即发送;若链路正忙,到达分组按序排队;若缓冲区已满,则由丢弃策略(如弃尾)决定是丢弃到达分组还是腾退已有分组。
2. 优先权队列(Priority Queuing)
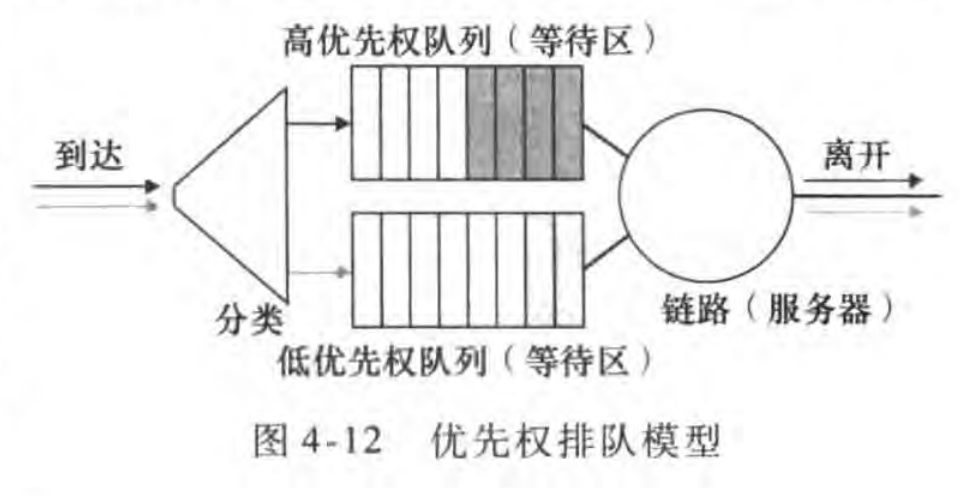
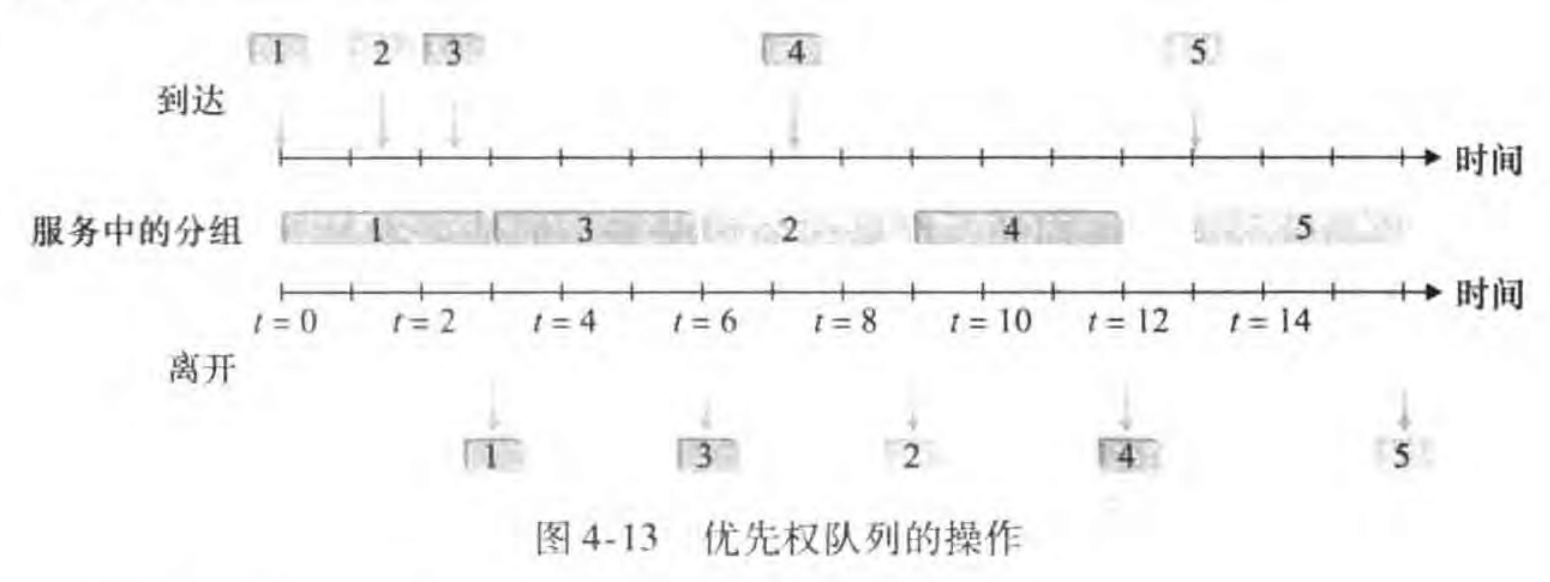
到达的分组根据首部中的服务类别(如 DSCP)被分类并引导至不同优先级的独立队列中。在调度发送时,调度器始终从当前非空的最高优先级队列中抽取分组发送;同一优先级内部的分组则按 FIFO 顺序服务。
实际部署中通常采用非抢占式优先权排队(Non-preemptive Priority Queuing):一旦某个低优先级分组已经开始在信道上传输,即便此时到达了一个高优先级分组,也不能打断正在进行的传输,高优先级分组必须等待当前传输完全结束。
3. 循环加权公平排队(Round Robin & WFQ)
在 循环排队(Round Robin Queuing) 规则下,各业务类别之间不存在绝对的高低优先特权,调度器在各个非空队列类别之间按顺序轮流服务。同时,调度器遵循 保持工作排队(Work-Conserving Queuing) 规则:只要网络中有任何分组在等待,信道就绝不允许闲置;如果轮询到某个类别为空,调度器立即跳至下一个类别提供服务。
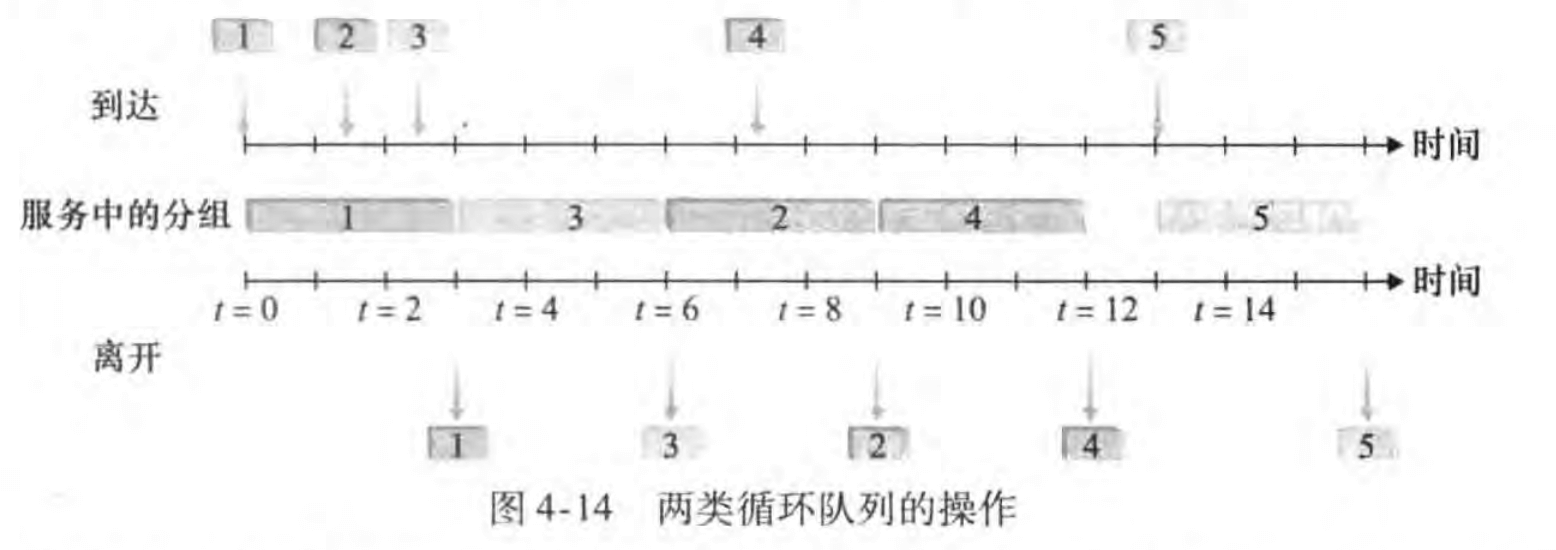
加权公平排队(Weighted Fair Queuing, WFQ) 是循环排队的泛化与工业级标准:
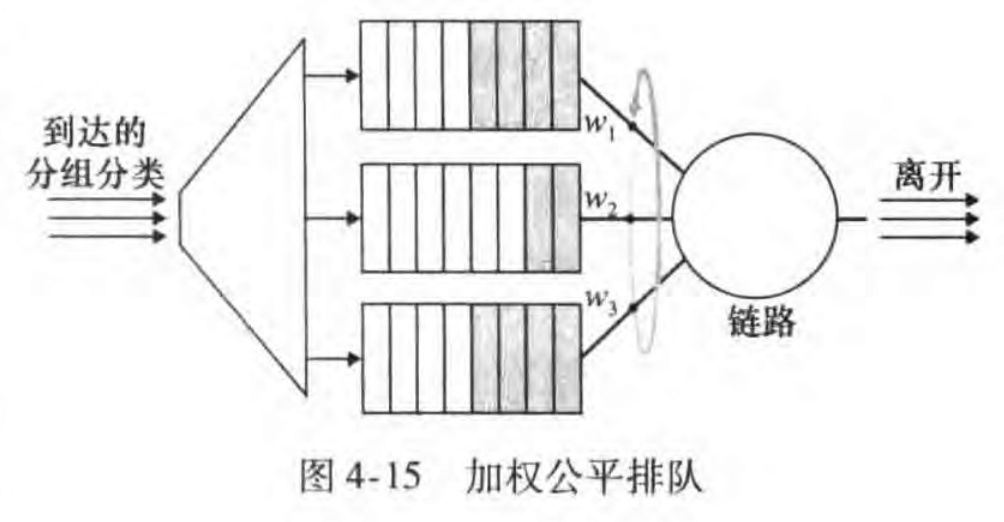
到达分组同样被分类缓存在对应类别的独立队列中,调度器以加权轮询方式为各队列提供服务。与普通循环排队各队列平权不同,WFQ 为每个类别 分配一个确定权重 。在任意时间区间内,第 类所保证获得的传输带宽份额严格等于其权重占比:
对于一条总传输速率为 的物理链路,第 类业务在拥塞时也能稳固获得至少如下保证吞吐量:
网际协议
IPv4 数据报格式
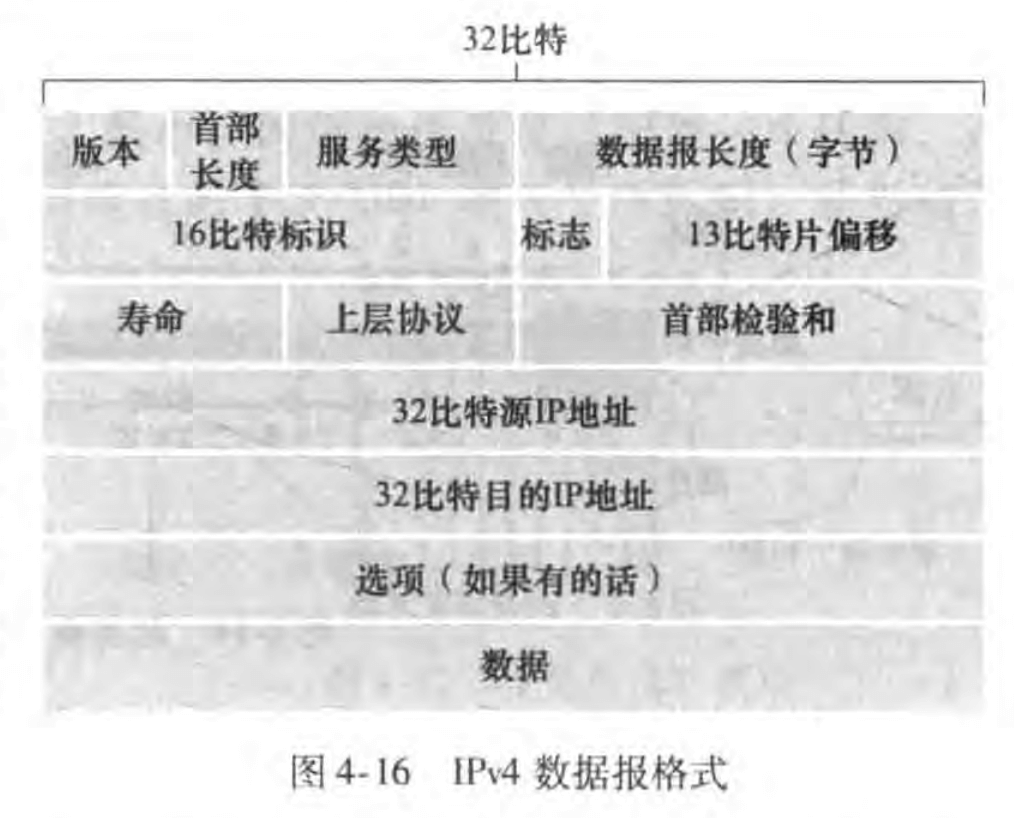
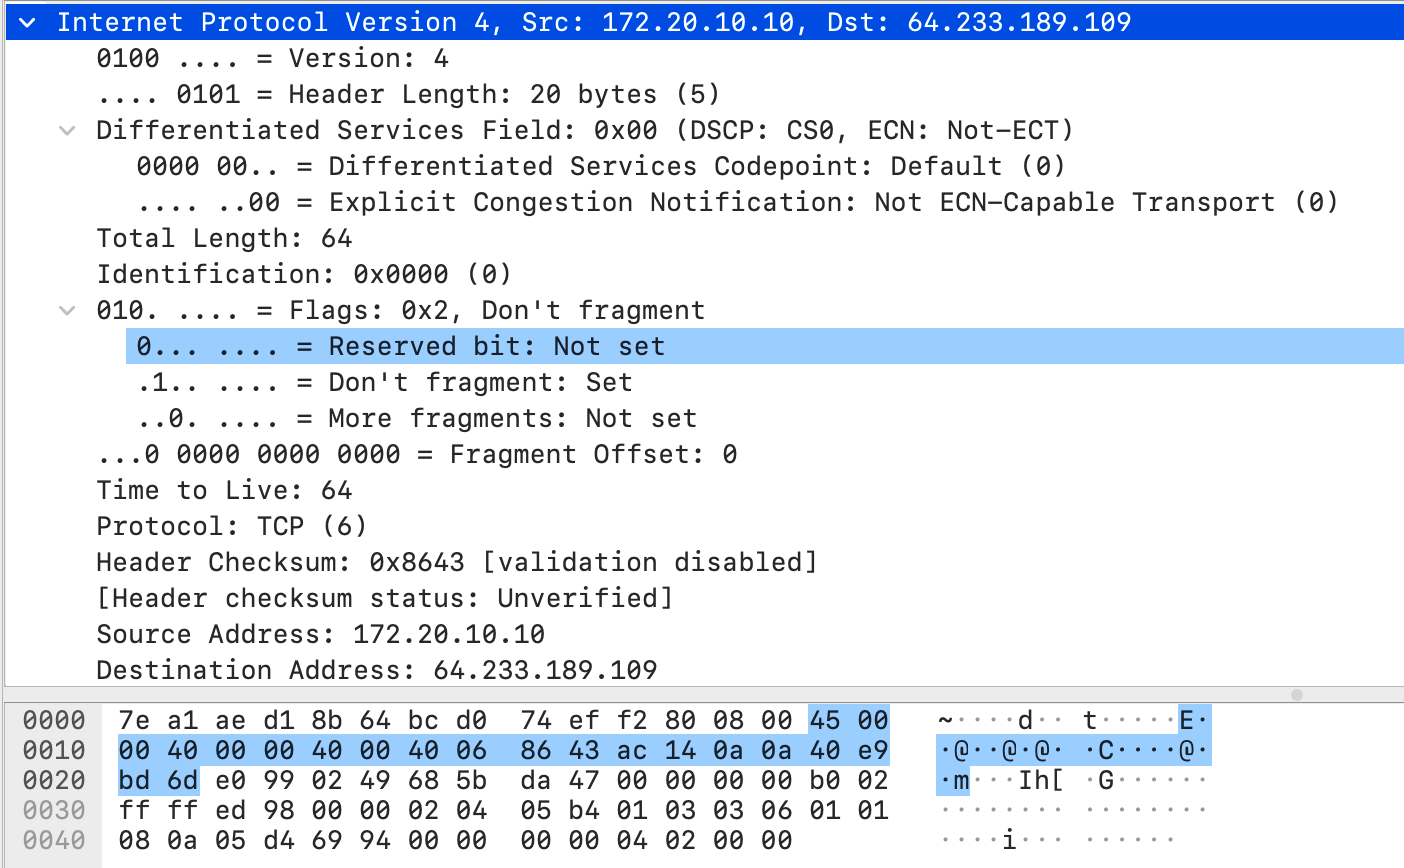
标准的 IPv4 数据报首部长度为 20 字节(若不包含可选字段),各字段具体职能如下:
- 版本(Version,4 比特):规定 IP 协议版本号。IPv4 取值为
0100(4),IPv6 取值为0110(6)。路由器首先通过该字段确定如何解析后续首部。 - 首部长度(IHL, Internet Header Length,4 比特):以 4 字节(32 比特字)为单位记录 IP 首部的总长度,用于确定有效载荷数据的起始偏移量。无选项时该字段值为 5(即 字节)。
- 区分服务(Differentiated Services, DS,8 比特):用于区分不同类型的 IP 数据报,便于现代网络实施服务质量(QoS)保障 [@DifferentiatedServices2023]。前 6 位为区分服务代码点(DSCP),后 2 位被用于显式拥塞通知(Explicit Congestion Notification, ECN):
- ECT(ECN-Capable Transport,位 6):若置位,表明发送端运输协议支持 ECN 机制,能够承受拥塞通知而无需通过直接丢包来反馈;
- CE(Congestion Experienced,位 7):路由器若在转发路径上检测到拥塞,可直接将此位置位,通知接收端尽快减速。
- 数据报长度(Total Length,16 比特):记录 IP 数据报的总体大小(首部加有效载荷)。以太网帧的 MTU 为 1500 字节,该字段确保数据报能作为载荷安全地封装进链路层帧中。
- 标识(Identification)、标志(Flags)与片偏移(Fragment Offset):与 IPv4 数据报分片 紧密相关。
- 寿命(Time-To-Live, TTL,8 比特):防止失控数据报在路由环路中永久循环。数据报每经过一台路由器,TTL 值减 1;一旦 TTL 衰减至 0,路由器必须果断丢弃该数据报并向源端发送 ICMP 超时报文。
- 协议(Protocol,8 比特):指示有效载荷中的数据应当交付给上层的哪一个特定运输层协议(例如 6 代表 TCP,17 代表 UDP,具体见 IANA Protocol Numbers)。协议号字段充当了网络层与运输层之间的多路分解粘合剂。
- 首部检验和(Header Checksum,16 比特):用于检测首部传输过程中的比特差错,计算方式同因特网检验和。由于每台路由器在递减 TTL 时都会修改首部,因此每跳路由器都必须重新计算首部检验和并写回。
为什么网络层和运输层都要进行差错校验?
首先,IP 检验和仅仅保护 IP 首部,并不保护其承载的有效载荷;而 TCP/UDP 检验和是对整个报文段(首部加数据加伪首部)进行的全局校验。其次,从分层解耦角度看,网络层与运输层具有协议独立性,TCP/UDP 无法假定底层运行的协议(如未来新网络层协议)必然具备差错校验能力。 - 源与目的 IP 地址(Source and Destination IP Address,各 32 比特):记录端到端通信双方主机的网络接口地址。通常源主机通过 DNS 域名解析来确定目的 IP 地址。
- 选项(Options):允许对首部进行灵活扩展(如记录路由、时间戳等),但因导致首部长度可变加重了路由器硬件处理负担,在 IPv6 中已被彻底移除。
- 数据(有效载荷,Payload):包含要交付给目的地的运输层报文段,或者承载 ICMP 差错控制报文。
IPv4 数据报分片
链路层数据帧能承载的最大数据载荷称为最大传送单元(Maximum Transmission Unit, MTU)。端到端路径上的每条链路可能运行不同的链路层协议,因而各自具有不同的 MTU(例如以太网 MTU 为 1500 字节,而某些广域网链路可能更小)。
当一台路由器收到一个大尺寸 IP 数据报,且其出链路的 MTU 小于该数据报的长度时,路由器就必须对数据报执行分片(Fragmentation):将初始数据报中的有效载荷切割成两个或多个较小的片段,每个片段加上独立的 IP 首部封装为单独的链路层帧发送出去(这些切片被称为片,Fragment)。
秉持“保持网络核心极简”的体系设计哲学,IPv4 架构师决定将数据报的重组(Reassembly)工作完全移交给最终的目的端系统,而非由中间路由器完成。
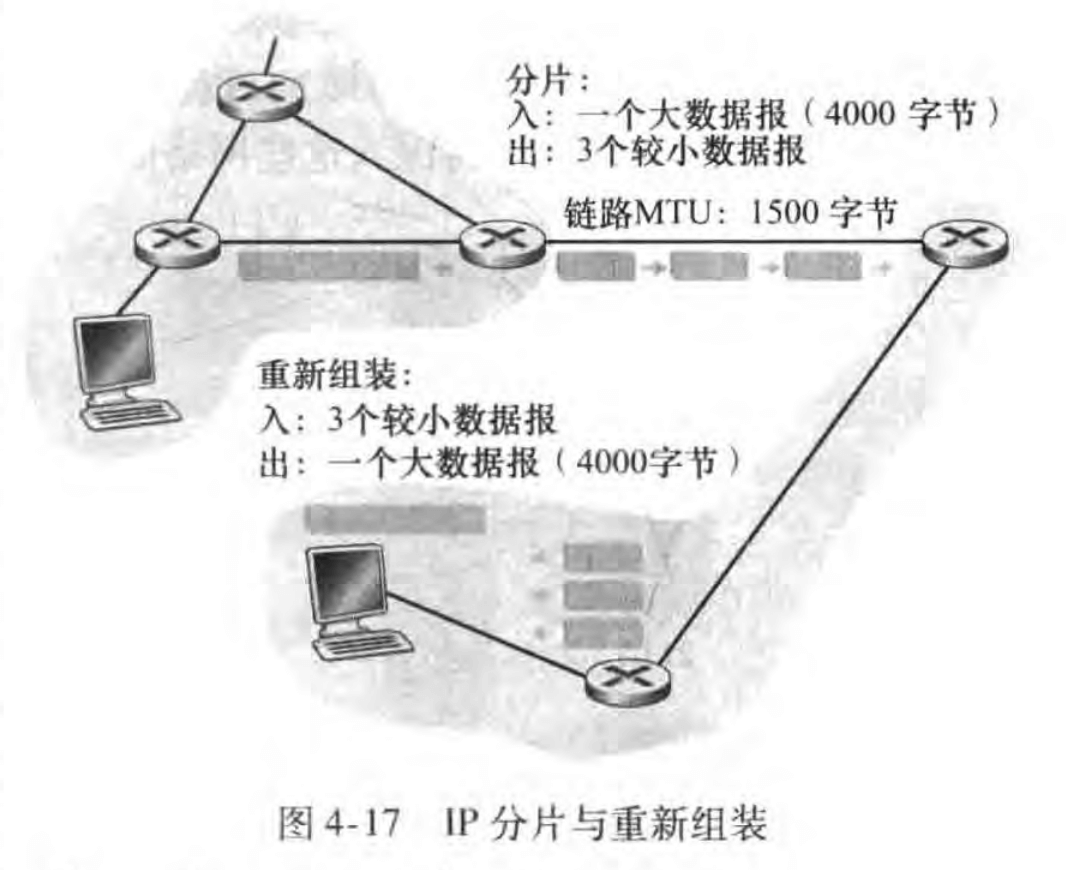
为了让目的端能够准确重构原始数据报,分片机制依赖首部中的三个字段协同工作:
- 标识号(Identification):同一原始数据报的所有分片共享完全相同的标识号,目的主机依据
(源 IP, 标识号)聚合归并属于同一数据报的各个分片; - 片偏移(Fragment Offset):以 8 字节(64 比特)为步进单位,指示该分片的数据载荷在原始 IP 数据报有效载荷中的相对起始位置;
- 标志(Flags):其中的“更多片”(More Fragments, MF)比特充当边界指示符。当 MF 为 1 时表示后面还有后续分片;当 MF 为 0 且片偏移大于 0 时,明确标示这是原始数据报的最后一个分片。
例如上图所示,一个总长 4000 字节(包含 20 字节首部与 3980 字节数据)的大数据报到达路由器,需转发至 MTU = 1500 字节的链路上。数据部分必须被切割为三个独立分片:前两个分片各自携带 1480 字节数据(加上 20 字节首部恰好等于 1500 字节),片偏移分别标记为 0 和 (MF=1);第三个分片携带剩余的 1020 字节数据(总长 1040 字节),片偏移标记为 (MF=0)。
IPv4 编址与子网划分
在网络层视角中,IP 地址并非直接分配给整台计算机,而是与 主机或路由器的物理网络接口(Interface) 相绑定。由于路由器需要在多条链路之间搬运数据,一台路由器必然拥有两个或多个物理网络接口,每个接口均分配有独立的 IP 地址。
标准 IPv4 地址长度为 32 比特,工程中通常采用 点分十进制记法(Dotted-Decimal Notation) 书写(例如 223.1.1.1)。除了位于 NAT 之后的专用私网接口外,全球因特网中每台设备直连公网的接口都必须拥有全局唯一的 IP 地址。
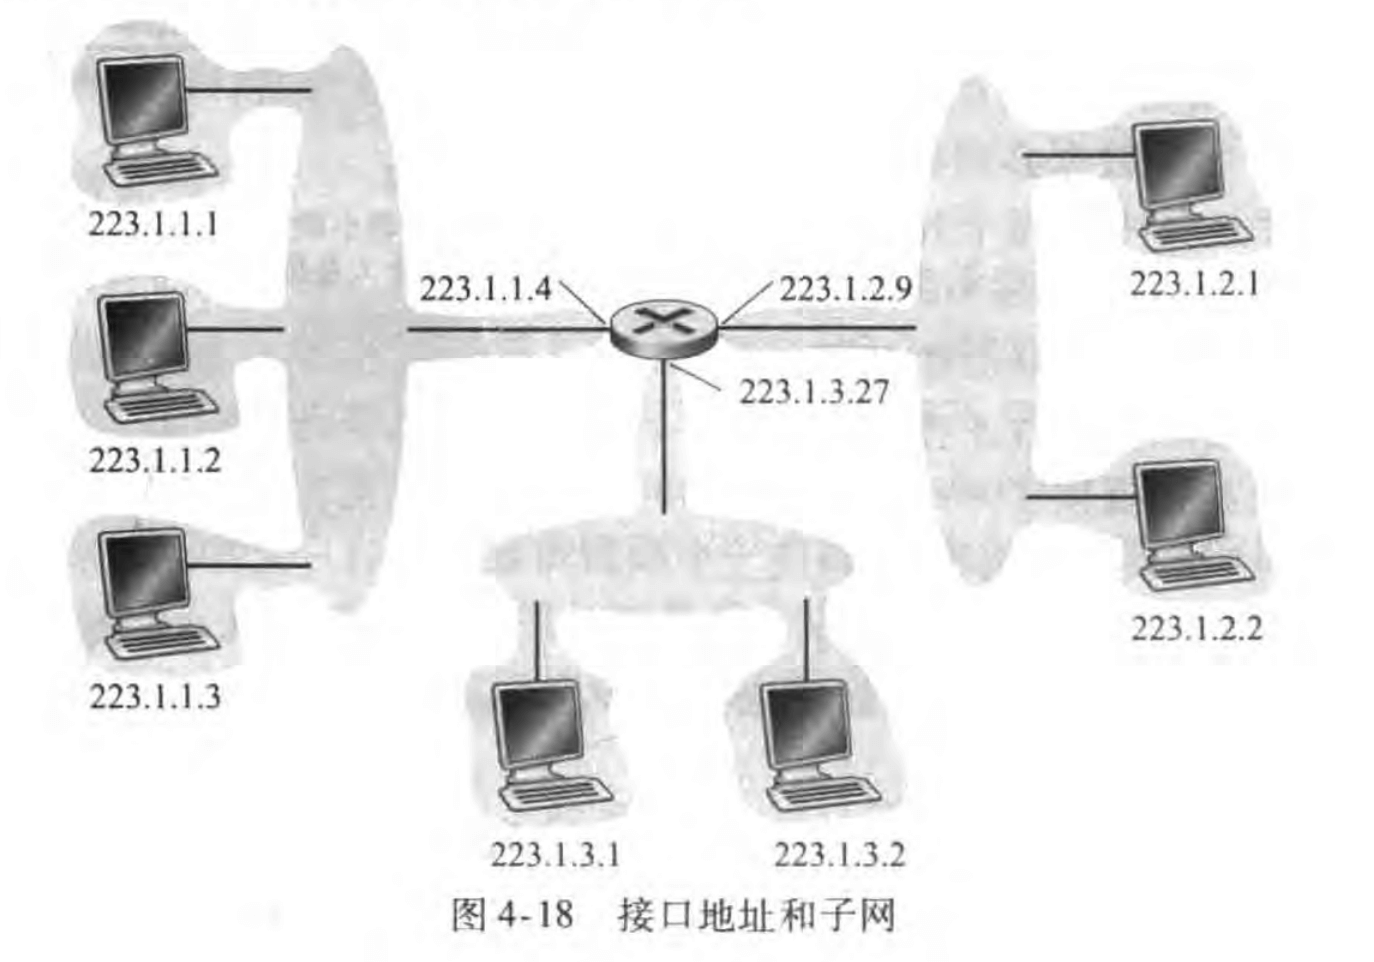
将多台主机接口与路由器接口通过以太网交换机或无线接入点(AP)互联在一起,构成了一个逻辑子网(Subnet)。在 IP 编址定义中,一个子网内的所有接口在物理上可以直接通信而无需经过中间路由器的介入。例如图中以 223.1.1 开头的接口互联为一个子网,223.1.1.0/24 的左侧 24 比特定义了子网地址,/24 为子网掩码,任何连接到该子网的主机接口都具有 223.1.1.xxx 形式。
划分与识别子网的标准工程方法是:断开主机和路由器的每个网络接口,将拓扑分割为数个彼此隔离的网络孤岛,每一个由接口端接的孤岛就是一个独立的子网。
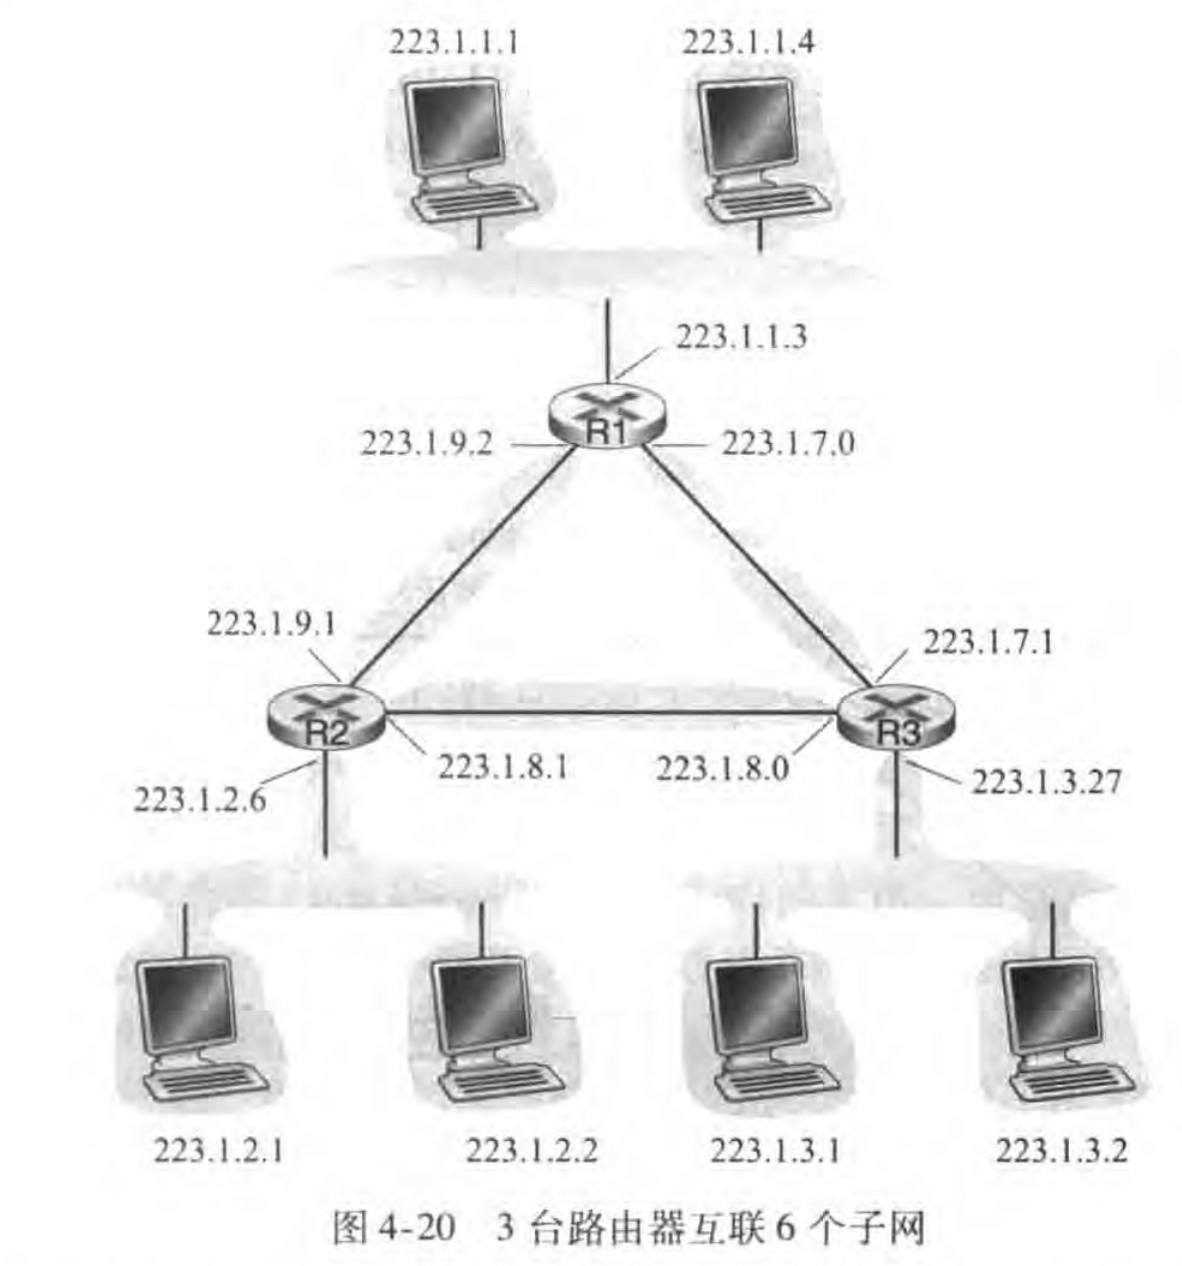
在复杂的拓扑中,不仅主机与路由器相连的局域网是子网,路由器与路由器之间由点对点链路直连的网段同样构成独立子网。例如上图中清晰呈现了 6 个独立子网:三个连接终端主机的局域网子网(223.1.1.0/24、223.1.2.0/24、223.1.3.0/24)以及三个串接路由器的点对点链路子网(223.1.7.0/24、223.1.8.0/24、223.1.9.0/24)。
无类别域间路由选择(CIDR)与路由聚合
因特网全面采用 无类别域间路由选择(Classless Interdomain Routing, CIDR) 规范。CIDR 采用 a.b.c.d/x 的形式,其中最高 比特构成了 IP 地址的网络部分,通常被称为网络前缀(Prefix),后 比特用于区分该组织内部设备,该组织的内部结构可以采用同样的方式继续划分子网。
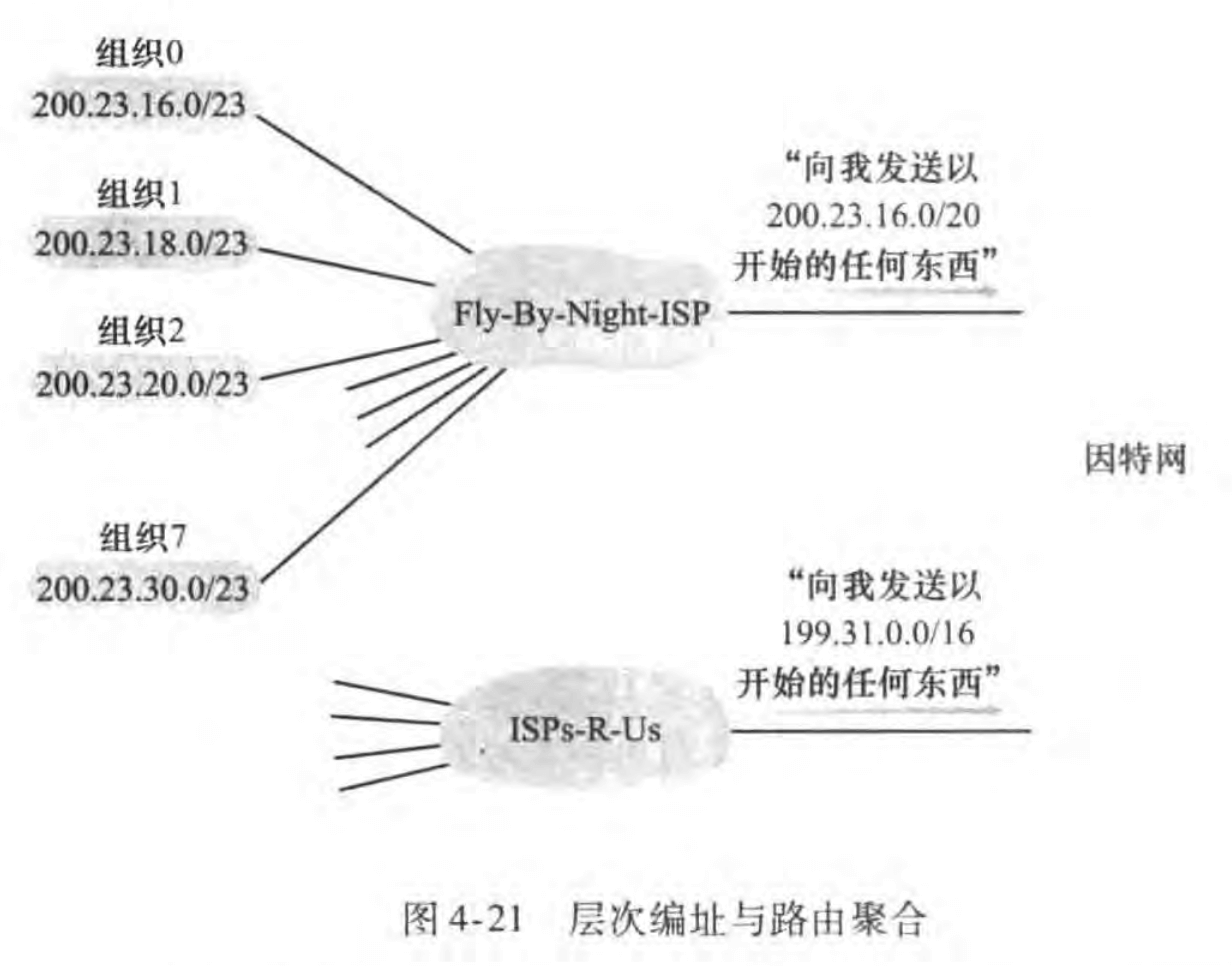
CIDR 的核心价值在于实现了地址聚合(Address Aggregation,又称路由聚合 Route Aggregation 或路由摘要 Route Summarization):上游 ISP 可以使用单个网络前缀通告成百上千个内部细分网络,极大压缩了全网核心路由表的体积。
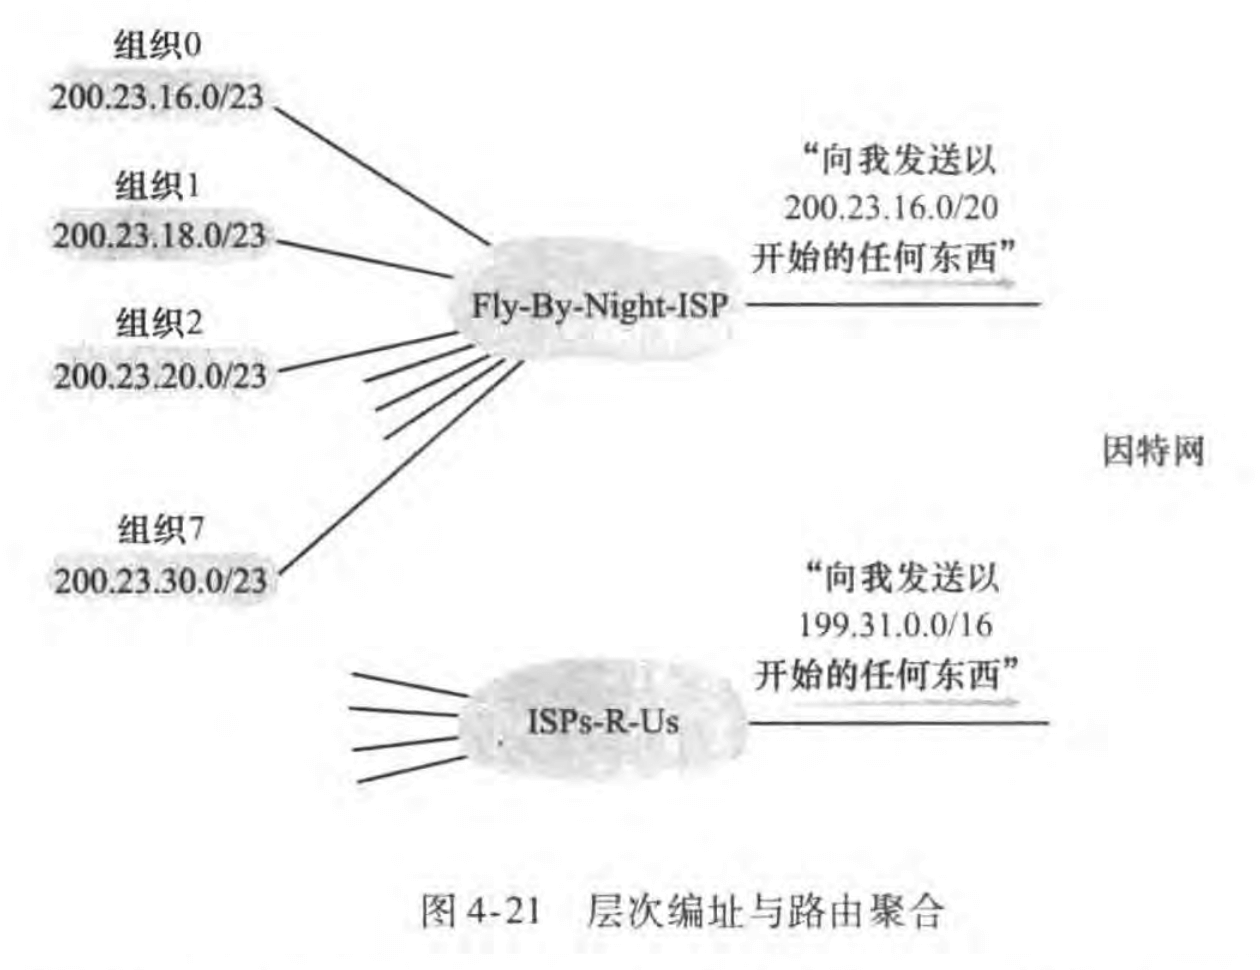
当发生跨 ISP 变更时,CIDR 与最长前缀匹配规则天然兼容。例如当组织 1(拥有 200.23.18.0/23)转投换用 ISPs-R-Us 的服务时,原服务商 Fly-By-Night-ISP 继续通告原来的地址块 200.23.16.0/20,而新服务商 ISPs-R-Us 增加通告 200.23.18.0/23。全网路由器在看见 200.23.16.0/20 和 200.23.18.0/23 时,根据最长前缀匹配规则,发往组织 1 的流量将毫无歧义地精准路由向 ISPs-R-Us。
在 CIDR 诞生前,因特网曾采用传统的分类编址(Classful Addressing):具有 8、16 或 24 比特子网地址的子网分别被称为 A、B 和 C 类网络,分别可容纳约 16777214、65534 和 254(除去两个预留地址)台设备。分类编址造成了极大的地址空间碎片化与严重浪费。
此外,当主机向特殊的目的地址 255.255.255.255 发送数据报时,该报文为IP 广播数据报,报文会交付给同一个网络中的所有主机,路由器也会有选择地向邻近的子网转发该报文。
获取一块地址与 ICANN
全球 IP 地址空间由 因特网名字和编号分配机构(ICANN) 统筹管理。ICANN 向区域性因特网注册机构(RIR,如 ARIN、RIPE NCC、APNIC 等)分配大块地址,再由各机构逐级细化分配给各国的国家级机构及本地 ISP。此外,ICANN 还负责管理 DNS 根服务器体系,同时负责分配域名和解决域名纠纷。
动态主机配置协议(DHCP)
主机接入网络时,除了可以手动配置 IP 地址外,普遍使用动态主机配置协议(Dynamic Host Configuration, DHCP) [@DynamicHostConfiguration2023]。
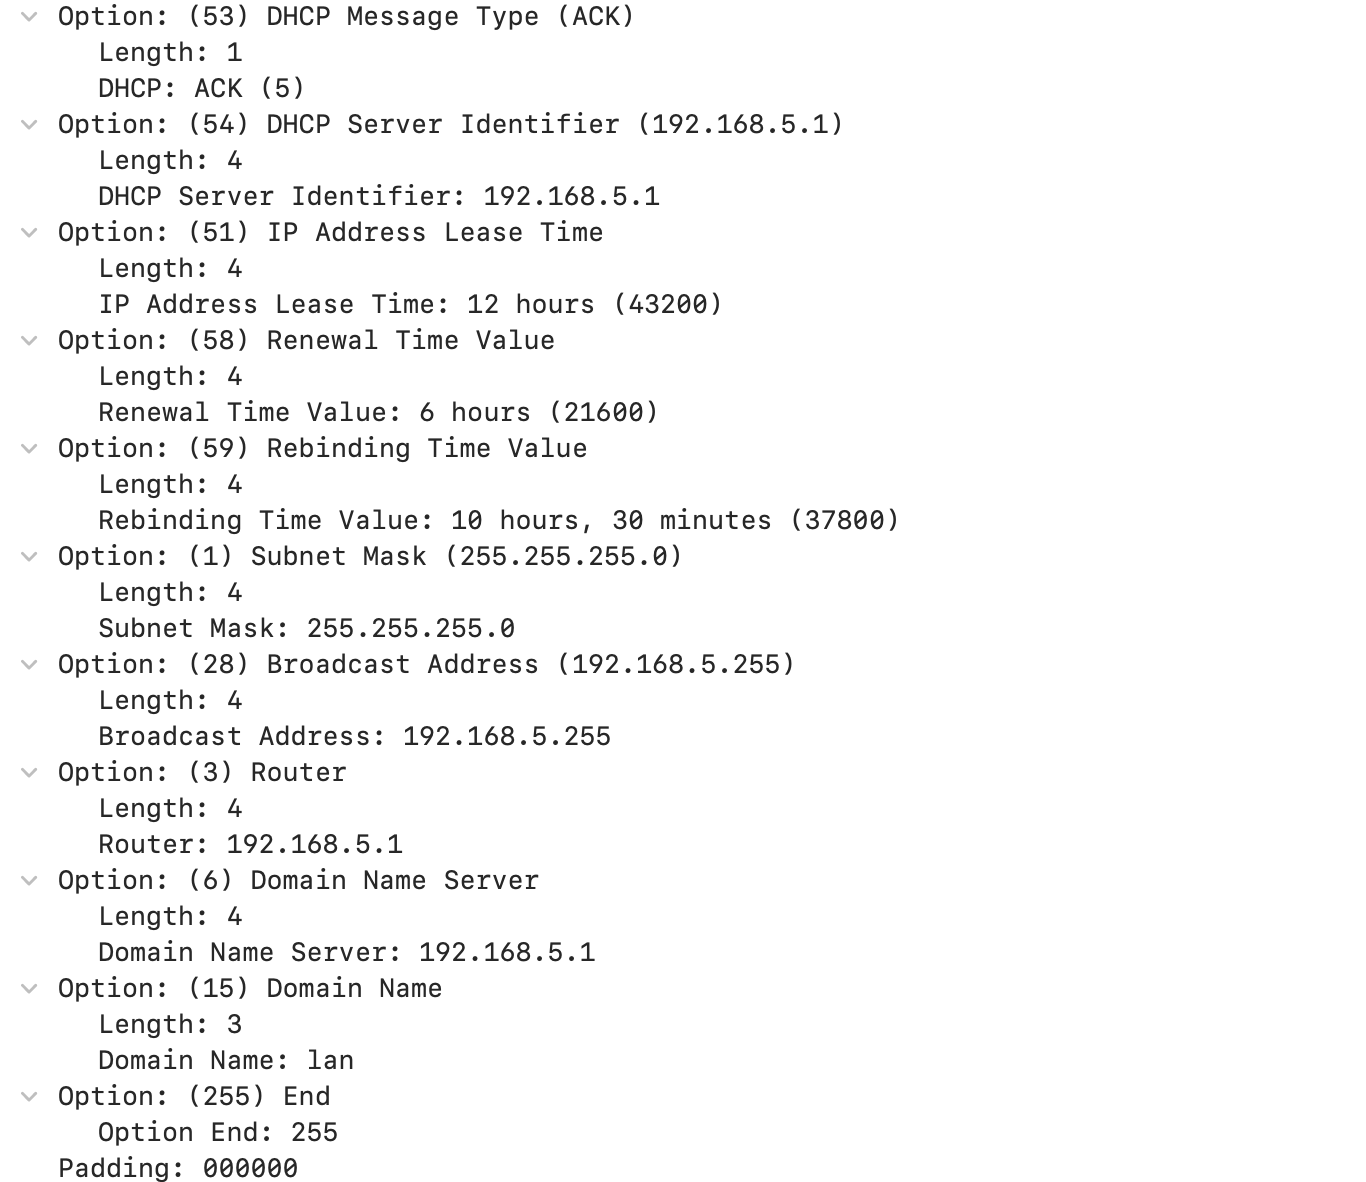
DHCP 又被称为即插即用协议(Plug-and-Play Protocol)或零配置协议(Zeroconf)。它允许主机自动获取一个 IP 地址,网络管理员能配置 DHCP 以使主机每次与网络连接时能得到一个相同的 IP 地址,或者分配一个临时的 IP 地址(Temporary IP Address)。此外,DHCP 还允许主机获知子网掩码、第一跳默认网关地址以及本地 DNS 服务器地址。
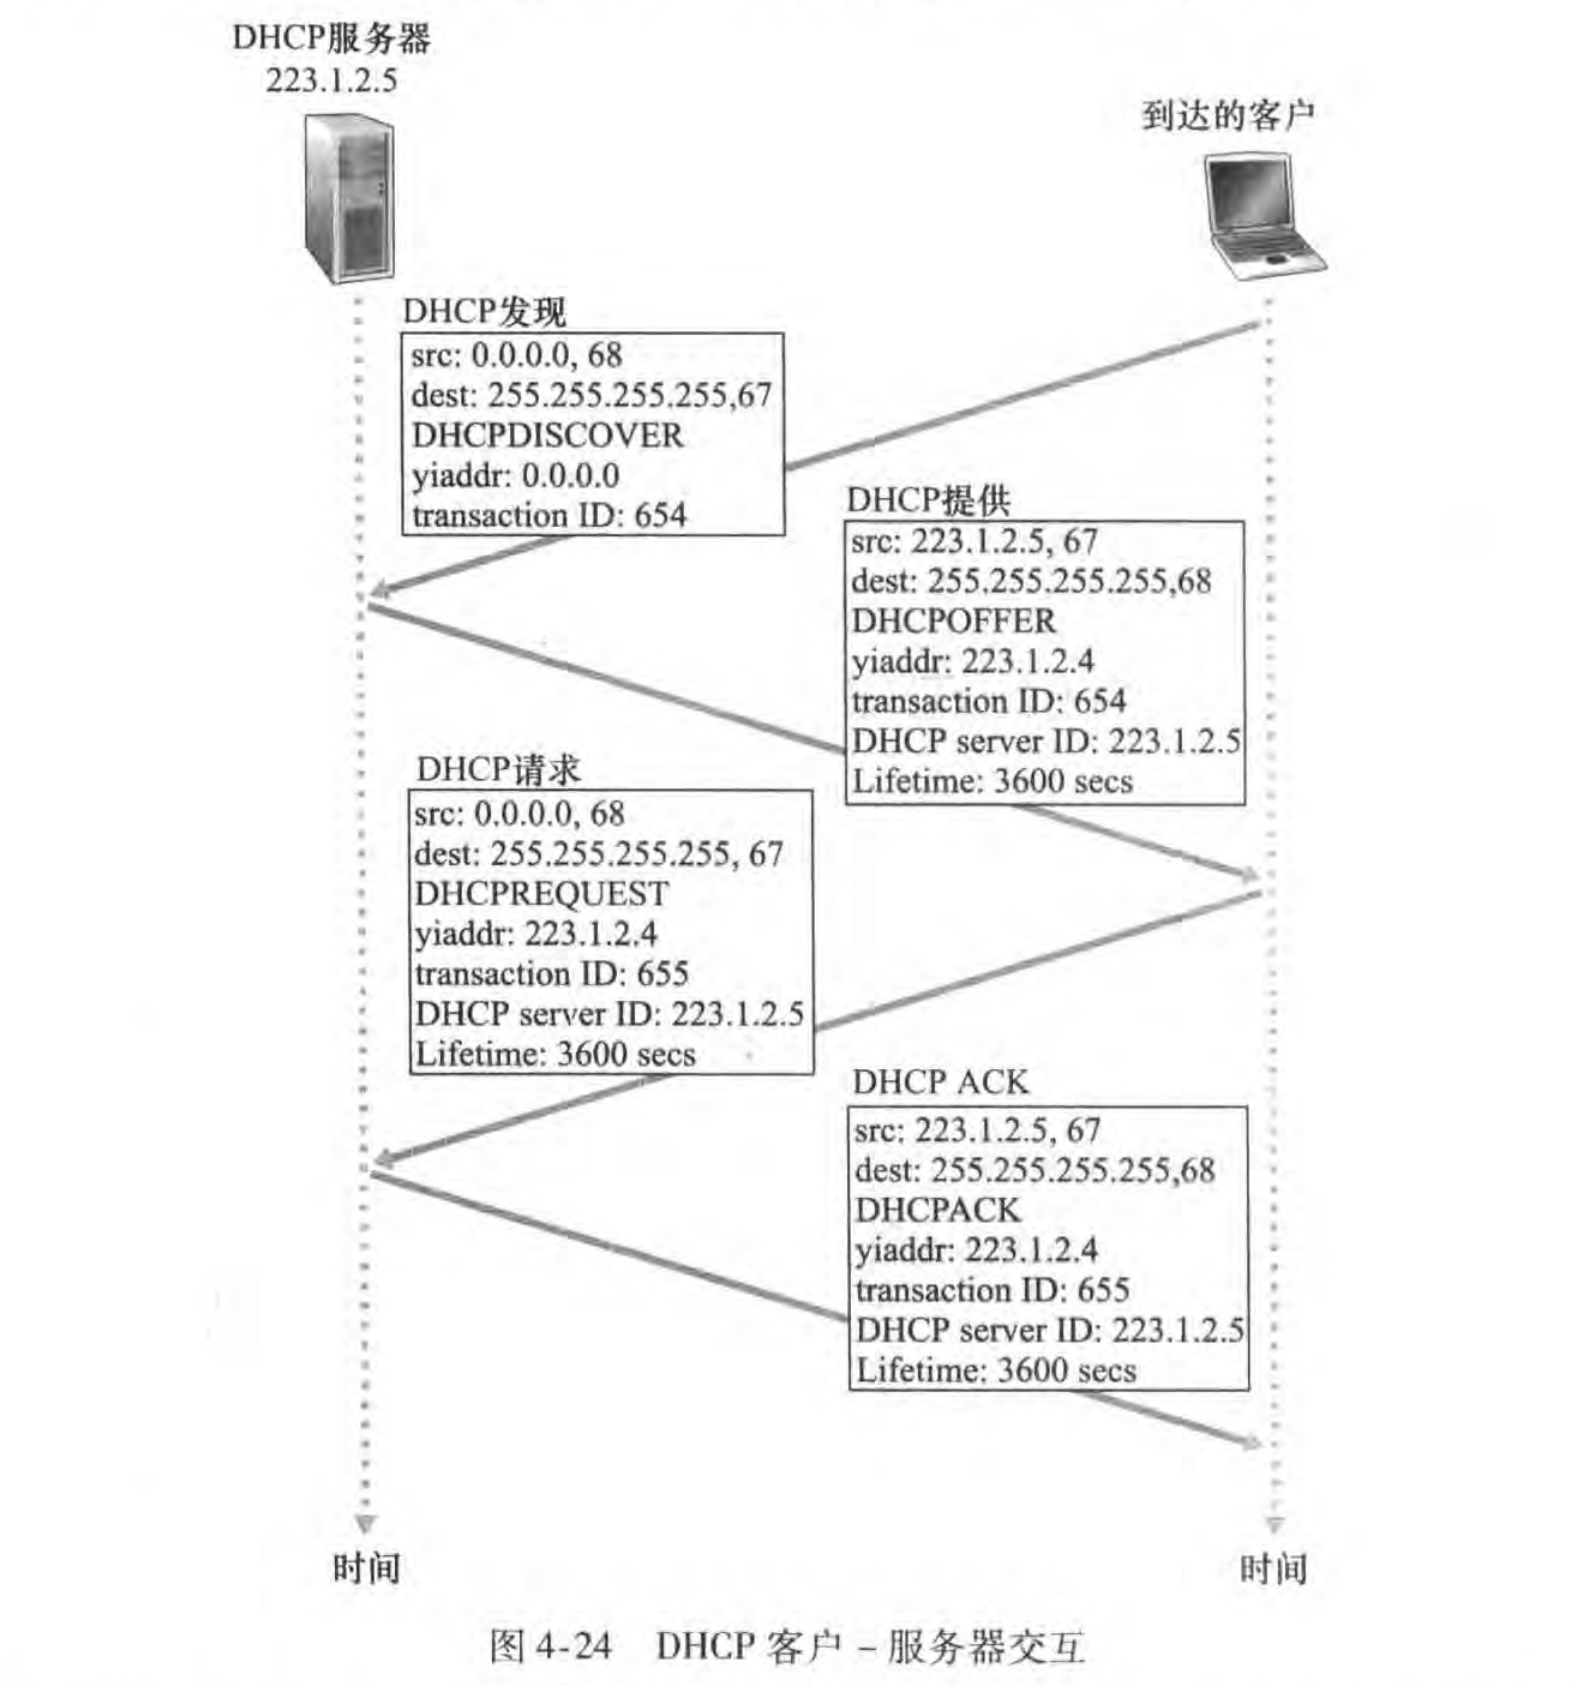
完整的 DHCP 交互遵循经典的 DORA 四步过程:
-
DHCP 服务器发现(DHCP Discover):新接入的主机使用 DHCP 发现报文,通过向本地子网广播封装了 UDP 分组(端口 67)的 IP 数据报(源 IP 为
0.0.0.0本机,目的 IP 为255.255.255.255全网广播地址),让子网内的 DHCP 服务器接收到报文; -
DHCP 服务器提供(DHCP Offer):服务器用 DHCP 提供报文做出响应,该报文仍然使用 IP 广播地址
255.255.255.255,提供报文中包含推荐的 IP 地址、网络掩码以及 IP 地址租用期(Address Lease Time);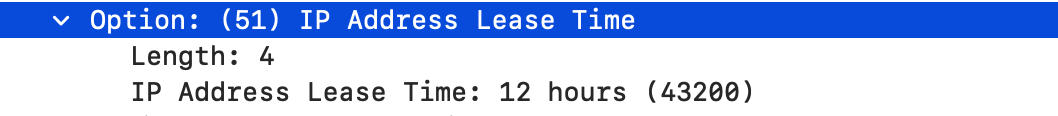
-
DHCP 请求(DHCP Request):客户机可能收到一个或多个服务器的提供报文,它从中选择一个,并向选中的服务器发送 DHCP 请求报文,回显所选定的配置参数;
-
DHCP ACK:服务器用 DHCP ACK 报文对 DHCP 请求报文进行响应,正式确认配置生效。
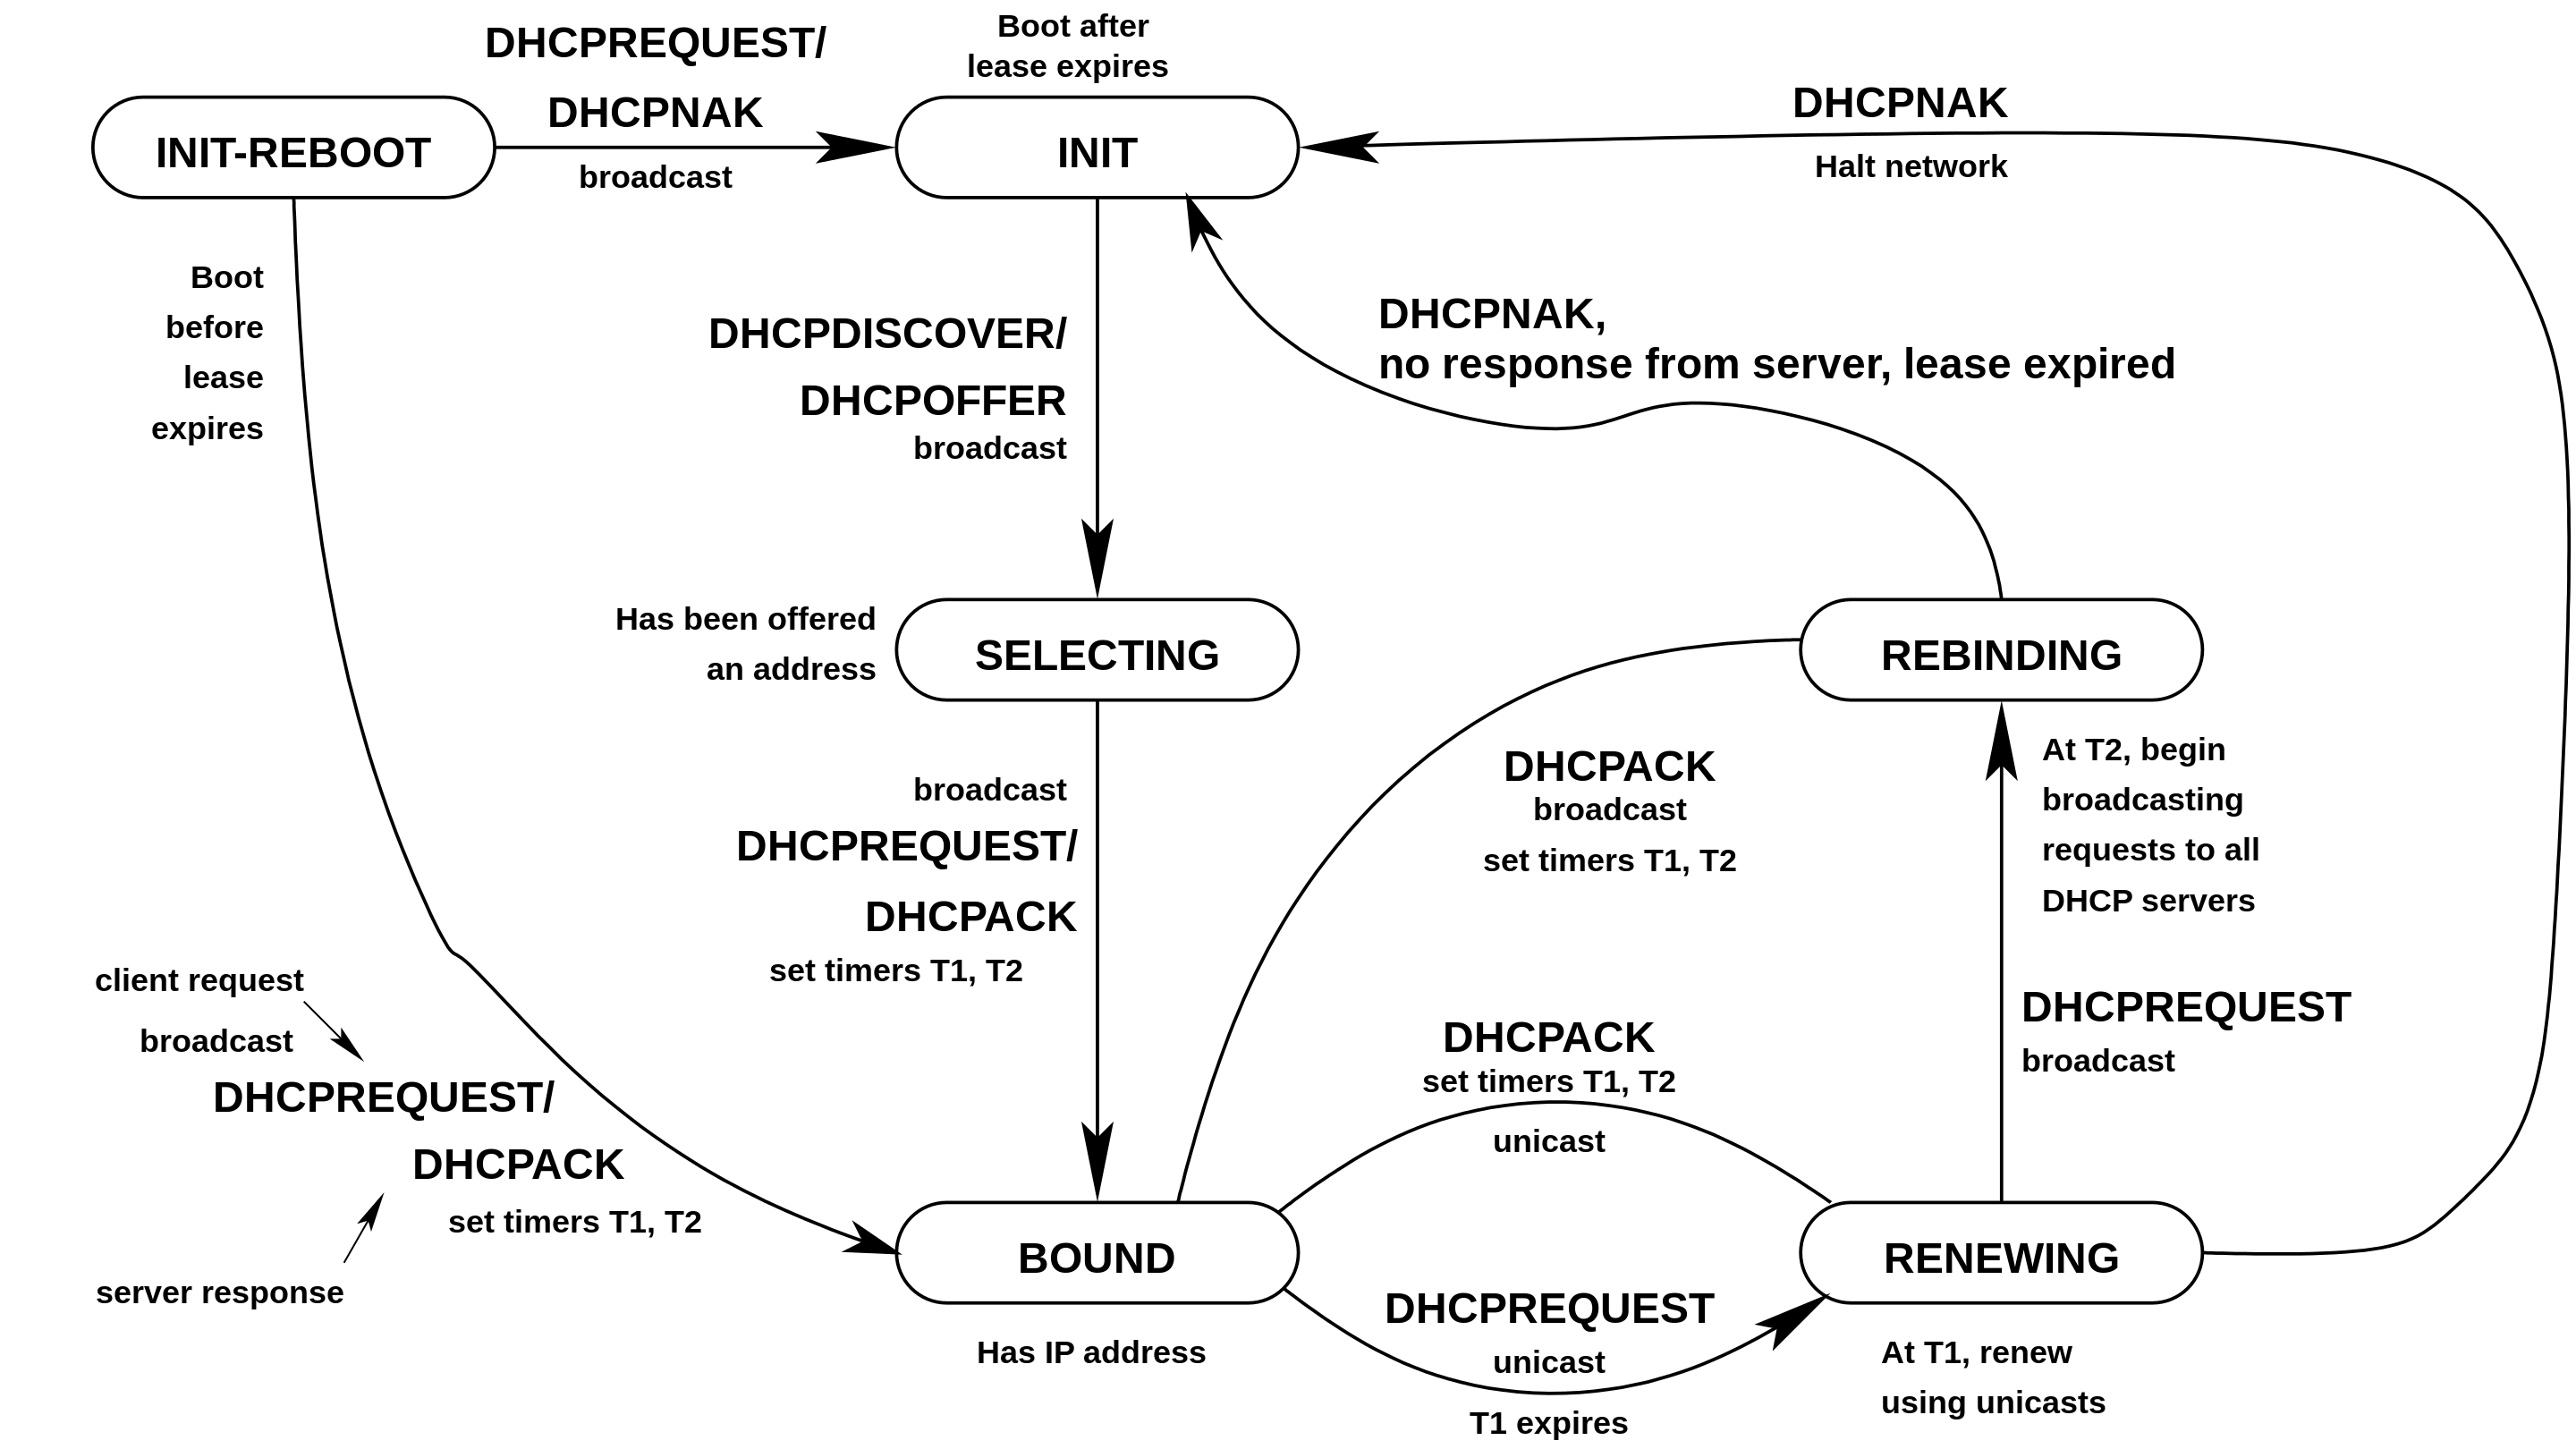
客户端依据上述状态转移图维持租约生命周期。DHCP 客户端的一个主要技术局限在于移动性场景:当移动节点在不同子网之间移动时,由于必须更换子网 IP,无法维持与远程应用程序之间的已有 TCP 连接。
网络地址转换(NAT)
随着联网设备爆发式增长,IPv4 公网地址严重不够分配。网络地址转换(Network Address Translation, NAT) 通常用于家庭和小型办公室(SOHO, Small Office, Home Office)中设备过多、IP 地址不足的情况。
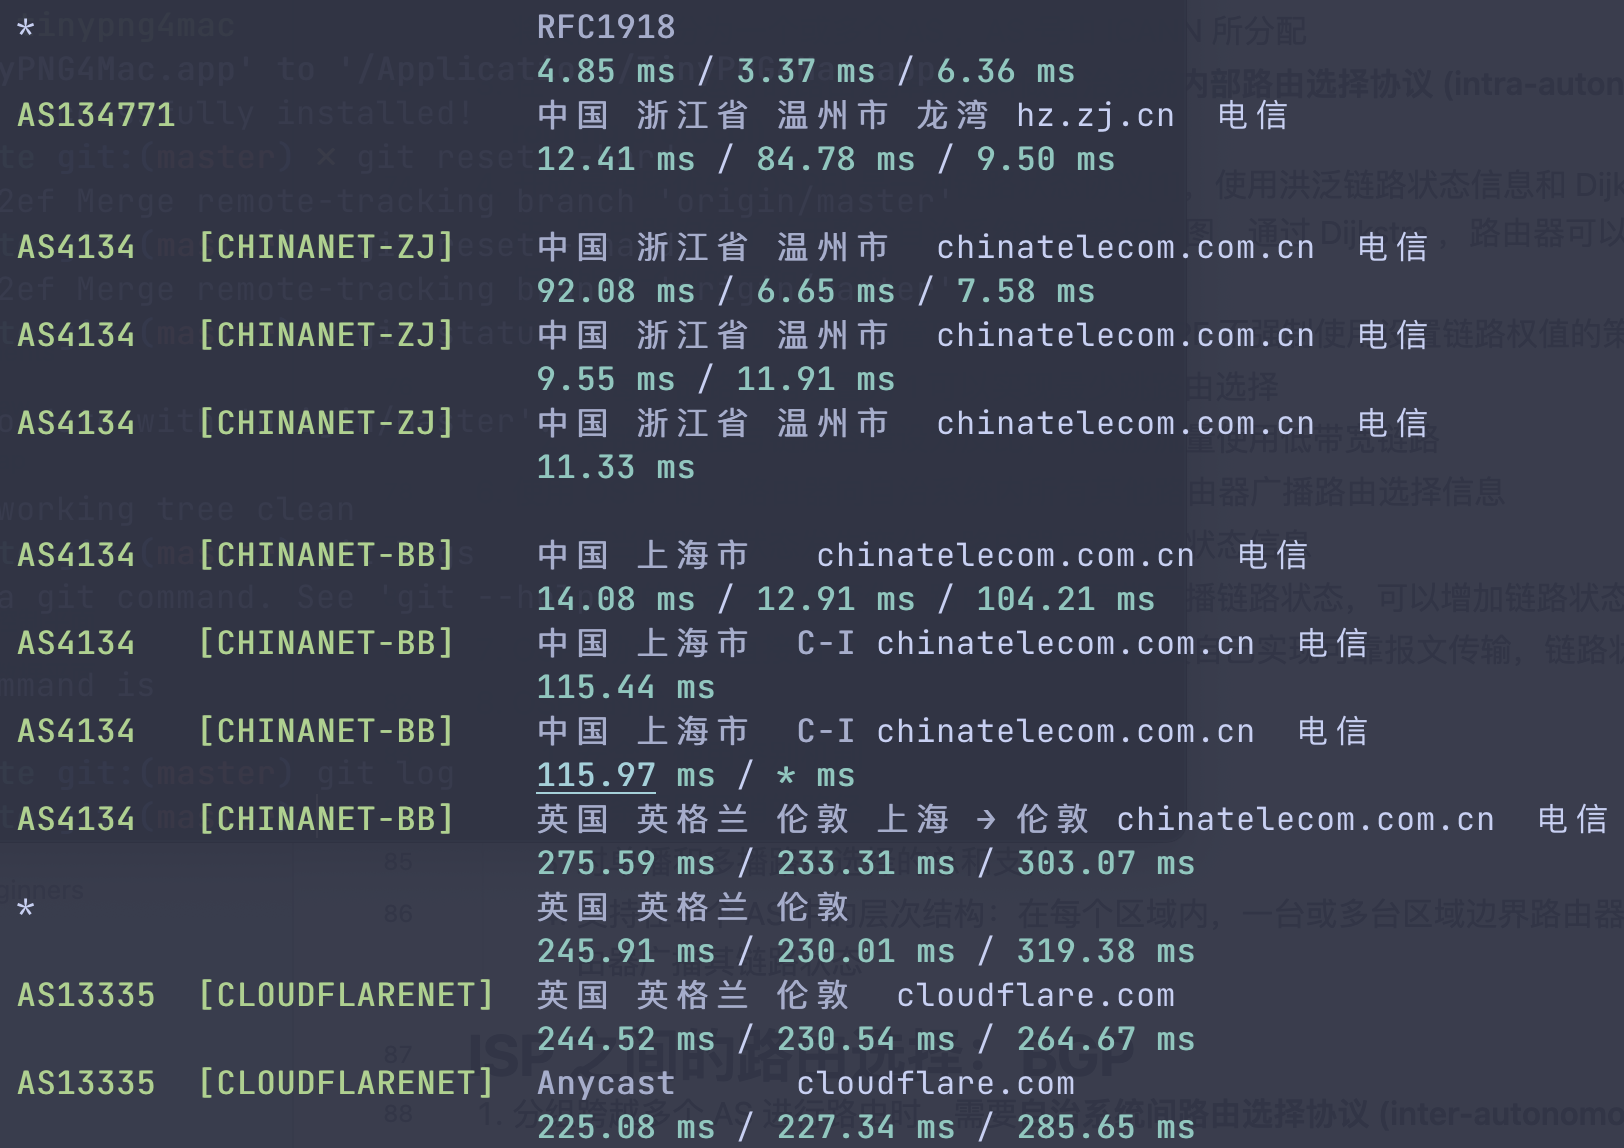
RFC 1918 [@moskowitzAddressAllocationPrivate1996] 专门保留了三段 IP 地址块,用于专用网络(Private Network)和具有专用地址的地域(Realm with Private Address):
10.0.0.0/8172.16.0.0/12192.168.0.0/16
具有专用地址的地域是指其地址仅对该内部网络中的设备有意义的网络。家庭网络中的计算机通常从本地 DHCP 服务器获取私网 IP 地址,所有进出外部公网的数据报均由边界上的 NAT 路由器集中转换。
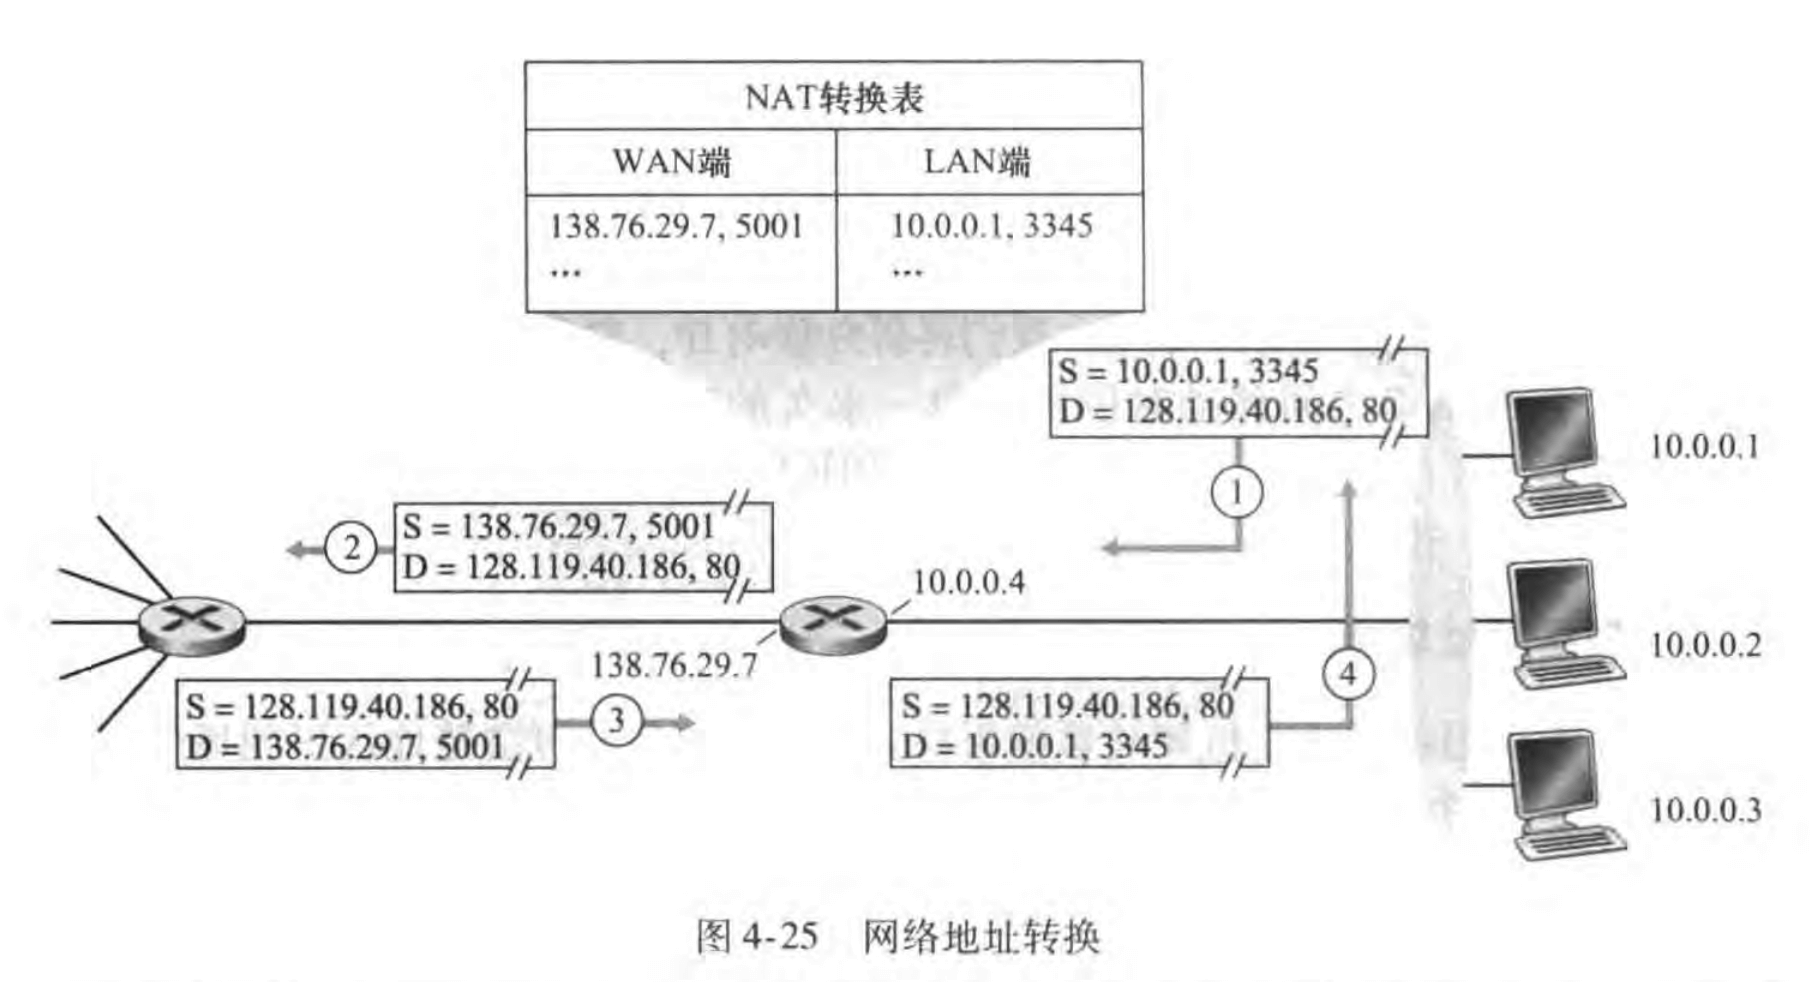
NAT 路由器在内核中维护一张 NAT 转换表(NAT Translation Table)。当内部主机向外发起连接时,NAT 路由器将该 IP 数据报的源 IP 替换为其对外的单个公网 IP 地址,并在空闲端口池中动态指派一个任意当前未在表中占用的源端口号,随后在 NAT 转换表中增加一个映射表项。当外部服务器的回包到达时,NAT 路由器依据数据报中的目的端口反向查表,还原出内网主机的真实私网 IP 与端口并进行转发。
NAT 的使用对于运行在家庭网络内部的服务器(如 P2P 对等方通信)会引起连接建立障碍,工程上的解决方案包括 NAT 穿越(NAT Traversal)和通用即插即用(Universal Plug and Play, UPnP [@UniversalPlugPlay2023])。
IPv6
为了彻底解决 IPv4 地址耗尽危机并优化路由器处理性能,IETF 设计了拥有 128 位编址空间的 IPv6 协议。
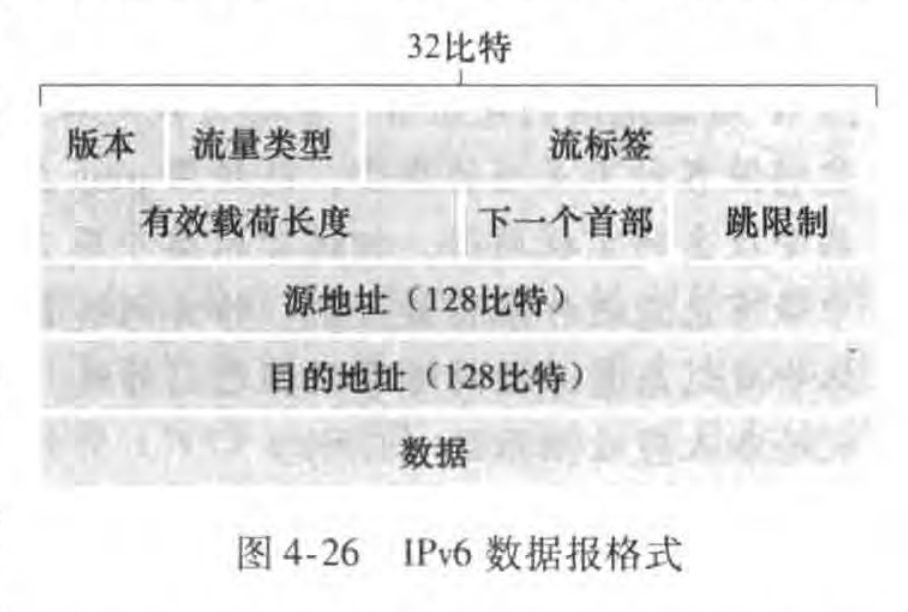
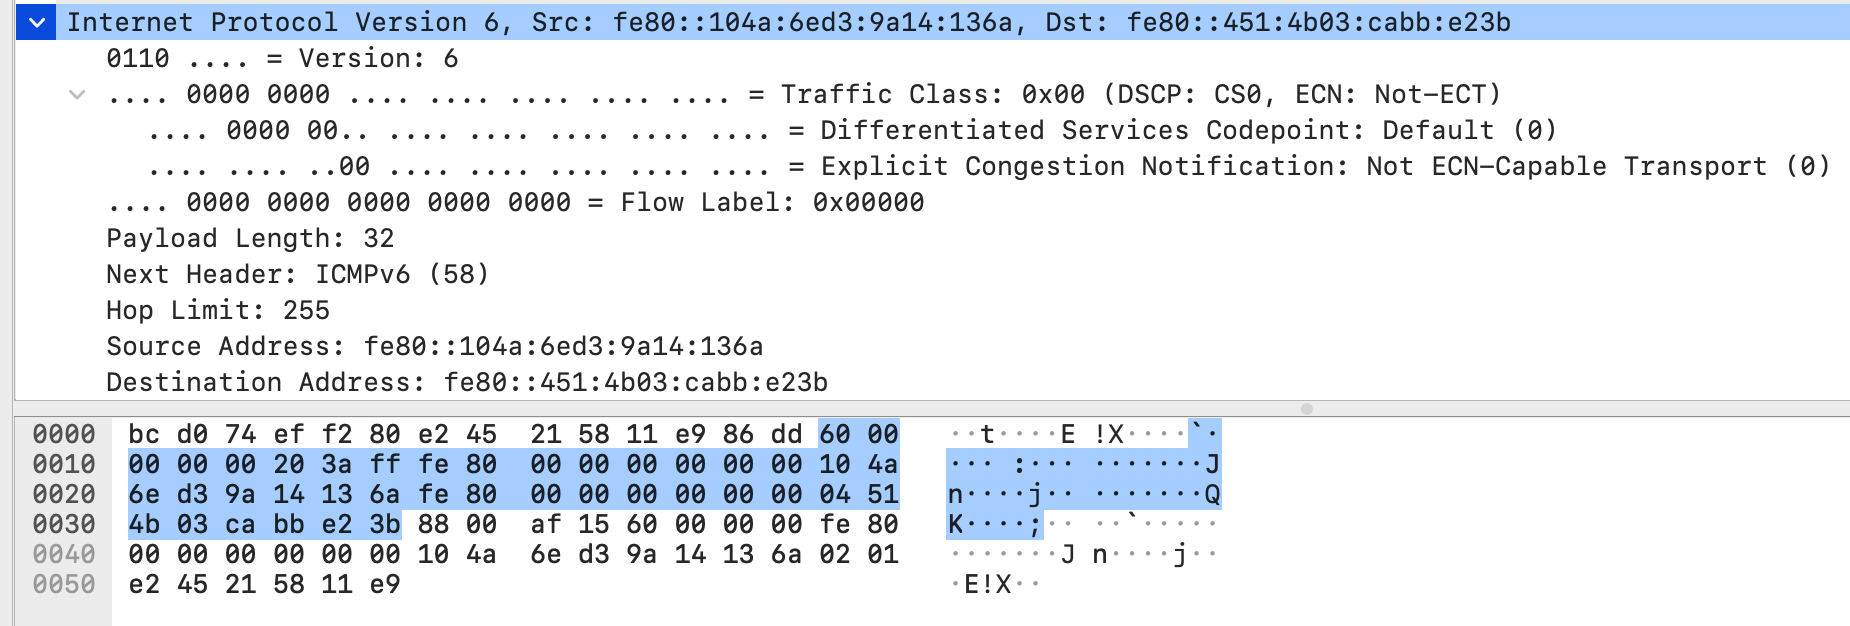
IPv6 采用了固定为 40 字节的基本首部结构:
- 版本(Version,4 比特):用于标识 IP 版本号,固定为
0110(6); - 流量类型(Traffic Class,8 比特):作用类似于 IPv4 中的区分服务(DS/DSCP/ECN);
- 流标签(Flow Label,20 比特):用于标识一条数据报的流,能够对一条流中的某些特定数据报给出优先权保障;
- 有效载荷长度(Payload Length,16 比特):记录跟在 40 字节固定首部之后的数据字段字节数量;
- 下一个首部(Next Header,8 比特):与 IPv4 协议字段 相似,指示有效载荷应交付给哪种运输层协议(如 TCP、UDP)或后续扩展首部;
- 跳限制(Hop Limit,8 比特):转发数据报的每台路由器将该字段减 1,若减至 0 则该数据报必须丢弃;
- 源地址与目的地址(各 128 比特):超大地址空间(格式规范详见 RFC 4291 [@deeringIPVersionAddressing2006]);
- 数据(Data):IPv6 数据报的有效载荷部分。
相较于 IPv4,IPv6 进行了深度精简,彻底移除了以下繁冗字段:
- 分片/重新组装字段:IPv6 不允许在中间路由器上进行任何分片和组装。若数据报尺寸超过下一跳链路 MTU,路由器直接丢弃该数据报并回送一个 ICMP 差错报文,要求源端自行调整分组大小;
- 首部检验和:由于快速线速处理 IP 分组是路由器关注的重点,且运输层和数据链路层均已执行了差错检验,设计者移除了 IP 首部的冗余检验和以减少每跳开销;
- 选项字段:不再出现在固定首部中,而是改为由“下一个首部”指出的位置上以链式扩展首部形式按需提供。
IPv4 到 IPv6 的迁移:建隧道
从 IPv4 向 IPv6 的过渡是一个长期渐进的过程。连接两个孤立 IPv6 网络的经典技术是建隧道(Tunneling)。
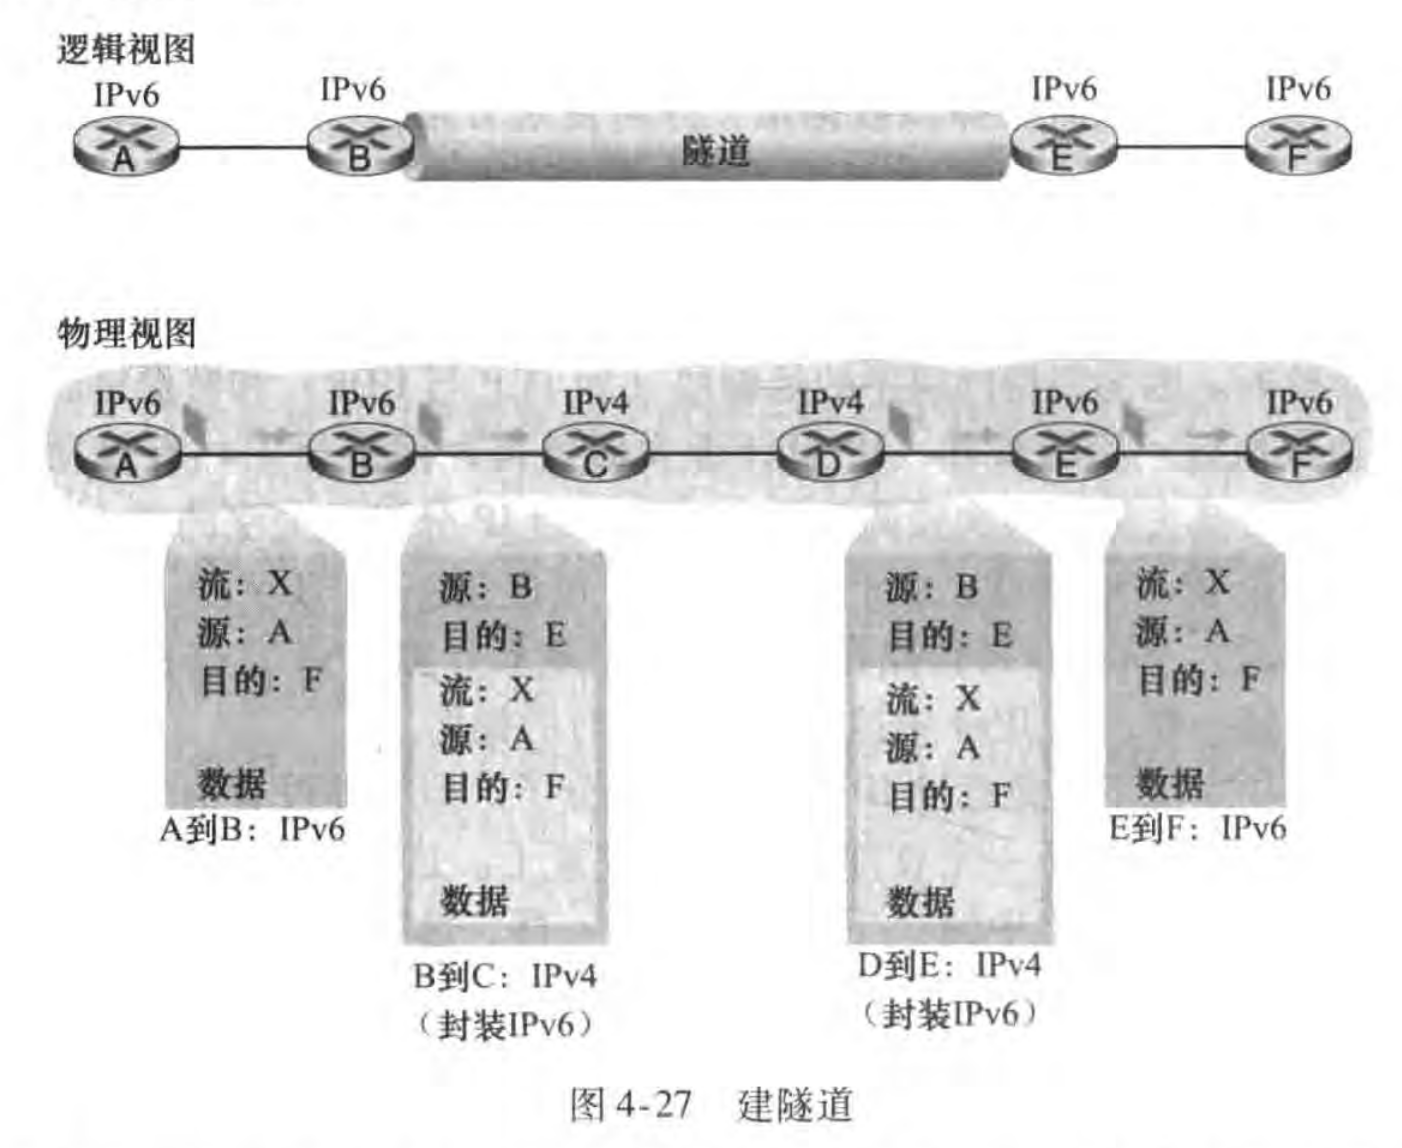
隧道由两台 IPv6 路由器之间的中间 IPv4 路由器集合构成。在隧道发送端,IPv6 节点将整个 IPv6 数据报原样放到一个 IPv4 数据报的数据(有效载荷)字段中;中间的 IPv4 路由器将该数据报作为普通 IPv4 报文进行中继路由;当到达隧道接收端 IPv6 节点时,节点查看协议字段指示其承载的是 IPv6,便从 IPv4 数据报中取出原始 IPv6 数据报,继续在本地 IPv6 网络中正常转发。
通用转发和 SDN
在传统网络中,除了基础的数据报转发外,网络中还部署了大量中间盒(Middlebox)。中间盒是指除常规分组转发之外,用于转换、检查、过滤或篡改网络流量的专用计算机网络设备(例如 NAT 转换器、防火墙、负载均衡器、入侵检测系统 DPI 等)。
传统网络层基于目的地的转发机制非常固定:路由器查找目的 IP 地址( 匹配),并将分组推向特定的物理输出端口( 动作)。
现代网络提出了更为强大的通用“匹配加动作”(Match-plus-Action)范式:不仅局限于第三层,而是能跨越协议栈对多个首部字段进行灵活匹配,并触发多样化的动作集:
- 将分组转发到一个或多个输出端口(像传统基于目的地转发一样);
- 跨越多个通向服务的出口接口实施哈希负载均衡(像负载均衡器一样);
- 重写报文首部字段值(像 NAT 一样);
- 有意识地阻挡或丢弃特定分组(像防火墙一样);
- 为了进一步审计和深度分析,向特定服务器镜像或引流分组(像 DPI 深度报文检测一样)。
通用转发中的匹配加动作表将传统的基于目的地的转发表一般化,既包含了网络层的决策,也覆盖了链路层的转发决策,因此工程中统一使用分组交换机来统称此类 SDN 转发设备。
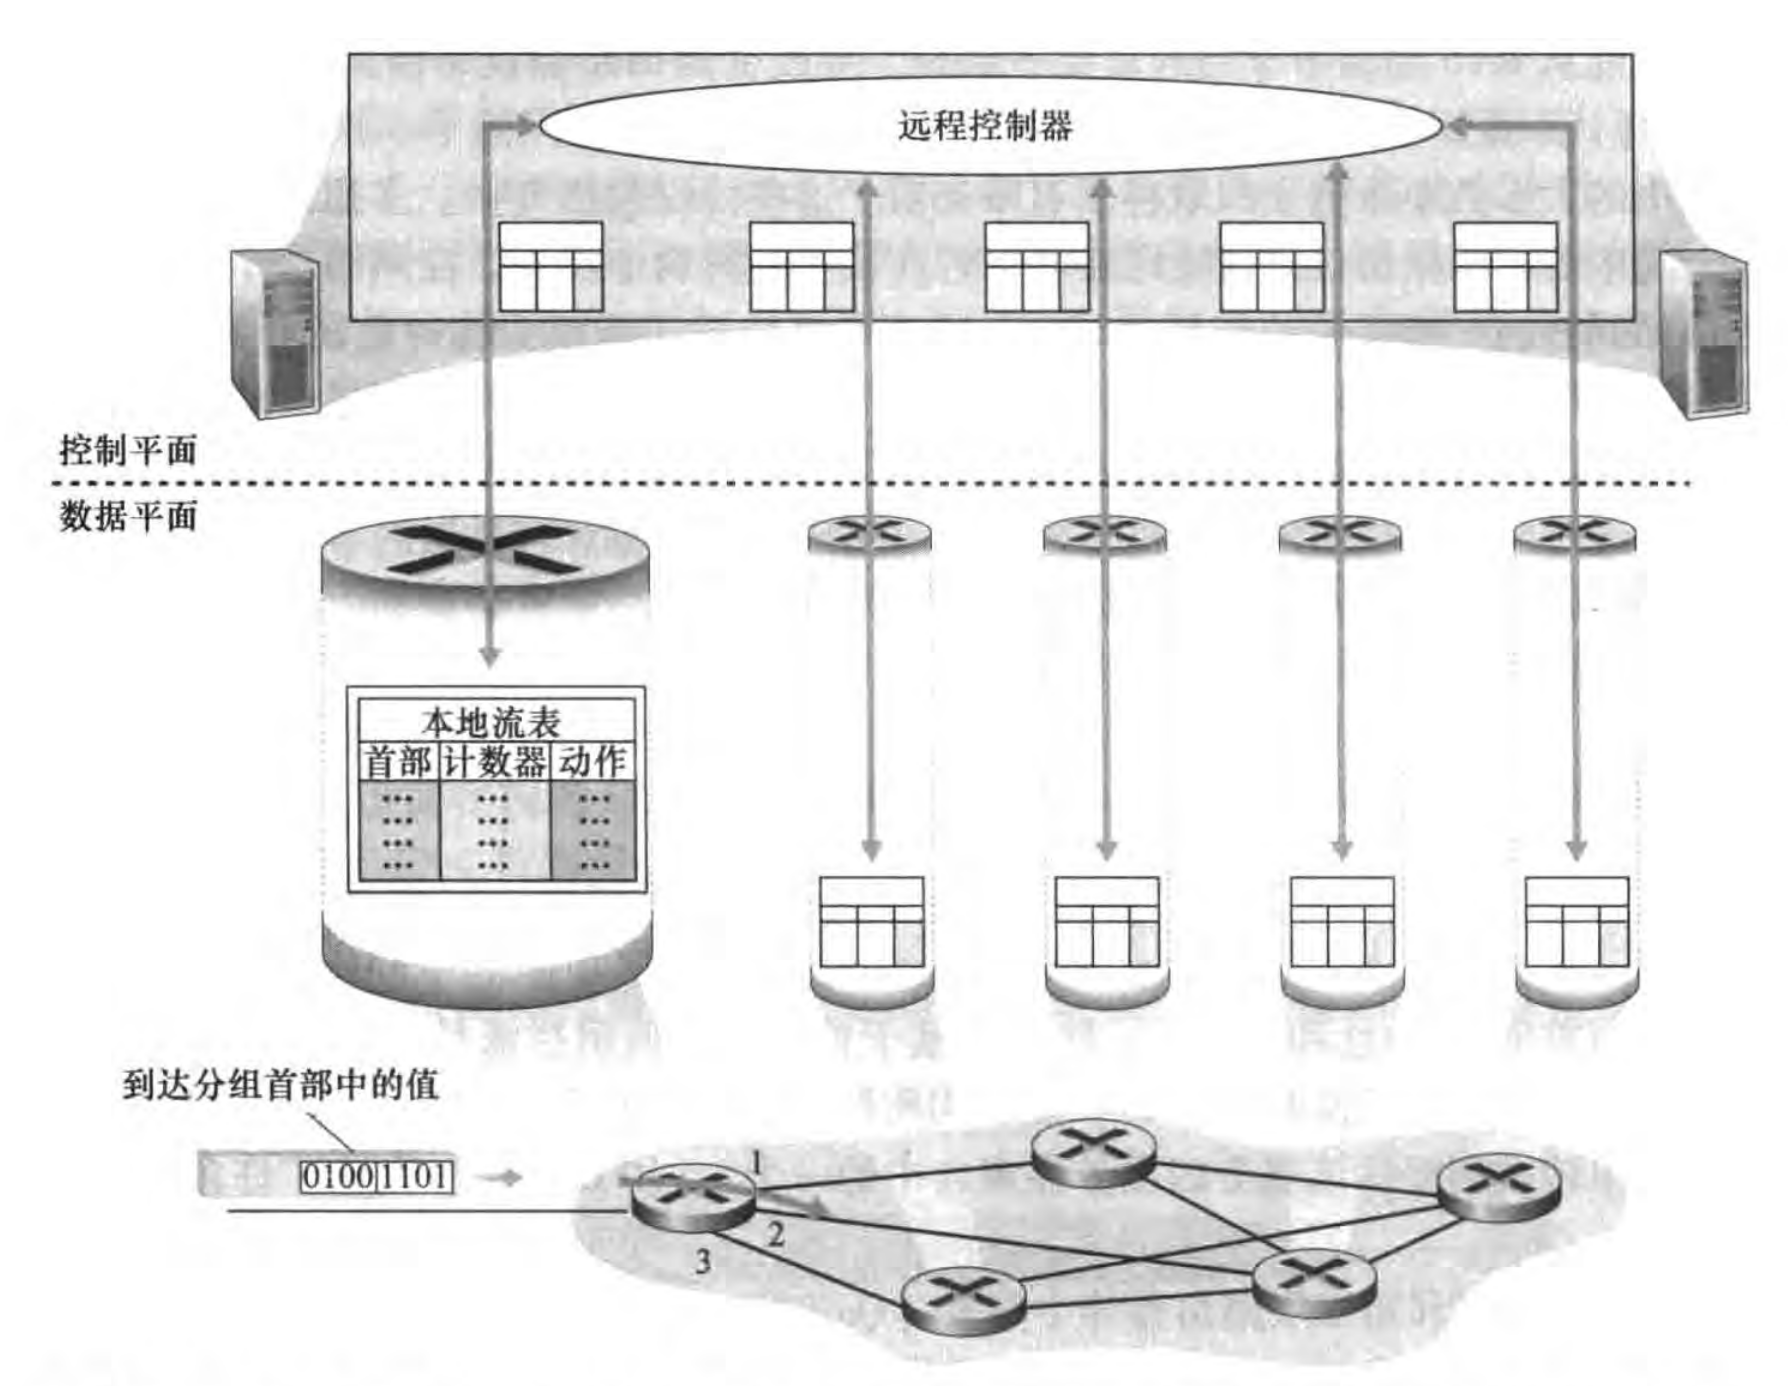
工业界关于通用转发的最关键实践是 OpenFlow 标准(OpenFlow 1.0 引入了核心的 SDN 抽象和功能)。在 OpenFlow 中,匹配加动作转发表被称为流表(Flow Table),每个流表项由三个核心部分构成:
- 首部字段值的集合:基于硬件匹配在 TCAM 内存中执行最迅速;
- 计数器集合:记录命中该规则的分组数量与字节总数,用于计费与流量监控;
- 所采取的动作集合:规则命中时所触发的一系列具体操作。
匹配
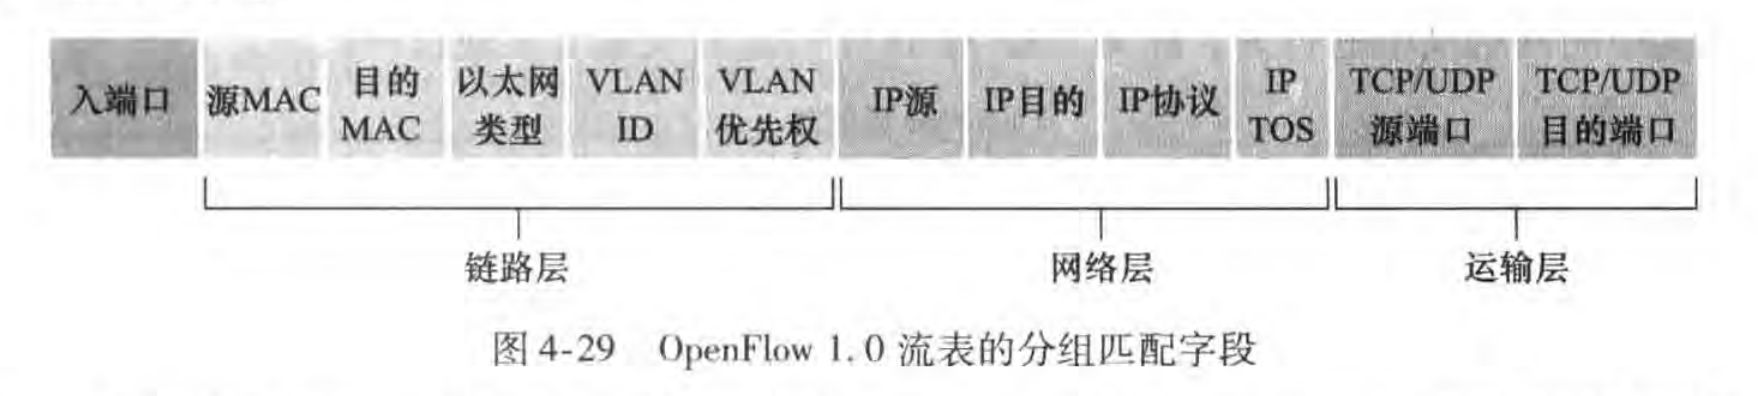
OpenFlow 的流表匹配规则涵盖了多层协议首部字段,包括分组交换机上接收分组的物理入端口(Ingress Port)、以太网 MAC 地址与类型、VLAN 标签、源与目的 IP 地址、IP 协议号与区分服务字段,以及 TCP/UDP 的源与目的端口号。
为了保证硬件线速处理性能,OpenFlow 明确不允许基于 TTL 字段或数据报长度字段进行匹配。这体现了抽象的系统工程艺术:在一个时刻做一件事,并将它做好。一个接口应当俘获一个抽象的最低限度的要件,切勿过度进行通常是错误的一般化。
动作
每个流表项都关联着零个或多个动作指令:
- 转发(Forwarding):一个分组可能被单播、广播或组播到一个或多个物理输出端口;也可以被封装并发送到远程控制器(Packet-In)。控制器可能对该分组采取动作(包括为交换机安装新的流表项),随后可能将分组返还给交换机,以便在更新后的流表规则下继续转发;
- 丢弃(Drop):若一个流表项没有关联任何动作,则表明所有匹配该规则的分组应当被静默丢弃;
- 修改字段(Modify Field):在分组被转发到输出端口之前,除了 IP 协议号本身外,分组首部中的 Layer 2、Layer 3、Layer 4 各字段均可被重新改写。
网络层-控制平面
控制平面不仅控制沿着从源主机到目的主机的端到端路径中路由器如何转发数据报,而且统筹着整个网络层组件与服务的配置和管理。例如 OSPF 是一种运行在单一 ISP 网络内部的路由选择算法,而 BGP 则是因特网中用于互联全球所有网络的跨域路由选择算法。
控制平面架构范式
计算、维护和安装转发表与流表存在两种截然不同的基本体系:
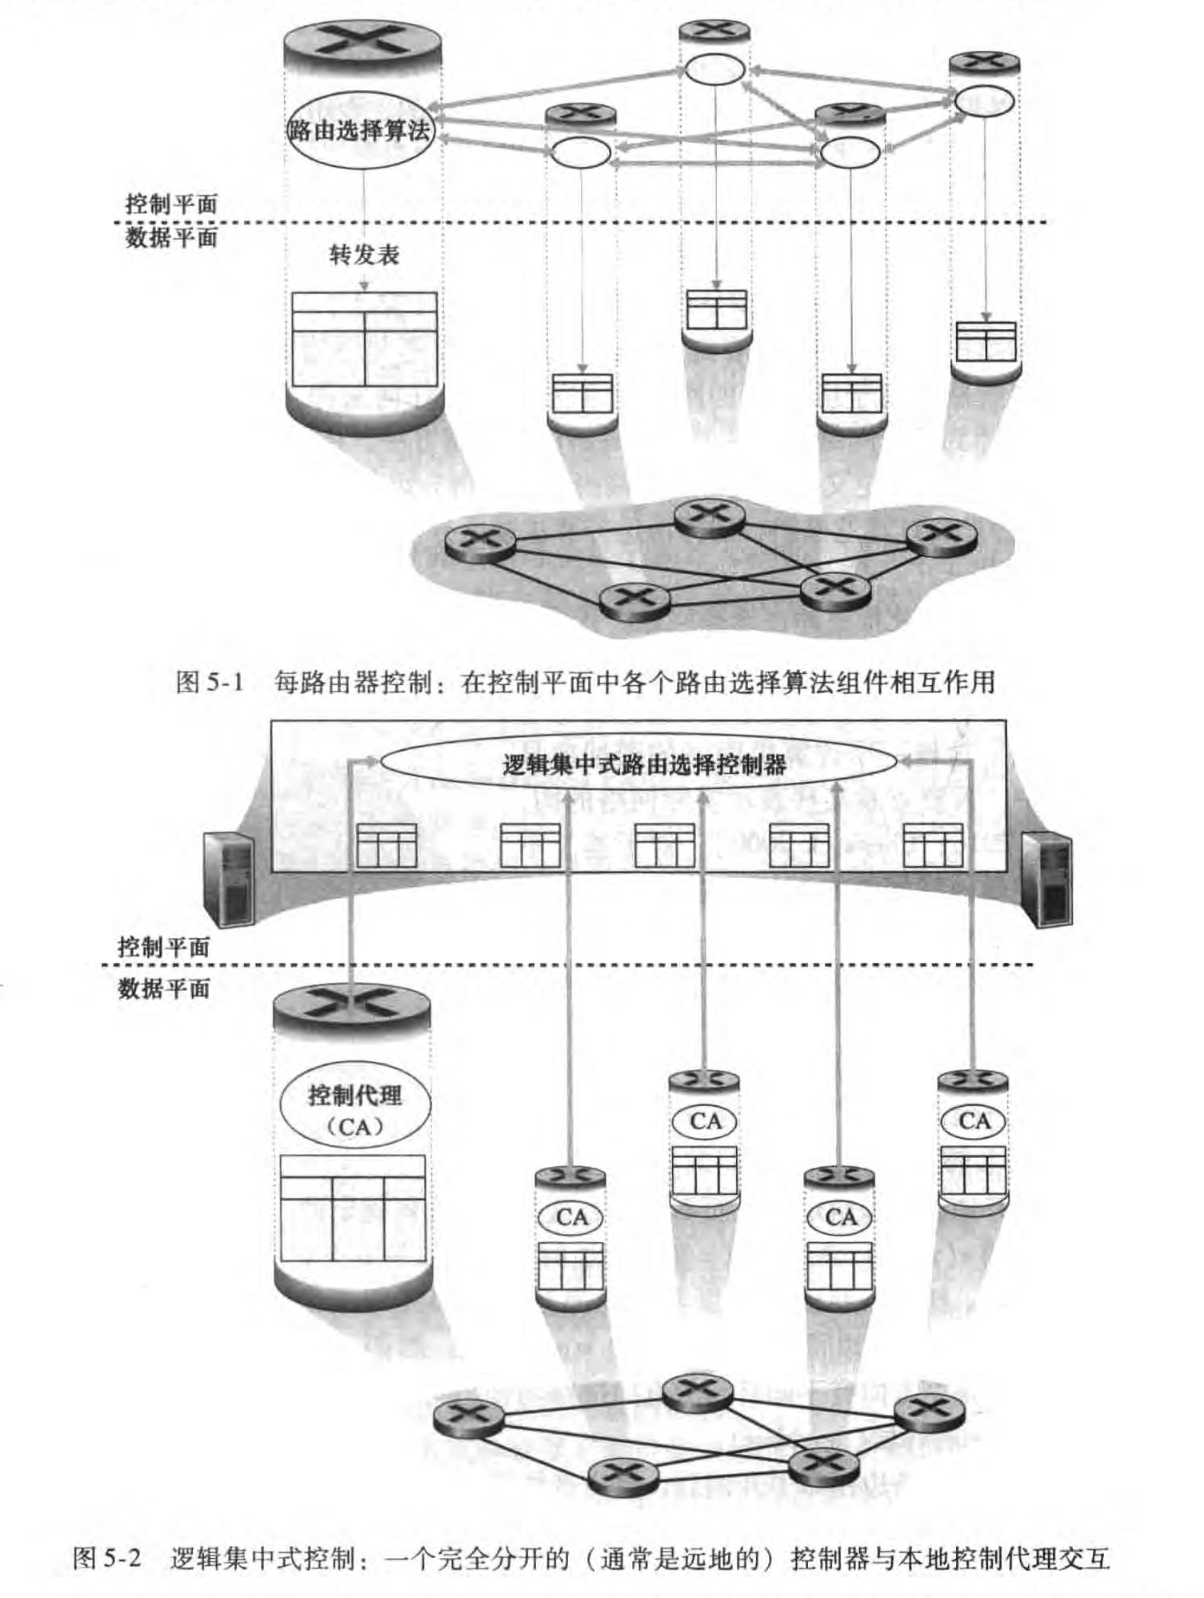
- 每路由器控制(Per-Router Control):每台路由器内部运行独立的路由选择组件,用于与其他路由器中的路由选择组件相互通信,以分布式计算其转发表的值。经典的 OSPF 和 BGP 协议均基于这种方法。
- 逻辑集中式控制(Logically Centralized Control):依托通用转发技术,原本分散在各种独立中间盒与路由器内部的复杂网络控制功能被抽离至逻辑上集中的远程控制器中。出于容错、高可用和性能扩展性的原因,这种集中式控制器通常由高可扩展的分布式服务器集群共同承载。
每路由器控制和逻辑集中式控制之间的关键差异在于:路由器内部的控制组件究竟能否相互交互并主动参与计算转发表,还是仅作为被动受控的执行端。
路由选择算法
路由选择算法(Routing Algorithm)的目的,是在从发送方到接收方的传输过程中,在复杂的路由器网络中确定一条“最优”路径。
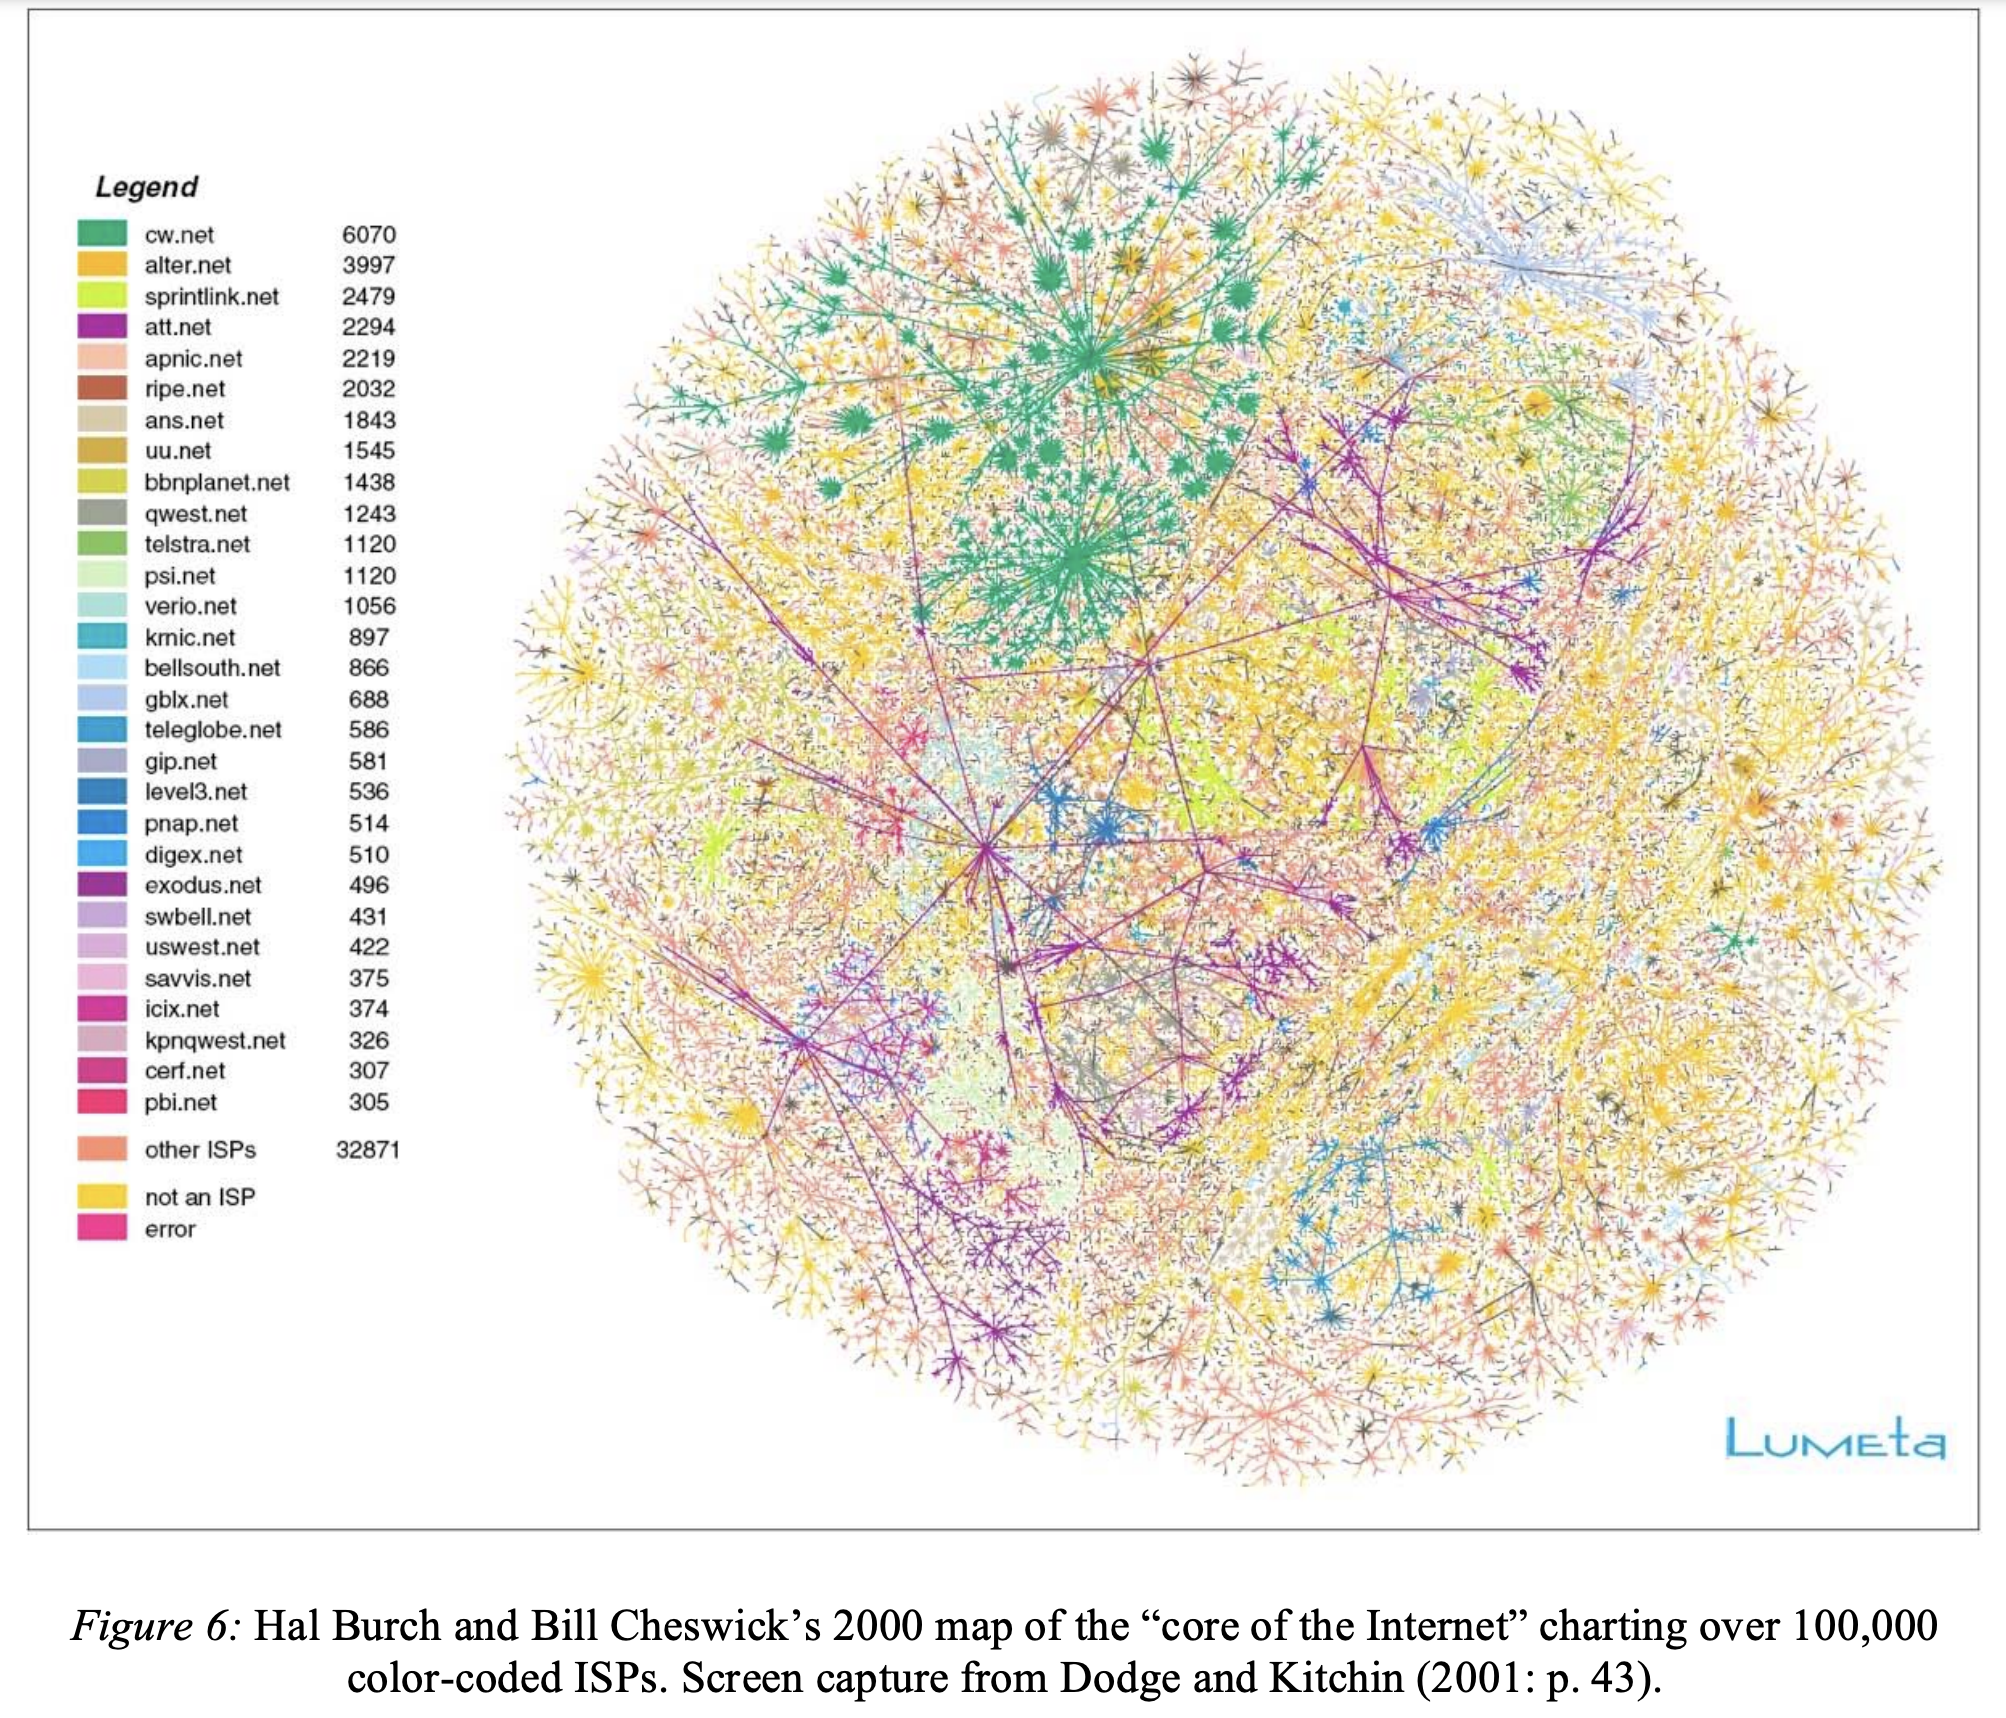
在网络模型中,网络拓扑通常被抽象为一个图 ,其中节点集合 代表各台路由器,边集合 代表物理通信链路。用 表示连接节点 和 的边开销:若 ,则定义其开销为 ;若属于 ,则节点 为节点 的直连邻居(Neighbor)。
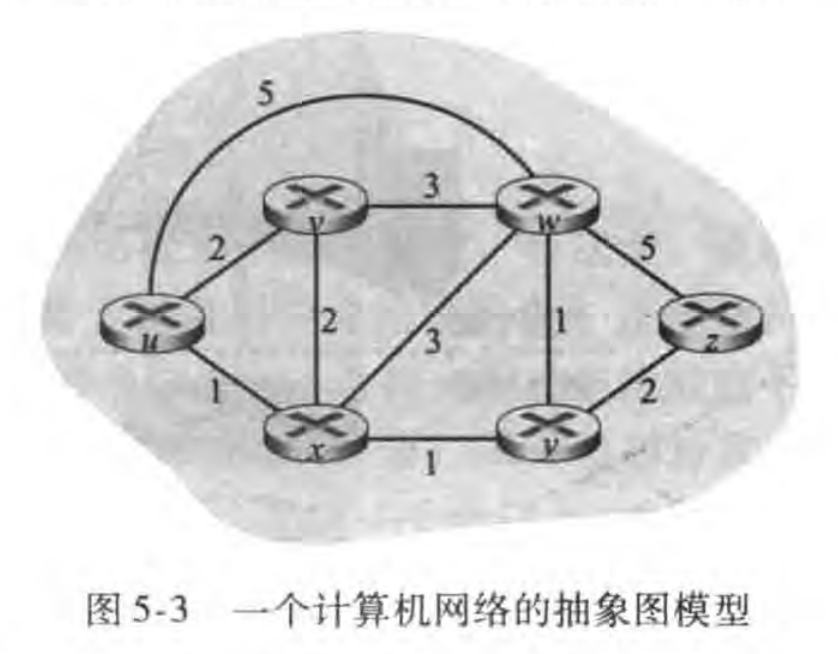
路由选择算法的核心目标,是找出从源节点到目的节点间的最低开销路径(Least-Cost Path)。若图中的所有边具有相同的开销(例如均为 1),则最低开销路径等价于跳数最少的最短路径(Shortest Path)。
路由选择算法通常依循三个维度进行分类:
- 集中式 vs 分散式:
- 集中式路由选择算法(Centralized Routing Algorithm):以完整的、全局性的网络拓扑与链路开销信息为输入计算最低开销路径。具有全局状态信息的算法常被称为链路状态(Link State, LS)算法;
- 分散式路由选择算法(Decentralized Routing Algorithm):路由器以迭代、分布式的方式计算最低开销路径。没有单个节点预先拥有全网所有链路开销的完整视图,典型的代表是距离向量(Distance-Vector, DV)算法。
- 静态 vs 动态:
- 静态路由选择算法(Static Routing Algorithm):路由随时间变化极慢,通常由管理员人工规划调整;
- 动态路由选择算法(Dynamic Routing Algorithm):随着网络流量负载或拓扑发生变化而自动实时调整计算结果。
- 负载敏感 vs 负载迟钝:
- 负载敏感算法(Load-Sensitive Algorithm):链路开销动态变化以实时反映底层链路当前的拥塞水平;
- 负载迟钝算法(Load-Insensitive Algorithm):链路开销不明确反映瞬时拥塞水平。
链路状态(LS)算法:Dijkstra
在 LS 算法的实践中,每台节点通过向网络中的所有其他节点广播其直连链路的开销信息(链路状态广播,Link State Broadcast),使所有节点都获得全网拓扑的完整视图。随后,各节点在本地运行 Dijkstra 算法 [@TuWenXiangJieDijkstraZuiDuanLuJingSuanFa2021][@DijkstraAlgorithm2023],求解从自身到达全网所有其他节点的最低开销路径。
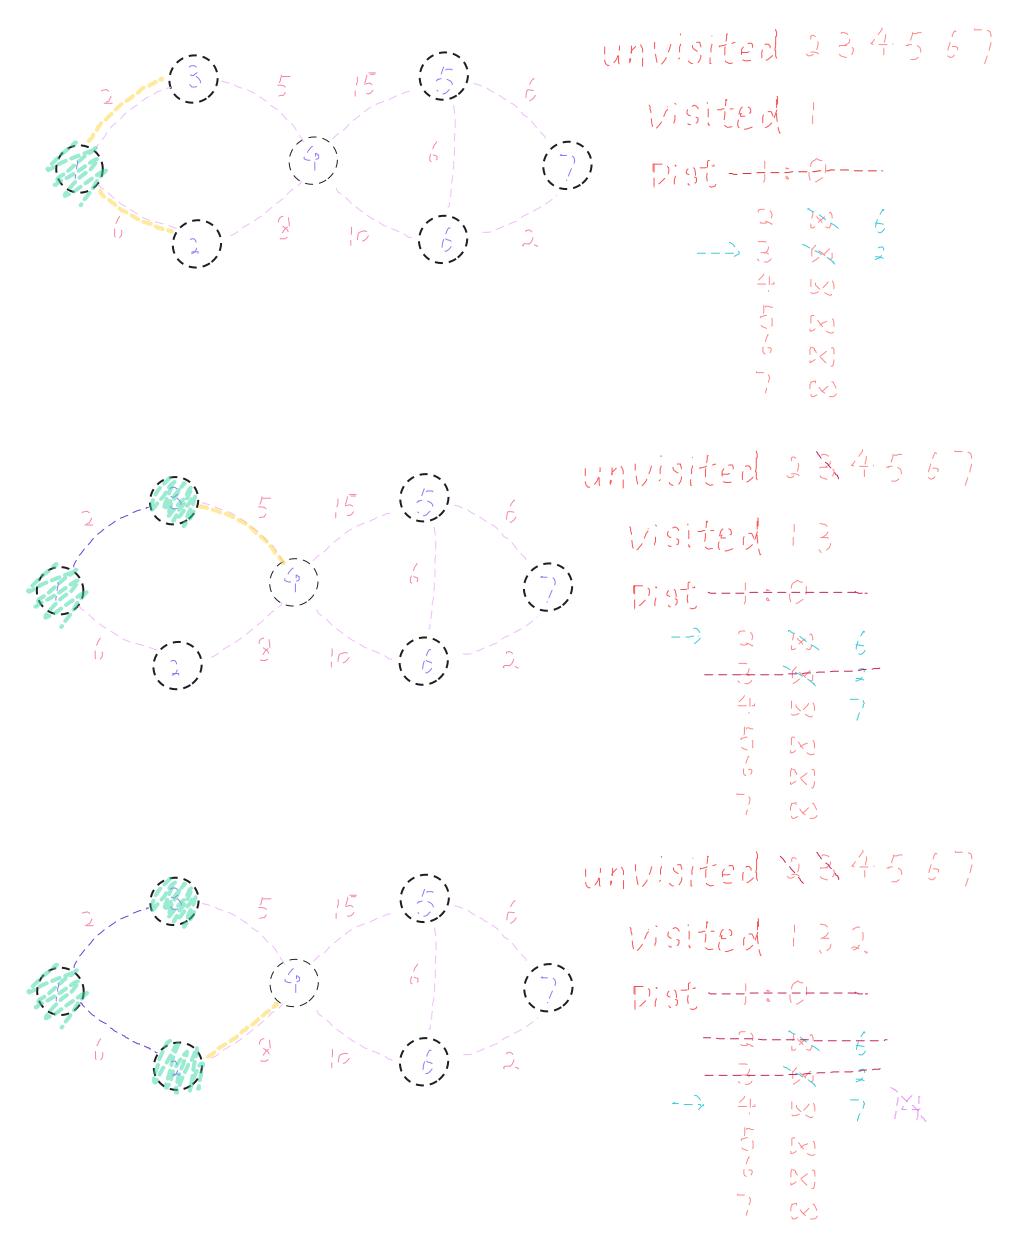
经过算法的 次迭代后,即可确定到达 个最近目的节点的最低开销路径。当 LS 算法终止时,对于网络中的每个节点,都可以得到从源节点沿着最低开销路径回溯的前一节点;通过对每个目的节点记录从源点 到该目的地的最低开销路径上的下一跳(Next Hop)节点,即可在本地直接构建转发表。
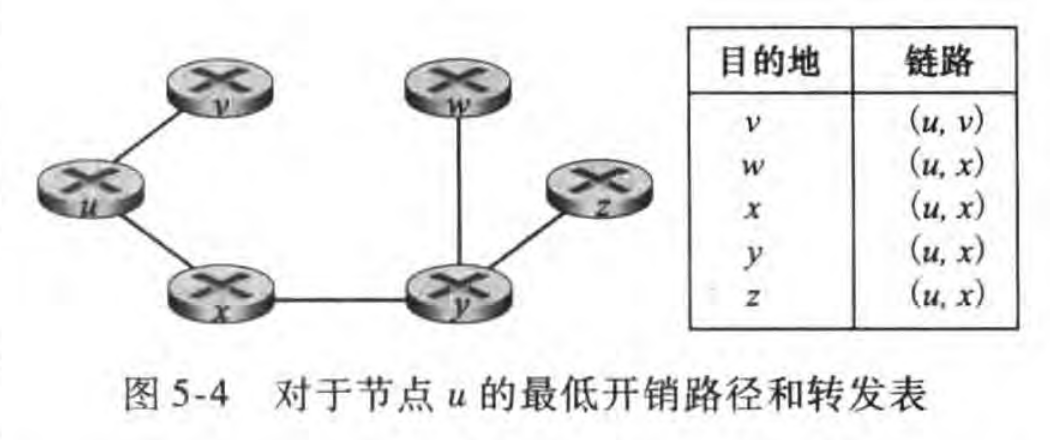
负载敏感路由选择的路径振荡
当路由算法设计为拥塞敏感(链路开销随实时承载的流量动态增加)时,极易引发破坏性的路由振荡现象:
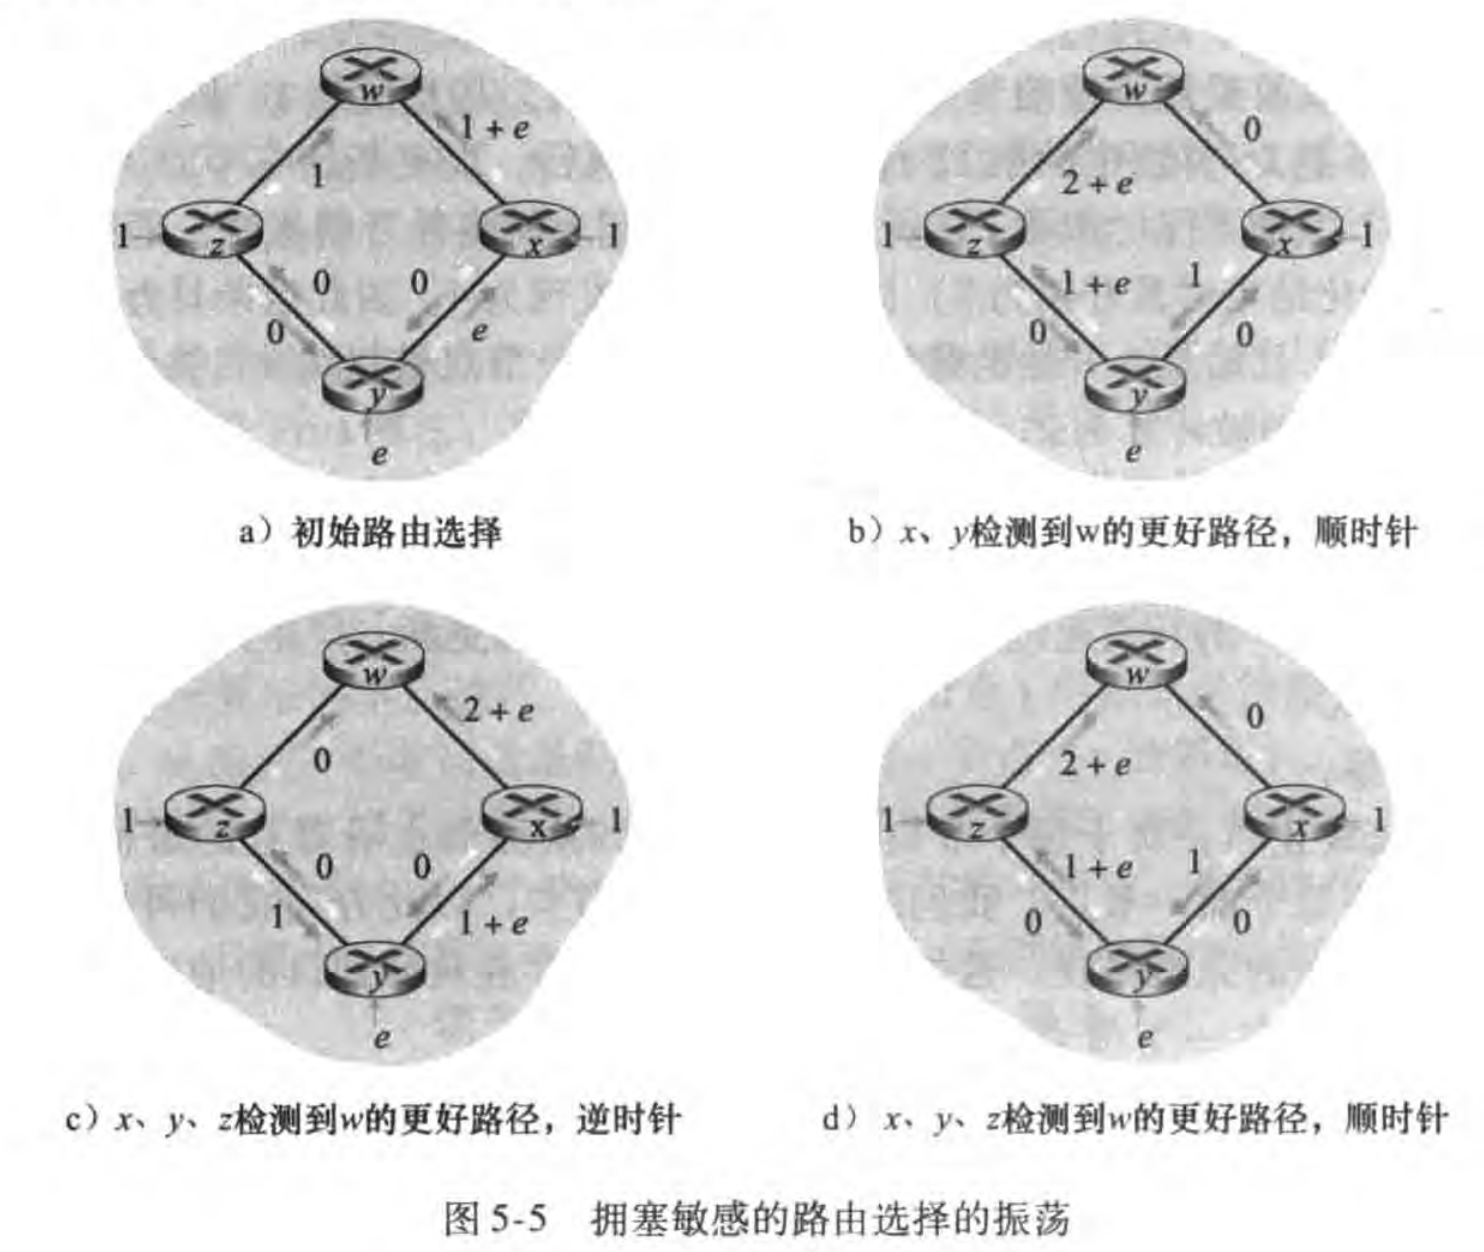
如图所示的情形:
- 节点 和 向节点 发送流量,产生开销为 1 的链路负载;节点 向节点 发送流量,产生开销为 的负载;
- 如果算法对拥塞敏感,在第二次重新运行 LS 算法时,节点 发现第一次状态下逆时针路径
y -> x -> w的总开销为 ,而顺时针路径y -> z -> w的总开销仅为 。因此节点 会选择顺时针路径,同理节点 和 也都会将流量倒换至顺时针方向; - 当第三次执行 LS 算法时,顺时针方向因所有流量涌入而严重拥塞,所有流量又集体倒换为逆时针发出;第四次又全切为顺时针,从而在网络中引发剧烈的往复振荡;
- 避免此类振荡的有效工程方法是打破全局同步:让每台路由器发送链路状态通告和运行 LS 计算的时刻随机化,防止全局节点在同一周期步调一致地同步切换路径。
距离向量(DV)算法:Bellman-Ford
距离向量(Distance-Vector, DV)算法具备三个核心特质:
- 分布式:每个节点仅需从一个或多个直接相连的邻居接收信息,在本地执行计算,然后将计算结果回发给邻居;
- 迭代:这一交互过程持续进行,直到邻居之间无更多新信息需要交换为止;
- 异步:不要求全网节点保持步伐一致的操作步调。
DV 算法的核心数学基础是 Bellman-Ford 方程:
方程遍历节点 的所有直连邻居 。从节点 到目的地 的最低开销,是所有直连邻居 对应的“直连边开销 加上邻居到目的地的最低开销 ”的最小值。令 为使得该方程取得最小值的邻居节点:若节点 要沿着最低开销路径向 发送分组,它应当先将分组发往 ,因此节点 的转发表指定 作为通往 的下一跳路由器。
在 DV 算法中,每个节点维护如下三份路由选择信息:
- 本地到所有直连相邻节点 的链路开销 ;
- 节点 自身的距离向量 ,记录 到网络中所有目的地 的开销估计值;
- 每个直连邻居的距离向量副本 。
每个节点会不时向所有邻居发送自己的距离向量。当节点 从邻居 收到新的距离向量时,保存该向量并代入 Bellman-Ford 方程重新计算自己的向量。如果 的距离向量发生变化,则向所有邻居广播更新后的向量,进而触发邻居更新自身。只要所有节点以异步方式持续交换向量,各开销估计值 最终必定收敛到全网真实的最低开销 。对于给定的目的地 ,节点 关注的是沿着最短路径到达 的下一跳邻居节点 ,并以此配置转发表。
链路开销改变与路由选择环路
当运行 DV 算法的节点检测到自身与邻居的直连链路开销发生变动时,它会更新自己的距离向量;若向量分量发生改变,便向所有邻居通告新的向量。但在开销大幅恶化或断开时,可能遭遇严重的 路由选择环路(Routing Loop) 与“计数到无穷”问题:
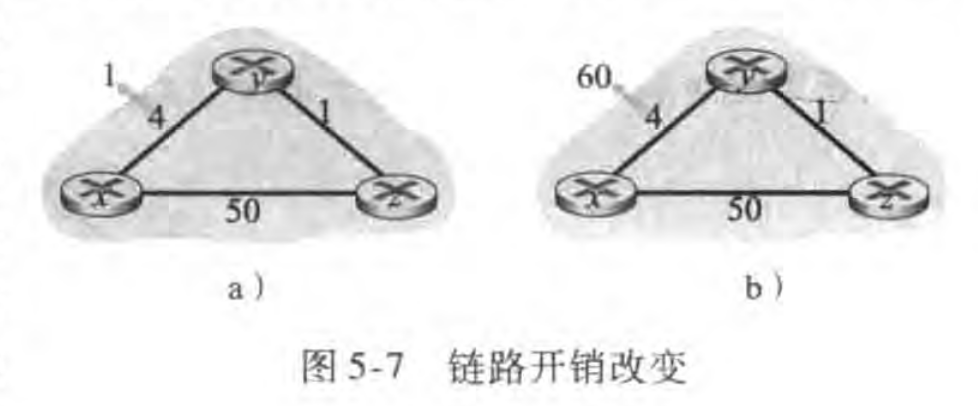
假设初始状态下 ,,,:
- 在 时刻,当 检测到链路开销突增(从 4 骤变为 60)时, 计算到 的新距离向量:
- 此时网络中陷入路由选择环路:为了到达 , 认为应当向 转发,而 却认为应当向 转发,发出的分组在这两个节点之间不停地来回乒乓震荡;
- 计算出 后,在 时刻将新向量通告给 ;
- 时刻 收到通知,得知 到 的最低开销变为 6,于是重新计算: 随后在 时刻通告给 ;
- 时刻 收到通知,计算出 并通告给 ;随后 计算出 9 并通告给 ……
- 两个节点彼此推高开销,如此反复循环数十次,直到 向 通告的开销超过 50()。此时 到 的最低开销路径终于切换为直连的
z -> x(开销 50),经过最后一次迭代后系统才恢复静止,路由选择环路彻底终结。
毒性逆转(Poisoned Reverse)
为了防止双节点环路,工程中引入了 毒性逆转(Poisoned Reverse) 技术 [@SplitHorizonRoute2023]: 若节点 通往目的地 的最低开销路径是经由邻居 路由的,则 在向 通告距离向量时,特意虚报 。
通过这个善意的谎言, 便确信 没有到达 的独立路径,因而在发生链路恶化时绝不会试图借道 绕回 :
- 当直连链路开销变为 60 时, 更新其距离向量分量为: 并将新向量通告给 ;
- 此时 获知 开销已达 60,立即更新自身距离向量并将下一跳切换为直连路径,向 通告 ;
- 收到更新后,以 更新距离表,并为了继续毒化逆向路径向 通告 。
需要强调的是, 毒性逆转技术仅能解决涉及两个直接相邻节点的环路;一旦环路中包含 3 个或更多节点,毒性逆转便无法有效检测与规避。
LS 与 DV 算法的特性对比
- 通信开销:LS 要求每个节点通过洪泛广播与全网所有节点通信,但仅通告与自身直连的局部链路开销;而 DV 中每个节点仅与直连相邻节点通信,但向邻居提供的是自己到达全网所有节点的完整开销估计;
- 计算复杂度:LS 算法在单节点上的计算复杂度为 ;DV 算法各节点异步迭代收敛,收敛轮次依赖于具体拓扑与链路变动;
- 健壮性:LS 中每个节点在本地独立运行计算,单个节点的异常通告对全局拓扑的影响相对隔离;而在 DV 算法中,一个节点错误的局部计算结果会随着向量交换迅速扩散至全网,排障成本更高。
自治系统内部的路由选择:OSPF
在实际生产因特网中,将全球所有路由器视作单一平面网络来运行路由选择算法是不可行的,主要受制于两大现实瓶颈:
- 规模与扩展性:随着路由器数量爆发,全网洪泛广播的通信开销、路由表的存储需求以及 CPU 计算复杂度将急剧膨胀;
- 管理自治:在理想情况下,每个组织或运营商必须能够按照自身意愿独立运行和管理其内部网络,同时兼顾与外部网络的互联互通。
为此,因特网划分为多个自治系统(Autonomous System, AS)。每个 AS 由一组处在相同管理控制下的路由器组成。ISP 可以将其网络划分为一个或多个 AS,自治系统号(ASN)由 ICANN 统筹分配。
在一个自治系统内部运行的路由选择算法被称为自治系统内部路由选择协议(Intra-AS Routing Protocol)。其中最广泛使用的标准是开放最短路优先(Open Shortest Path First, OSPF) [@moyOSPFVersion1998]。
OSPF 是一种基于链路状态(LS)的协议,采用泛洪链路状态信息和 Dijkstra 最低开销路径算法。路由器在本地构建自治系统的完整拓扑图,并通过运行 Dijkstra 算法,生成以自身为根节点到该 AS 内所有子网的最短路径树。
各条链路的开销权值由网络管理员灵活配置,OSPF 本身不强制限定链路权值设置策略:
- 将每条链路的开销统一设为 1,即可实现跳数最少路由;
- 将链路权值与物理信道带宽设为反比,能够有效引导流量绕开低带宽瓶颈链路。
在使用 OSPF 时,路由器向自治系统内所有其他路由器广播路由选择信息:
- 每当链路状态发生变动,路由器立即触发式广播链路状态信息;
- 即使链路状态未发生变化,路由器也会周期性广播链路状态,显著增强了链路状态算法的健壮性。
OSPF 协议报文直接由 IP 承载(协议号 89),因此 OSPF 内部自行实现了可靠报文传输与泛洪确认机制。其核心优势包括:
- 安全性:支持使用鉴别认证机制,防止非法攻击者伪造路由报文;
- 等价多路径(ECMP):当通往某目的地存在多条相同最低开销的路径时,允许将流量在多条路径上并行分担;
- 支持单播与多播路由选择的综合能力;
- 分层多区域结构(Hierarchical Areas):在大型 AS 内部可进一步划分为骨干区域和普通区域,每个区域内部的一台或多台区域边界路由器(ABR)负责向外汇总广播链路状态,降低了单一路由器的内存与计算负担。
ISP 之间的路由选择:BGP
当分组跨越多个自治系统进行路由时,必须依赖自治系统间路由选择协议(Inter-AS Routing Protocol)。在今天的因特网中,所有的自治系统均运行着相同的 AS 间路由选择协议—— 边界网关协议(Border Gateway Protocol, BGP)。
BGP 的作用
在同一个 AS 内部,路由器转发表中的表项由 AS 内部路由选择协议(如 OSPF)直接决定;而在 BGP 中,分组不再是路由到一个具体的主机目的地址,而是路由到 CIDR 化的网络前缀。
BGP 为网络中的每台路由器提供了一种手段,用于完成以下关键任务:
- 从相邻的外部自治系统获悉网络前缀的可达性信息;
- 针对同一前缀的多条可选跨域路径,确定一条“最好”的路由。
通告 BGP 路由信息
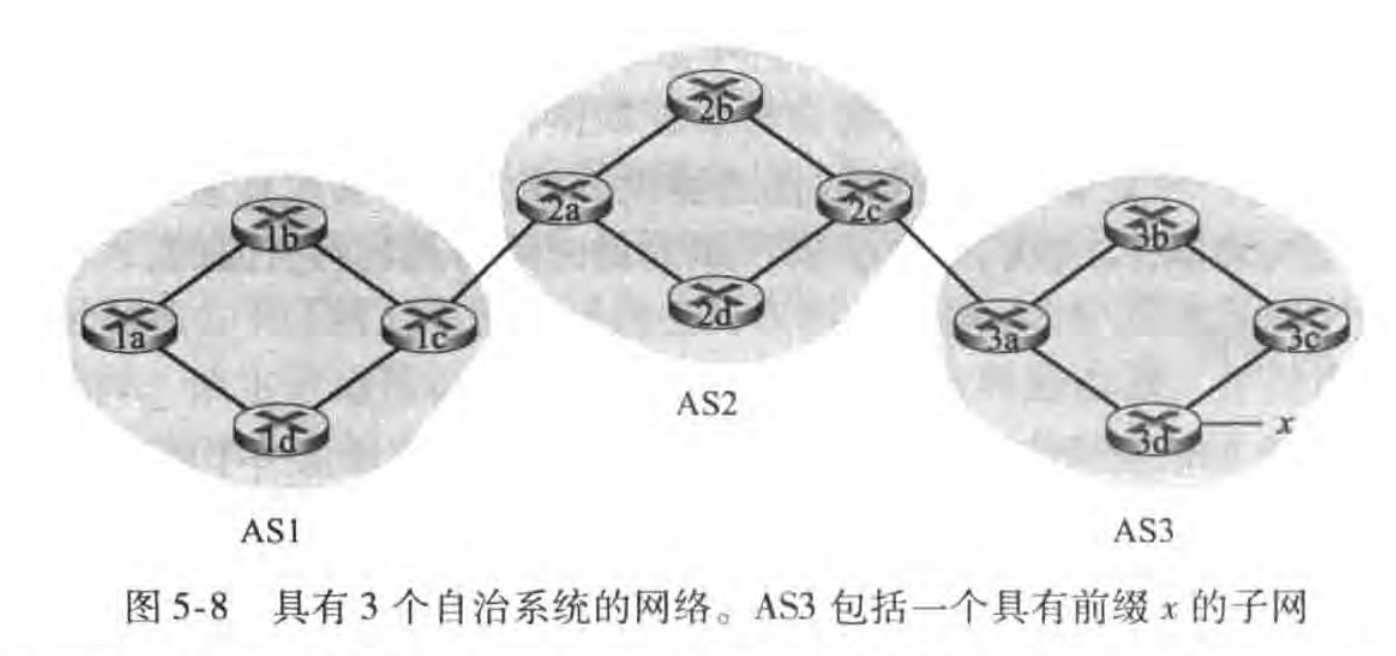
对于每个自治系统,每台路由器要么是一台网关路由器(Gateway Router),要么是一台内部路由器(Internal Router)。网关路由器部署在 AS 边缘,直接连接外部相邻 AS;内部路由器仅连接自己 AS 内部的主机和其他路由器 [@ShiMeShiBGPBGP]。
在宏观(AS)视角下,若要向全网所有路由器通告前缀 的可达性信息:
- AS3 向 AS2 发送一个 BGP 报文
AS3 x,宣告前缀 存在且位于 AS3 内部; - AS2 向 AS1 发送报文
AS2 AS3 x,宣告前缀 存在,并且可以通过经过 AS2 到达 AS3 的路径前往 。
在底层传输上,每对 BGP 路由器通过使用 TCP 179 端口建立的半永久 (?) 连接来交换路由选择信息。两台直连路由器之间的连接及其上发送的 BGP 报文统称为 BGP 连接(BGP Connection):
- 跨越两个不同 AS 的 BGP 连接称为外部 BGP(eBGP)连接;
- 同一个 AS 内部两台路由器之间的会话则称为内部 BGP(iBGP)连接。
路由器之间通常维护着多条 iBGP 连接。需要特别指出的是,使用 iBGP 并非使用 eBGP 的前提条件,自治系统可以从多种内部协议机制中灵活选择来连通内部网络路由器。
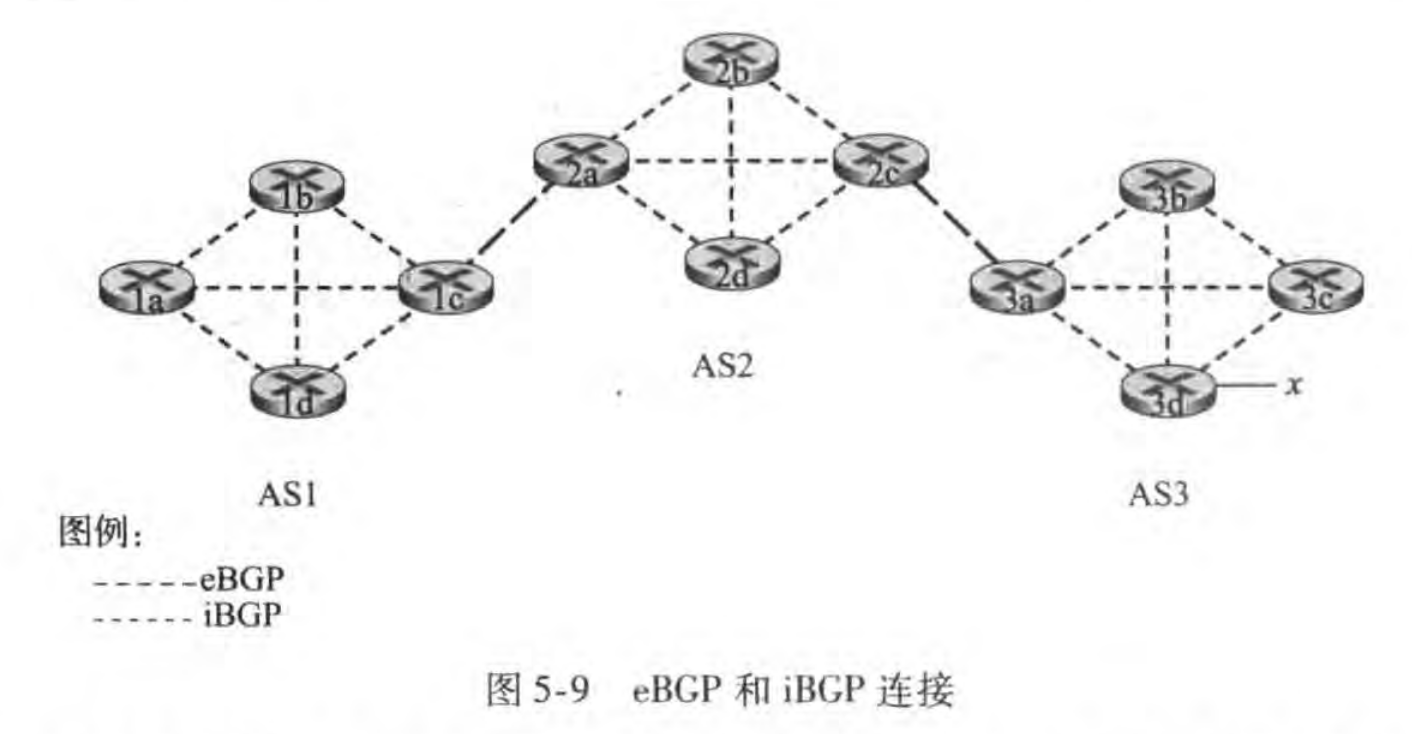
结合具体拓扑再次考察通告过程:
- 路由器 3a 首先向相邻的网关路由器 2c 发送一条 eBGP 报文
AS3 x; - 网关 2c 收到后,向 AS2 内部所有其他路由器(包括出口网关 2a)发送 iBGP 报文
AS3 x; - 网关 2a 向 AS1 的网关 1c 发送一条 eBGP 报文
AS2 AS3 x; - 网关 1c 收到后,向 AS1 内部的所有路由器发送 iBGP 报文
AS2 AS3 x。
在实际生产网络中,从某个给定的路由器出发前往同一目的地前缀,往往会存在多条不同的候选路径。
确定最好的路径[@WeiShiMeBGPSheQuBi2022]
当路由器通过 BGP 连接通告网络前缀时,会在前缀信息中附加一系列 BGP 属性(BGP Attribute)。按照 BGP 规范,前缀及其属性的集合统称为一条路由(Route)。
其中两个至关重要的属性包括:
- AS-PATH:记录该路由通告自始发以来所依次穿过的所有自治系统列表。当路由器在收到的路径列表中检测到包含自己所在的 AS 时,会果断拒绝并丢弃该通告,从而实现跨域防环;
- NEXT-HOP:记录 AS-PATH 从左向右起始的路由器接口的 IP 地址(即最后经过的相邻 AS 网关路由器出端口的 IP 地址)。虽然该 IP 地址不属于当前 AS,但包含该 IP 地址的子网必定与当前 AS 直接相连。
一段从网络抓包中提取的真实 BGP UPDATE 报文格式如下:
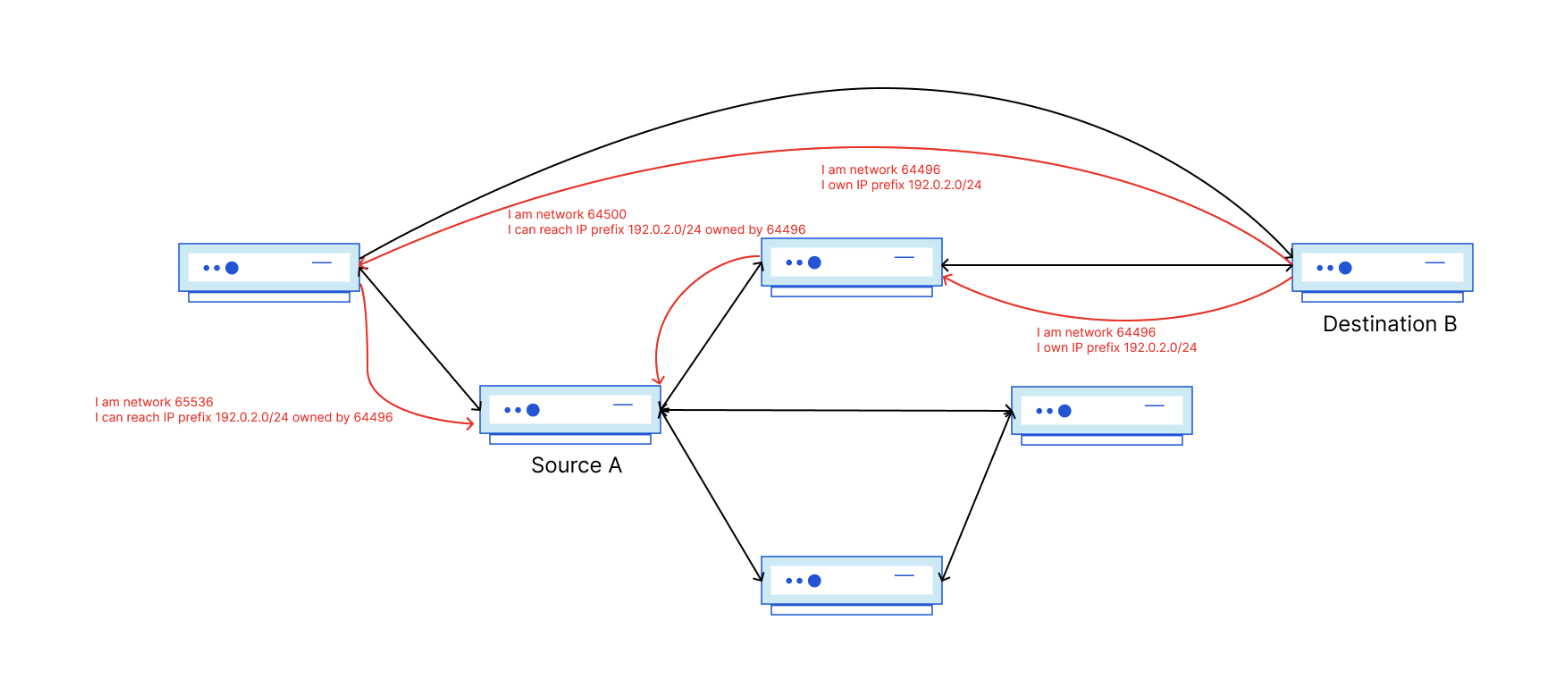
BGP Message
    Type: UPDATE Message
    Path Attributes:
        Path Attribute - Origin: IGP
        Path Attribute - AS_PATH: 64500 64496
        Path Attribute - NEXT_HOP: 198.51.100.1
        Path Attribute - COMMUNITIES: 64500:13335
        Path Attribute - Multi Exit Discriminator (MED): 100
    Network Layer Reachability Information (NLRI):
        192.0.2.0/24
热土豆路由选择(Hot Potato Routing)
当运行热土豆路由选择算法的路由器收到通往同一前缀 的多条候选 BGP 路由时,它借助 AS 内部路由选择信息计算到达各个出口网关的内部最低开销路径;随后在这些候选网关中,选择内部开销最低的那台网关作为出口,并将指向该网关路径的本地接口 的转发表项 写入转发表。
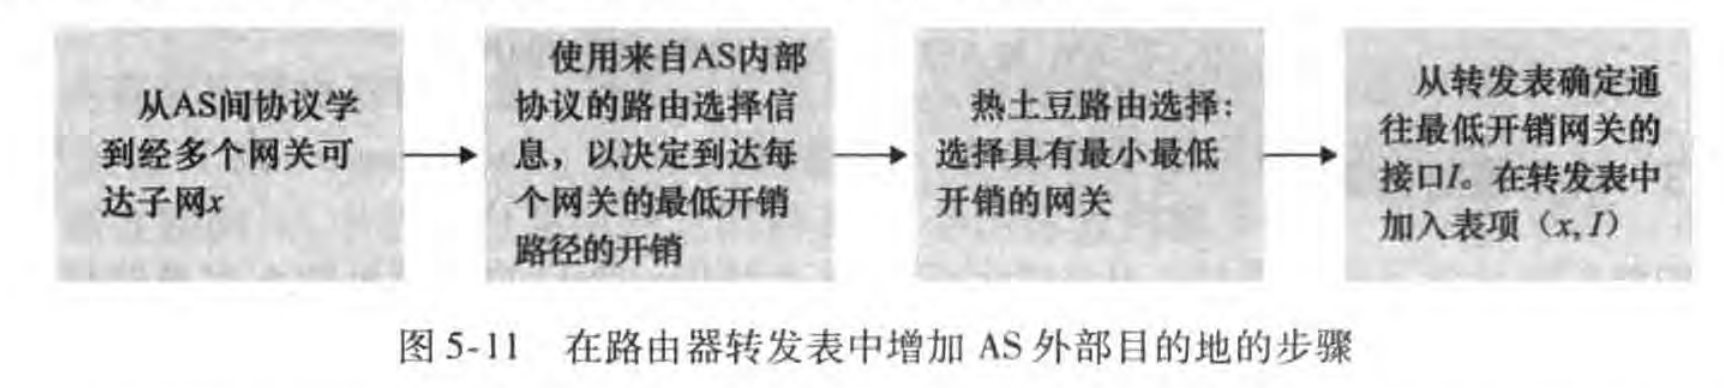
热土豆路由选择是一种典型的“自私”算法:它只试图尽可能减小分组在自身 AS 内部消耗的开销,以最低代价、最快速度将分组“甩”出自己的自治系统,而不在乎分组离开本地后在外部网络还将经历多大的传输总开销。
路由器选择算法
对于任何给定的目的地前缀,进入 BGP 的选路输入是通往该前缀的所有路由候选集合。如果到达同一前缀仅有一条有效路由,BGP 直接采纳该路由;如果存在多条候选路由,BGP 顺序调用下列消除规则,直至只剩下唯一的一条最优路由:
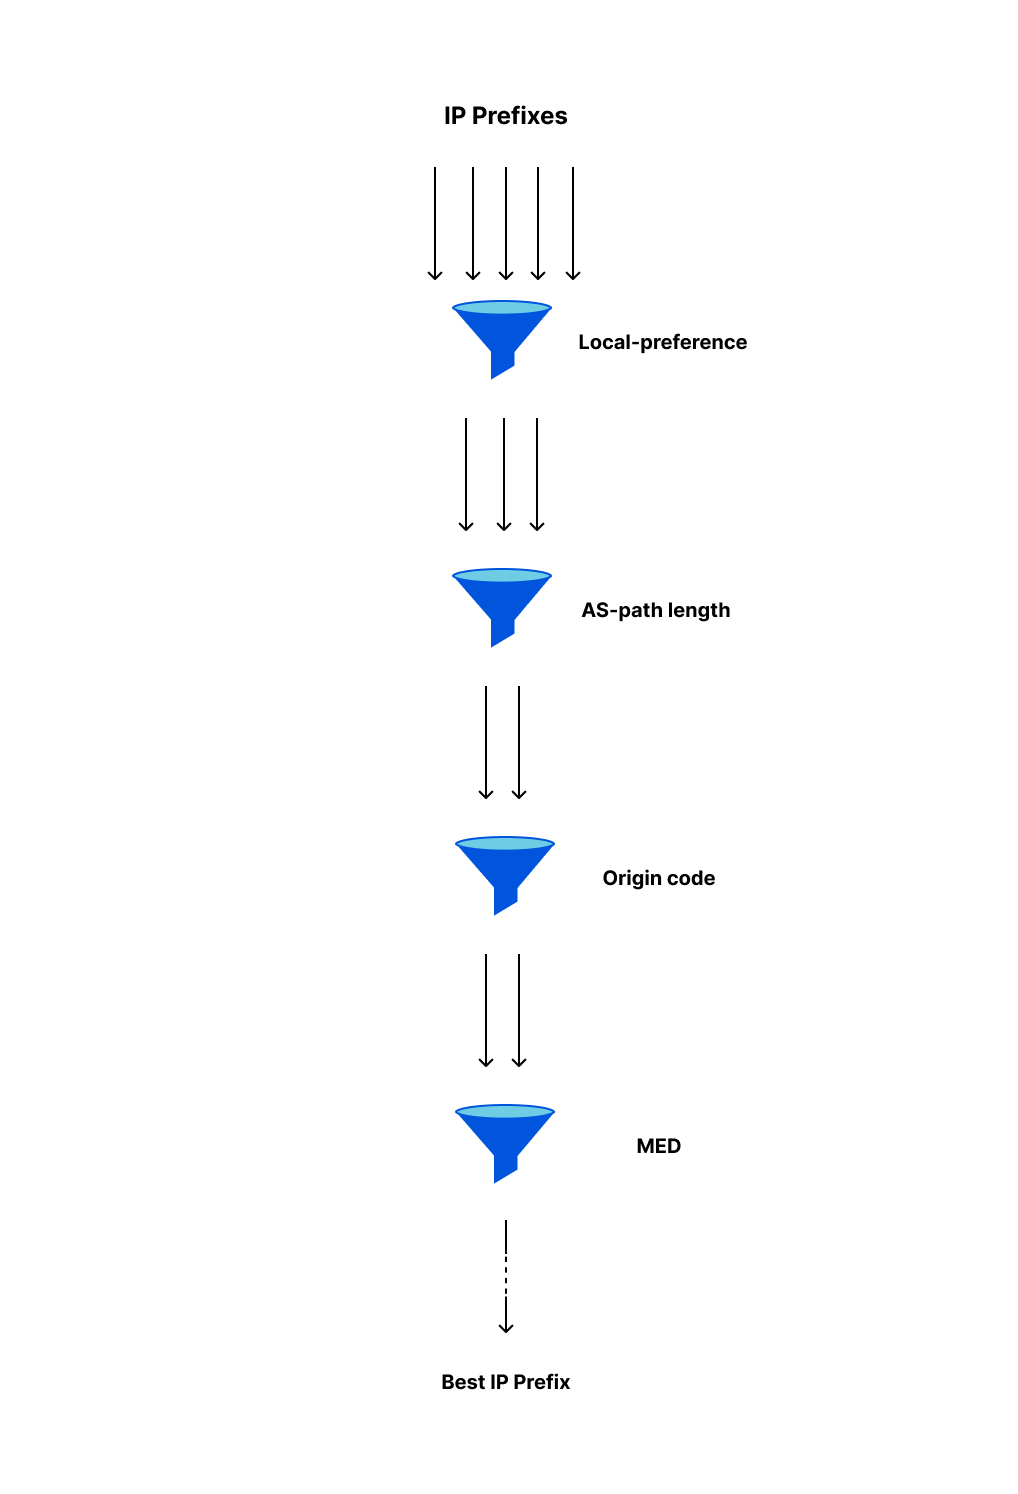
- 本地偏好值(Local-Preference):优选具有最高本地偏好值的路由。该属性完全取决于网络管理员的策略设定,可以由本路由器直接设置或从同 AS 内的其他路由器学习到;
- 最短 AS-PATH:在本地偏好值相同的候选路由中,优选具有最短 AS-PATH 跳数的路径。如果系统仅以此规则决策,BGP 实际上退化为使用距离向量算法决定路径,其中的距离度量采用 AS 跳数而非单一物理路由器跳数;
- 热土豆路由(Hot Potato Routing):在 AS-PATH 长度依然相同的情况下,优选最靠近其 NEXT-HOP 路由器的路由(即到达下一跳网关的内部 IGP 开销最小);
- 其他 BGP 标识符仲裁:若仍未决胜,依次比对 MED 属性,优选来自 eBGP 的路由,最终优选具有最低 BGP 路由器 ID 的路径。
IP 任播(Anycast)
Anycast 技术的产生源于两大现实驱动力:
- 在地理上分散的不同物理位置,部署提供完全相同内容的多台镜像服务器;
- 引导每个网络用户自动从拓扑上最靠近的服务器节点就近获取内容。
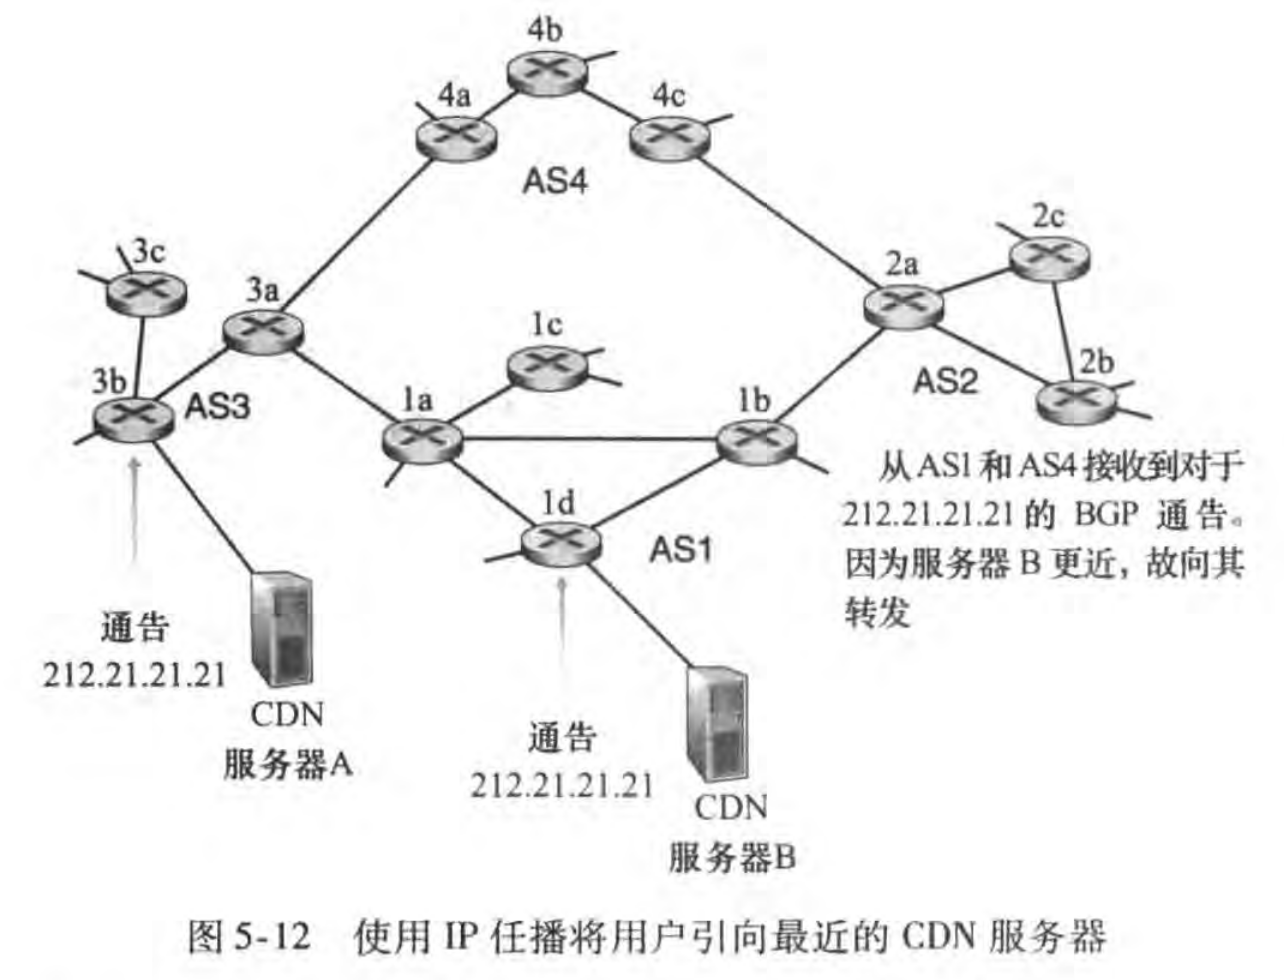
在配置实现上,服务提供商为地理分散的多台服务器指派完全相同的公网 IP 地址,并使用标准 BGP 协议从每一台服务器分别向全网通告这个 IP 地址。当各地的 BGP 路由器收到关于该 IP 地址的多个路由通告时,路由器将其视作为同一逻辑目的地提供的不同物理路径。在配置转发表时,路由器在本地运行 BGP 路由选择算法,找到距离自身最近的服务器节点的路径。
当用户发起访问请求时,网络向用户返回这个全球通用的 Anycast IP 地址(注意与 CDN 的集群选择策略相区分),用户流量在因特网底层由 BGP 算法自动导向最近的物理服务器。
然而在实践中,由于 BGP 路由的动态调整可能导致属于同一 TCP 连接的不同数据分组在中途漂移到不同的 Web 服务器实例上,破坏 TCP 握手与连接状态,因此商业 CDN 通常选择不使用 Anycast 来承载普通的 Web/TCP 服务。但在 DNS 体系中,IP 任播得到了极其广泛的应用:由于 DNS 解析主要依赖无连接的单次 UDP 查询,Anycast 能够完美将用户的解析请求就近分流至全球 13 组权威 DNS 根服务器的就近镜像节点:
| HOSTNAME | IP ADDRESSES | OPERATOR |
|---|---|---|
| a.root-servers.net | 198.41.0.4, 2001:503:ba3e::2:30 | Verisign, Inc. |
| b.root-servers.net | 199.9.14.201, 2001:500:200::b | University of Southern California, Information Sciences Institute |
| c.root-servers.net | 192.33.4.12, 2001:500:2::c | Cogent Communications |
| d.root-servers.net | 199.7.91.13, 2001:500:2d::d | University of Maryland |
| e.root-servers.net | 192.203.230.10, 2001:500:a8::e | NASA (Ames Research Center) |
| f.root-servers.net | 192.5.5.241, 2001:500:2f::f | Internet Systems Consortium, Inc. |
| g.root-servers.net | 192.112.36.4, 2001:500:12::d0d | US Department of Defense (NIC) |
| h.root-servers.net | 198.97.190.53, 2001:500:1::53 | US Army (Research Lab) |
| i.root-servers.net | 192.36.148.17, 2001:7fe::53 | Netnod |
| j.root-servers.net | 192.58.128.30, 2001:503:c27::2:30 | Verisign, Inc. |
| k.root-servers.net | 193.0.14.129, 2001:7fd::1 | RIPE NCC |
| l.root-servers.net | 199.7.83.42, 2001:500:9f::42 | ICANN |
| m.root-servers.net | 202.12.27.33, 2001:dc3::35 | WIDE Project |
路由选择策略
在 BGP 路由选择流程中,本地偏好属性拥有最高的裁决权重,而本地偏好值完全由本地 AS 的管理策略直接决定。
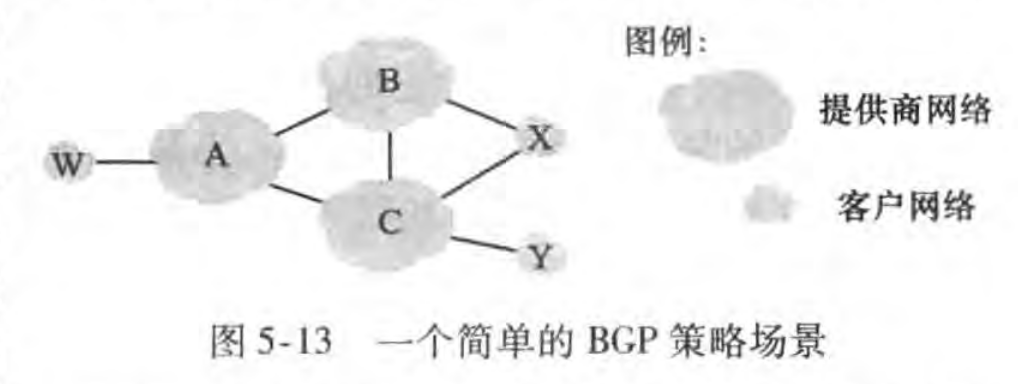
在如图所示的自治系统拓扑中,假设 W、X、Y 是底层的接入 ISP,而 A、B、C 是提供骨干互联的主干提供商网络。骨干网之间相互交换流量并向客户网络提供完整的 BGP 路由信息。对于接入 ISP 而言,所有进入其网络的流量必定是以该网络为目的地,所有离开该网络的流量也必定源于该网络。
拓扑中的 X 是一个多宿接入 ISP(同时接入了 B 和 C 两个骨干网)。如果 X 向 B 和 C 通告它没有通往除自身之外任何其他目的地的路径,那么它将安全地保持纯粹接入 ISP 的职能,而绝不会沦为 B 和 C 之间的中继通路。
这一行为符合商业 ISP 严格遵守的经验法则:任何穿越某 ISP 主干网的中转流量,其源端或目的端(或两者)必须位于该 ISP 的直属网络中。
SDN 控制平面
软件定义网络(SDN)体系结构具有四个关键特征:
- 基于流的灵活转发:由通用流表接管传统的单一目的地址转发;
- 数据平面和控制平面彻底分离:网络交换机在线速硬件中执行基于流表的“匹配加动作”规则,控制平面则由服务器和管理交换机流表的独立软件系统构成;
- 网络控制功能上移:控制平面自身由 SDN 控制器和部署在控制器之上的各类网络控制应用程序共同组成;
- 可编程的网络环境:网络运维人员可以通过编写控制软件,灵活定义路由选路策略与安全控制规则。
在 SDN 体系中,数据平面交换机、SDN 控制器以及网络控制应用程序是完全解耦的独立实体,可以由不同的硬件厂商和软件组织分别研发与提供。
SDN 控制器和 SDN 网络控制应用程序
SDN 控制器在逻辑上划分为三个功能层次:
- 底层通信层(南向接口):负责 SDN 控制器与底层受控物理设备之间的双向通信。受控设备需要向控制器及时传递本地观测到的链路与端口事件,控制器通过南向协议接口下发指令;
- 网络范围状态管理层:集中维护全网拓扑状态数据库、流表规则集以及受控交换机的运行状态;出于容错、高可用和吞吐性能考量,这一状态管理层在生产中通常由高可靠的分布式服务器集群协同实现;
- 网络控制应用程序接口层(北向接口):通过“北向”API 与顶层网络控制应用程序交互,允许应用程序灵活读取或修改网络状态数据库与流表规则。
OpenFlow 协议
OpenFlow 协议运行在 SDN 控制器与受控交换机(或其他实现 OpenFlow API 的网络设备)之间,基于 TCP 协议传输,默认端口号为 6653。
- 从控制器流向受控交换机的关键报文:
配置(Configuration):用于查询并设置交换机的各项运行参数;修改状态(Modify-State):动态增加、删除或修改交换机流表中的表项,并配置交换机的端口特性;读状态(Read-State):从交换机的流表与物理端口中拉取统计数据和计数器信息;发送分组(Send-Packet):指示受控交换机从特定的指定物理端口发送一个特定的报文。
- 从受控交换机上报给控制器的关键报文:
流删除(Flow-Removed):通知控制器某条流表项已被超时删除或显式移除;端口状态(Port-Status):向控制器通告物理端口的状态变迁(如链路断开或恢复);分组入(Packet-In):当到达交换机端口的分组无法匹配当前流表中的任何已有表项时(触发默认动作),该分组会被完整封装并发送给控制器进行深度分析与流表决策。
数据平面和控制平面交互的实例
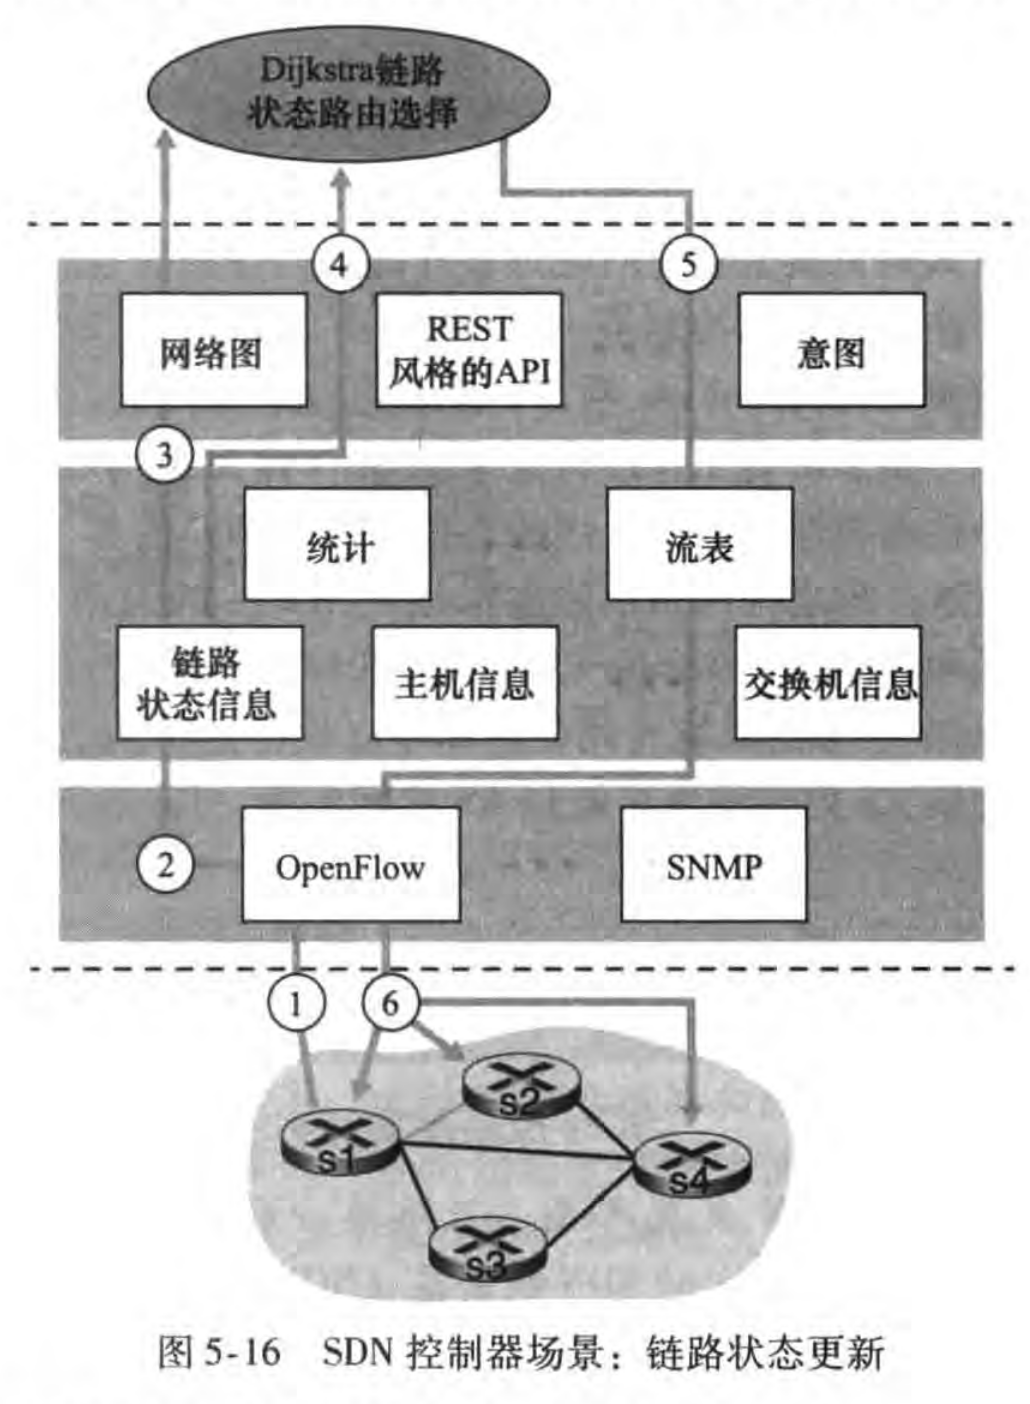
与传统模式下的每路由器控制不同,在上图所示的 SDN 架构中:
- Dijkstra 最短路径算法作为一个单独的软件程序执行,部署在分组交换机硬件外部;
- 分组交换机仅与中央 SDN 控制器单线交互链路更新,交换机彼此之间不再泛洪广播。
假设交换机 S1 与 S2 之间的直连链路状态发生变动:
- S1 检测到底层链路故障,立即通过 OpenFlow 的端口状态报文向 SDN 控制器通报链路状态更新;
- SDN 控制器接收到该报文后,通知链路状态管理器更新全局链路状态数据库;
- 预先注册了事件监听的 Dijkstra 链路状态路由选择应用程序收到关于拓扑变化的事件通知;
- 路由选择应用程序与链路状态管理器交互,获取最新的拓扑信息,并参考状态管理层中的其他网络组件,重新计算出全网新的最低开销路径;
- 路由选择应用与流表管理器交互,由流表管理器计算生成具体的流表调整条目;
- 流表管理器使用 OpenFlow 的
Modify-State报文向受影响的交换机 S1、S2 和 S4 批量下发更新后的流表规则,完成全网数据路径的自愈与重构。
互联网控制报文协议(ICMP)
因特网控制报文协议(Internet Control Message Protocol, ICMP)[@InternetControlMessage1981] 的典型用途是进行网络层差错报告与运行诊断。
在协议封装上,ICMP 报文作为 IP 数据报的有效载荷承载(协议号为 1),其常见格式如下:
	0                   1                   2                   3
    0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
   +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
   |     Type      |     Code      |          Checksum             |
   +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
   |                             unused                            |
   +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
   |      Internet Header + 64 bits of Original Data Datagram      |
   +-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
报文前 4 字节包含类型(Type)、代码(Code)与检验和(Checksum)。差错报文还会附带引发差错的初始 IP 数据报的首部以及紧随其后的前 64 比特数据,以便源端识别触发异常的具体进程。
网络诊断工具 Traceroute(以及现代网络诊断工具 NextTrace)利用 ICMP 报文与 TTL 机制探测端到端路径: 源端向目标主机发送一系列 TTL 递增的探测报文。当第 个数据报到达第 台路由器时,TTL 归零过期,该路由器丢弃数据报并向源端回送一个 ICMP 差错告警报文(Type 11 Code 0);当数据报最终到达目的地主机时,目标端回送一个 ICMP 回显响应报文(Type 0 Code 0),探测程序接收后即获知探测终点并停止发送。
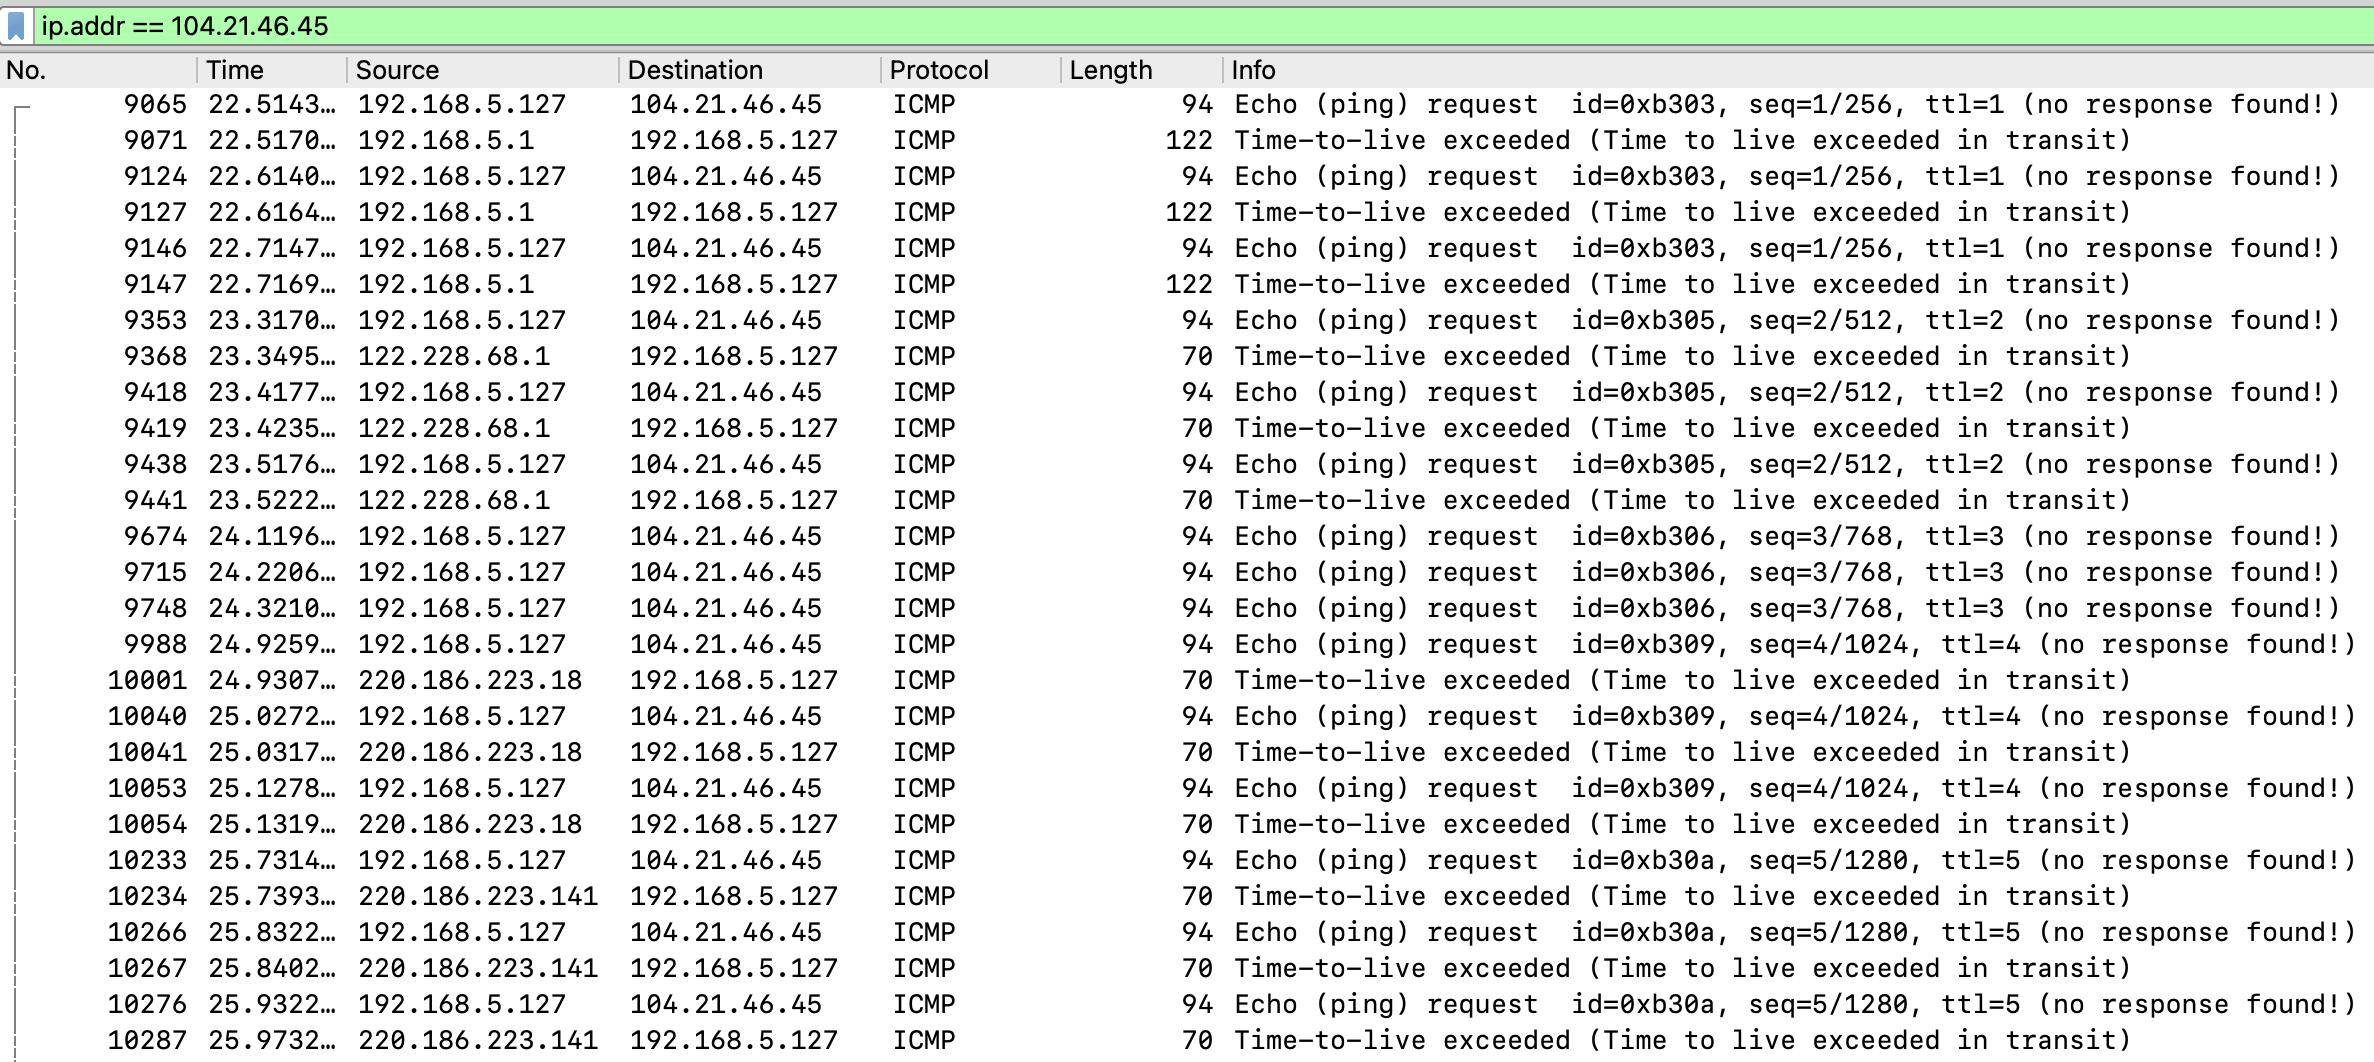
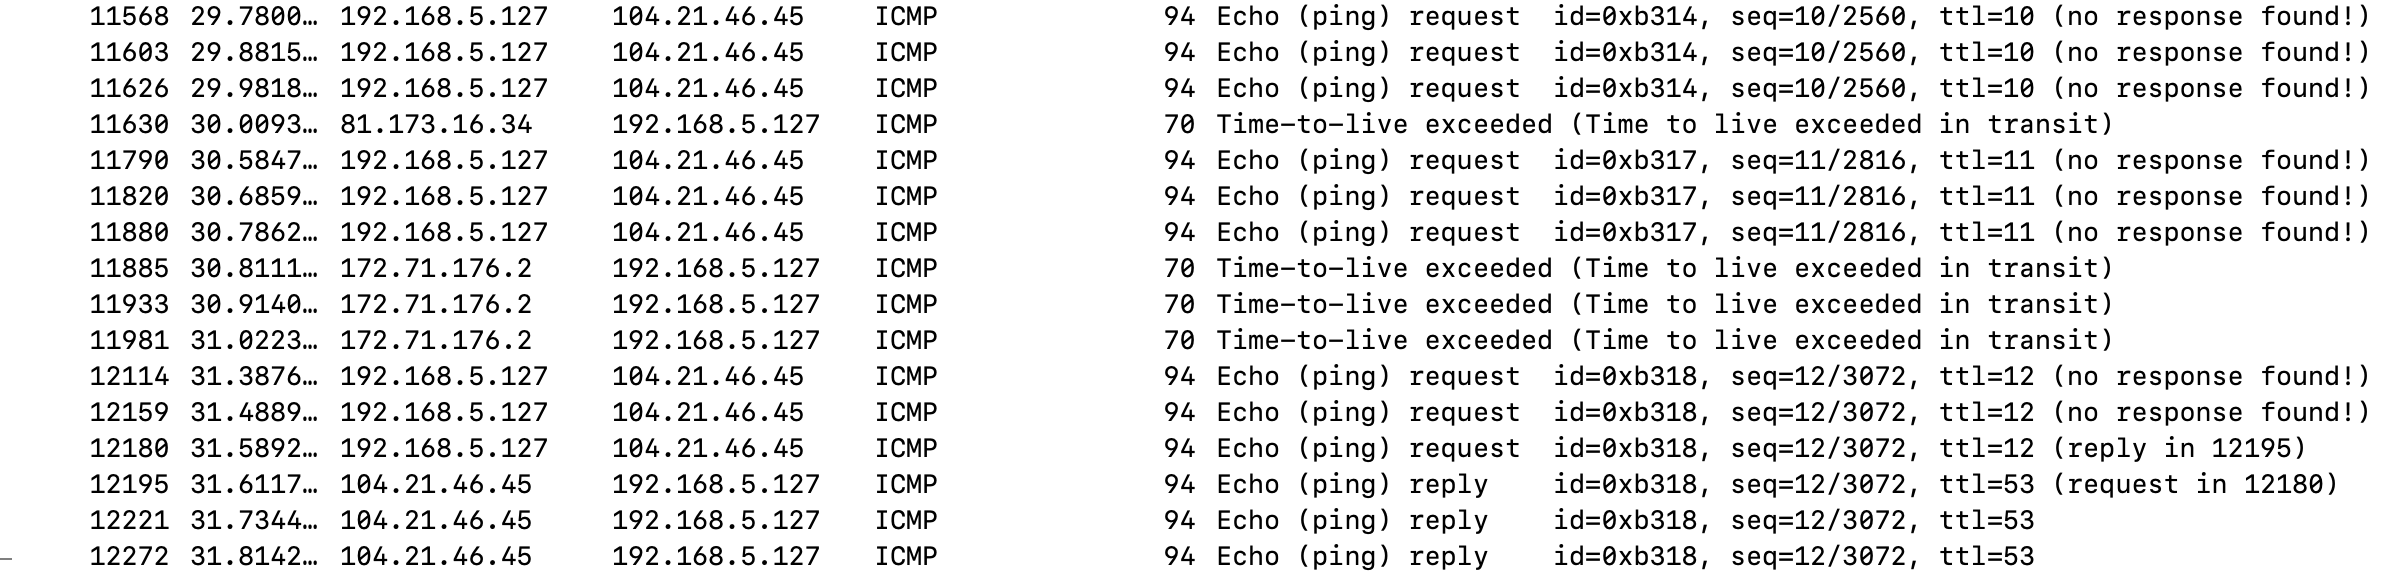
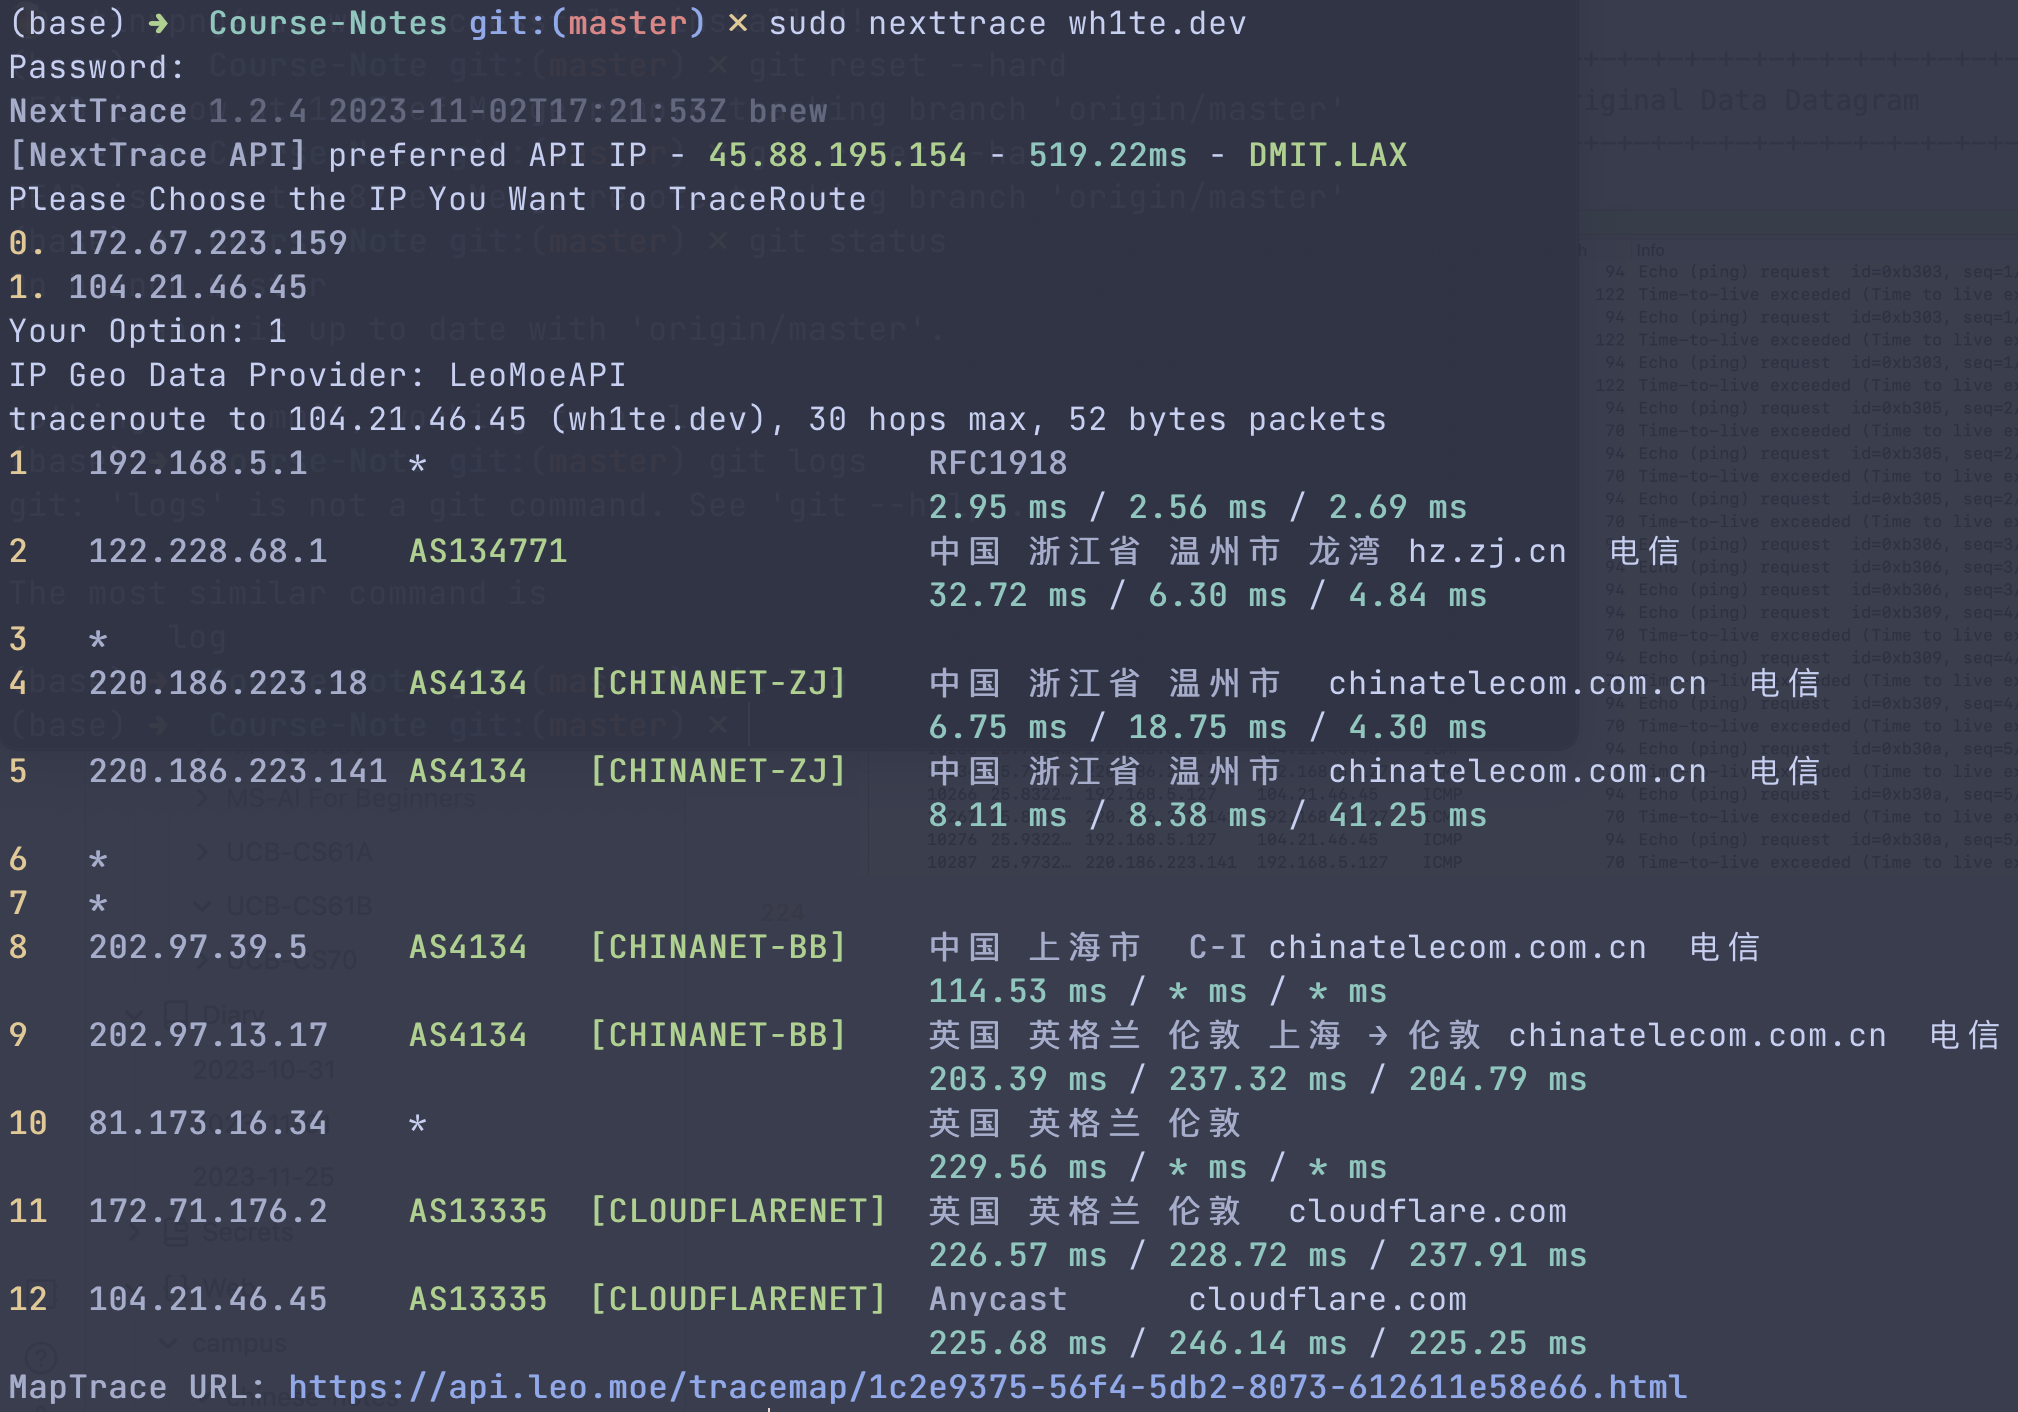
在 IPv6 环境中,RFC 4443 [@guptaInternetControlMessage2006] 定义了 ICMPv6,新增了诸如“分组太大(Packet Too Big)”以及“未被承认的 IPv6 选项”等全新差错编码。
网络管理
网络管理的系统化定义是指:通过对硬件、软件及人力要素的设置、综合与协调,全面监视、测试、轮询、配置、分析、评价和控制网络及网元资源,以合理的成本保障网络运营的实时性、运营性能与服务质量(QoS)要求。
网络管理框架
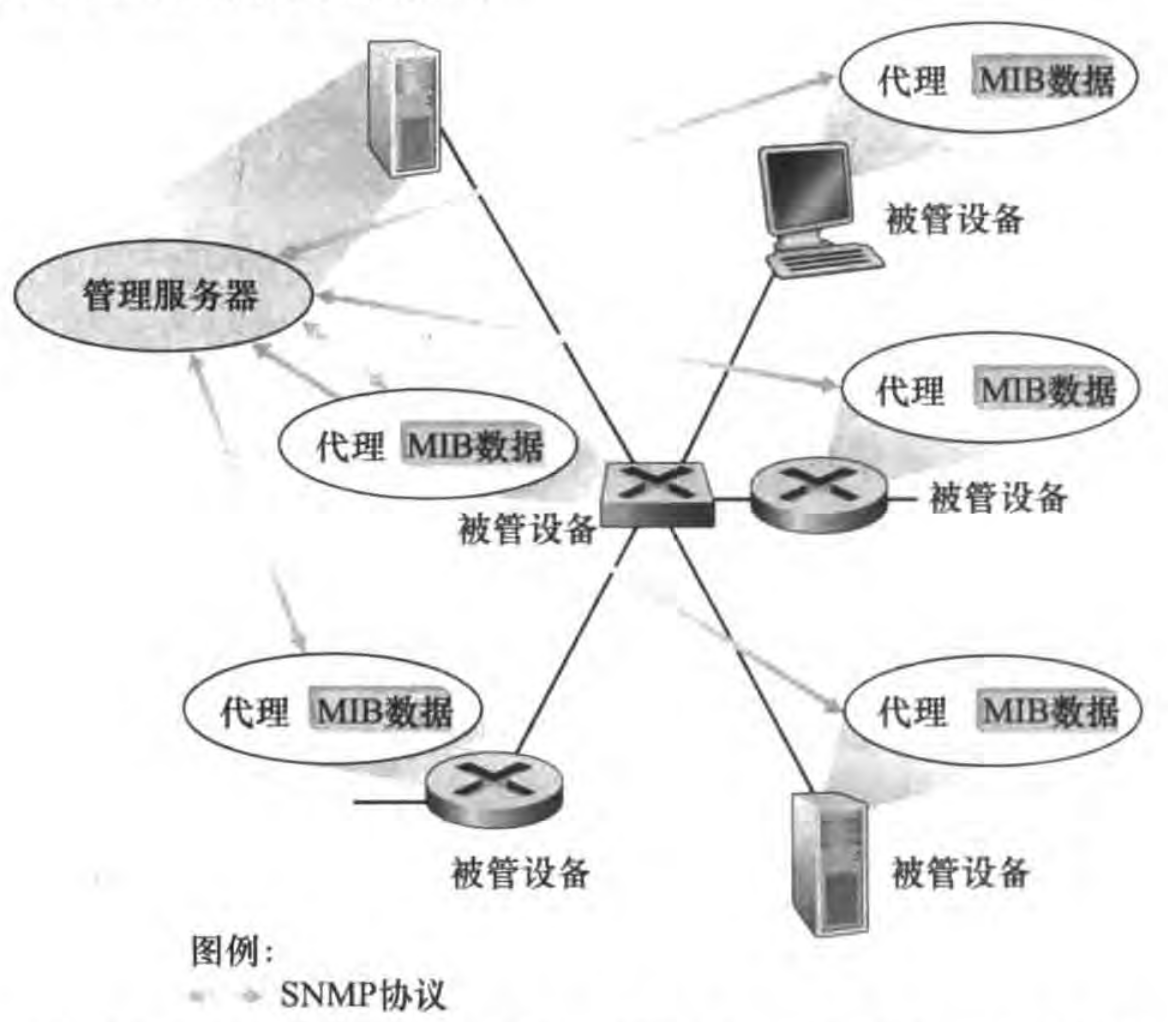
标准网络管理框架主要由五个核心支柱构成:
- 管理服务器(Managing Server):运行在网络运营中心(NOC)的集中式网络管理工作站上,执行中心化的监控与控制活动;
- 被管设备(Managed Device):运行在受控网络中的路由器、交换机、主机等网元。一个被管设备包含几个被管对象(Managed Object),被管对象可以是被管设备中硬件的实际部件或用于这些软硬件组件的运行配置参数;
- 管理信息库(Management Information Base, MIB):集中收集被管设备中每个被管对象的关联信息,MIB 对象由称为 SMI(Structure of Management Information)的数据描述语言严格定义;
- 网络管理代理(Network Management Agent):运行在各被管设备内部的受控进程,与管理服务器通信,并在管理服务器的命令和控制下在被管设备中采取本地动作;
- 网络管理协议(Network Management Protocol):规范管理服务器与代理之间控制和信息报文传递的通信协议。
简单网络管理协议(SNMP)
简单网络管理协议(Simple Network Management Protocol, SNMP)是位于应用层的标准化网络管理协议,用于在管理服务器和设备代理之间传递控制与监控报文。
在工作模式上,SNMP 最常使用的是请求-响应模式:管理服务器向代理发送请求报文,代理收到后执行相应动作并回送响应。此外,当发生紧急异常导致 MIB 对象值异常改变时,代理会主动向服务器异步发送 陷阱报文(Trap Message) 以迅速通报异常。
SNMP 定义的协议数据单元(PDU)报文类型如下:
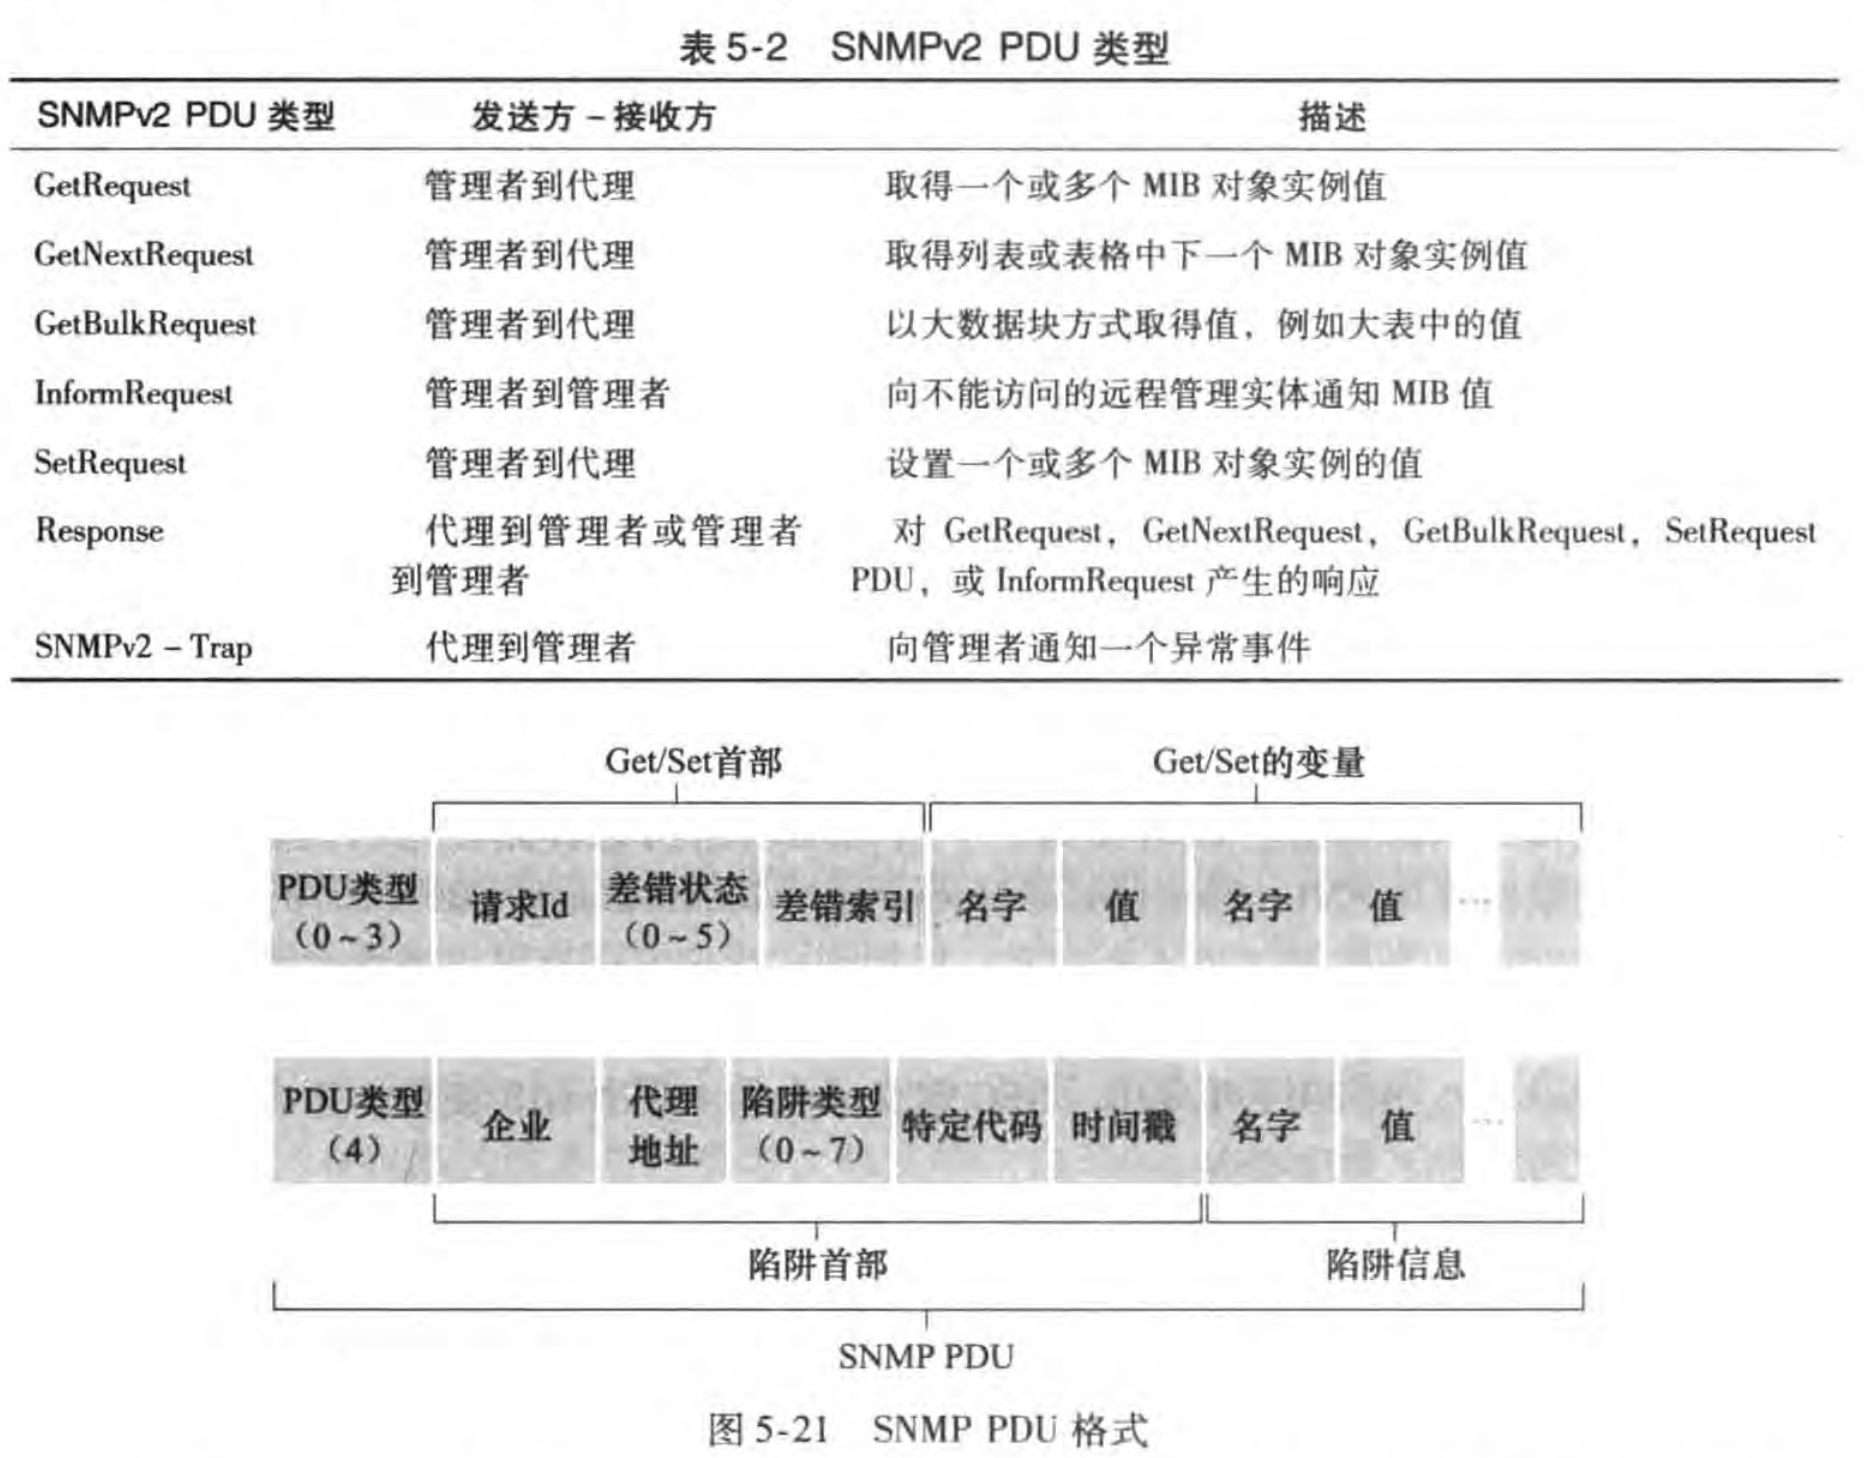
GetRequest、GetNextRequest和GetBulkRequestPDU:均由管理服务器向代理发起,用于查询一个或多个 MIB 对象值;SetRequestPDU:由管理服务器发出,用于远程设置被管设备的一个或多个 MIB 对象值;代理执行后回复带有noError的 Response PDU 进行确认;InformRequestPDU:用于两个不同 MIB 信息管理服务器之间的管理协作;Trap报文:当特定突发事件被触发时由代理异步生成并主动上报给管理服务器。