运输层
运输层服务,多路复用与分解、UDP、可靠数据传输、TCP 和拥塞控制
概述和运输层服务
运输层协议负责为运行在不同主机上的应用进程之间提供 逻辑通信(Logical Communication) 功能。所谓逻辑通信,是指从应用进程的视角来看,彼此之间就像是通过物理导线直接相连一样,无需关心底层物理网络的路由器跳数和拓扑细节。
运输层协议只在端系统(主机)中实现,网络核心的路由器并不会处理运输层首部:
- 发送端:运输层接收来自应用层进程的报文,将其封装为运输层报文段(Segment),然后传递给网络层。网络层将其进一步封装为网络层分组(IP 数据报)并在网络核心中逐跳转发。
- 接收端:网络层从 IP 数据报中剥离出运输层报文段,向上交付给运输层;运输层检查并提取其中的应用层报文,定向送达对应的目的进程。
网络层与运输层的本质分工: 网络层提供的是 主机到主机(Host-to-Host) 的通信,负责将分组从一台源主机运送到目的主机;而运输层在此基础上建立起 进程到进程(Process-to-Process) 的通信,负责将数据准确分发至各个具体的应用程序套接字。
因特网运输层协议全貌
因特网为应用层提供了两种差异鲜明的运输层协议:
- UDP(用户数据报协议):提供轻量级、无连接、不可靠的尽力而为服务。
- TCP(传输控制协议):提供面向连接、可靠有序且具备流量控制与拥塞控制的完备数据流服务。
IP 协议的底层限制: 底层的网际协议(IP)提供的是尽力而为交付服务(Best-Effort Delivery Service),既不保证数据报一定能成功交付,也不保证按序到达,更不保证报文内容中比特的完整性,本质上属于不可靠信道。
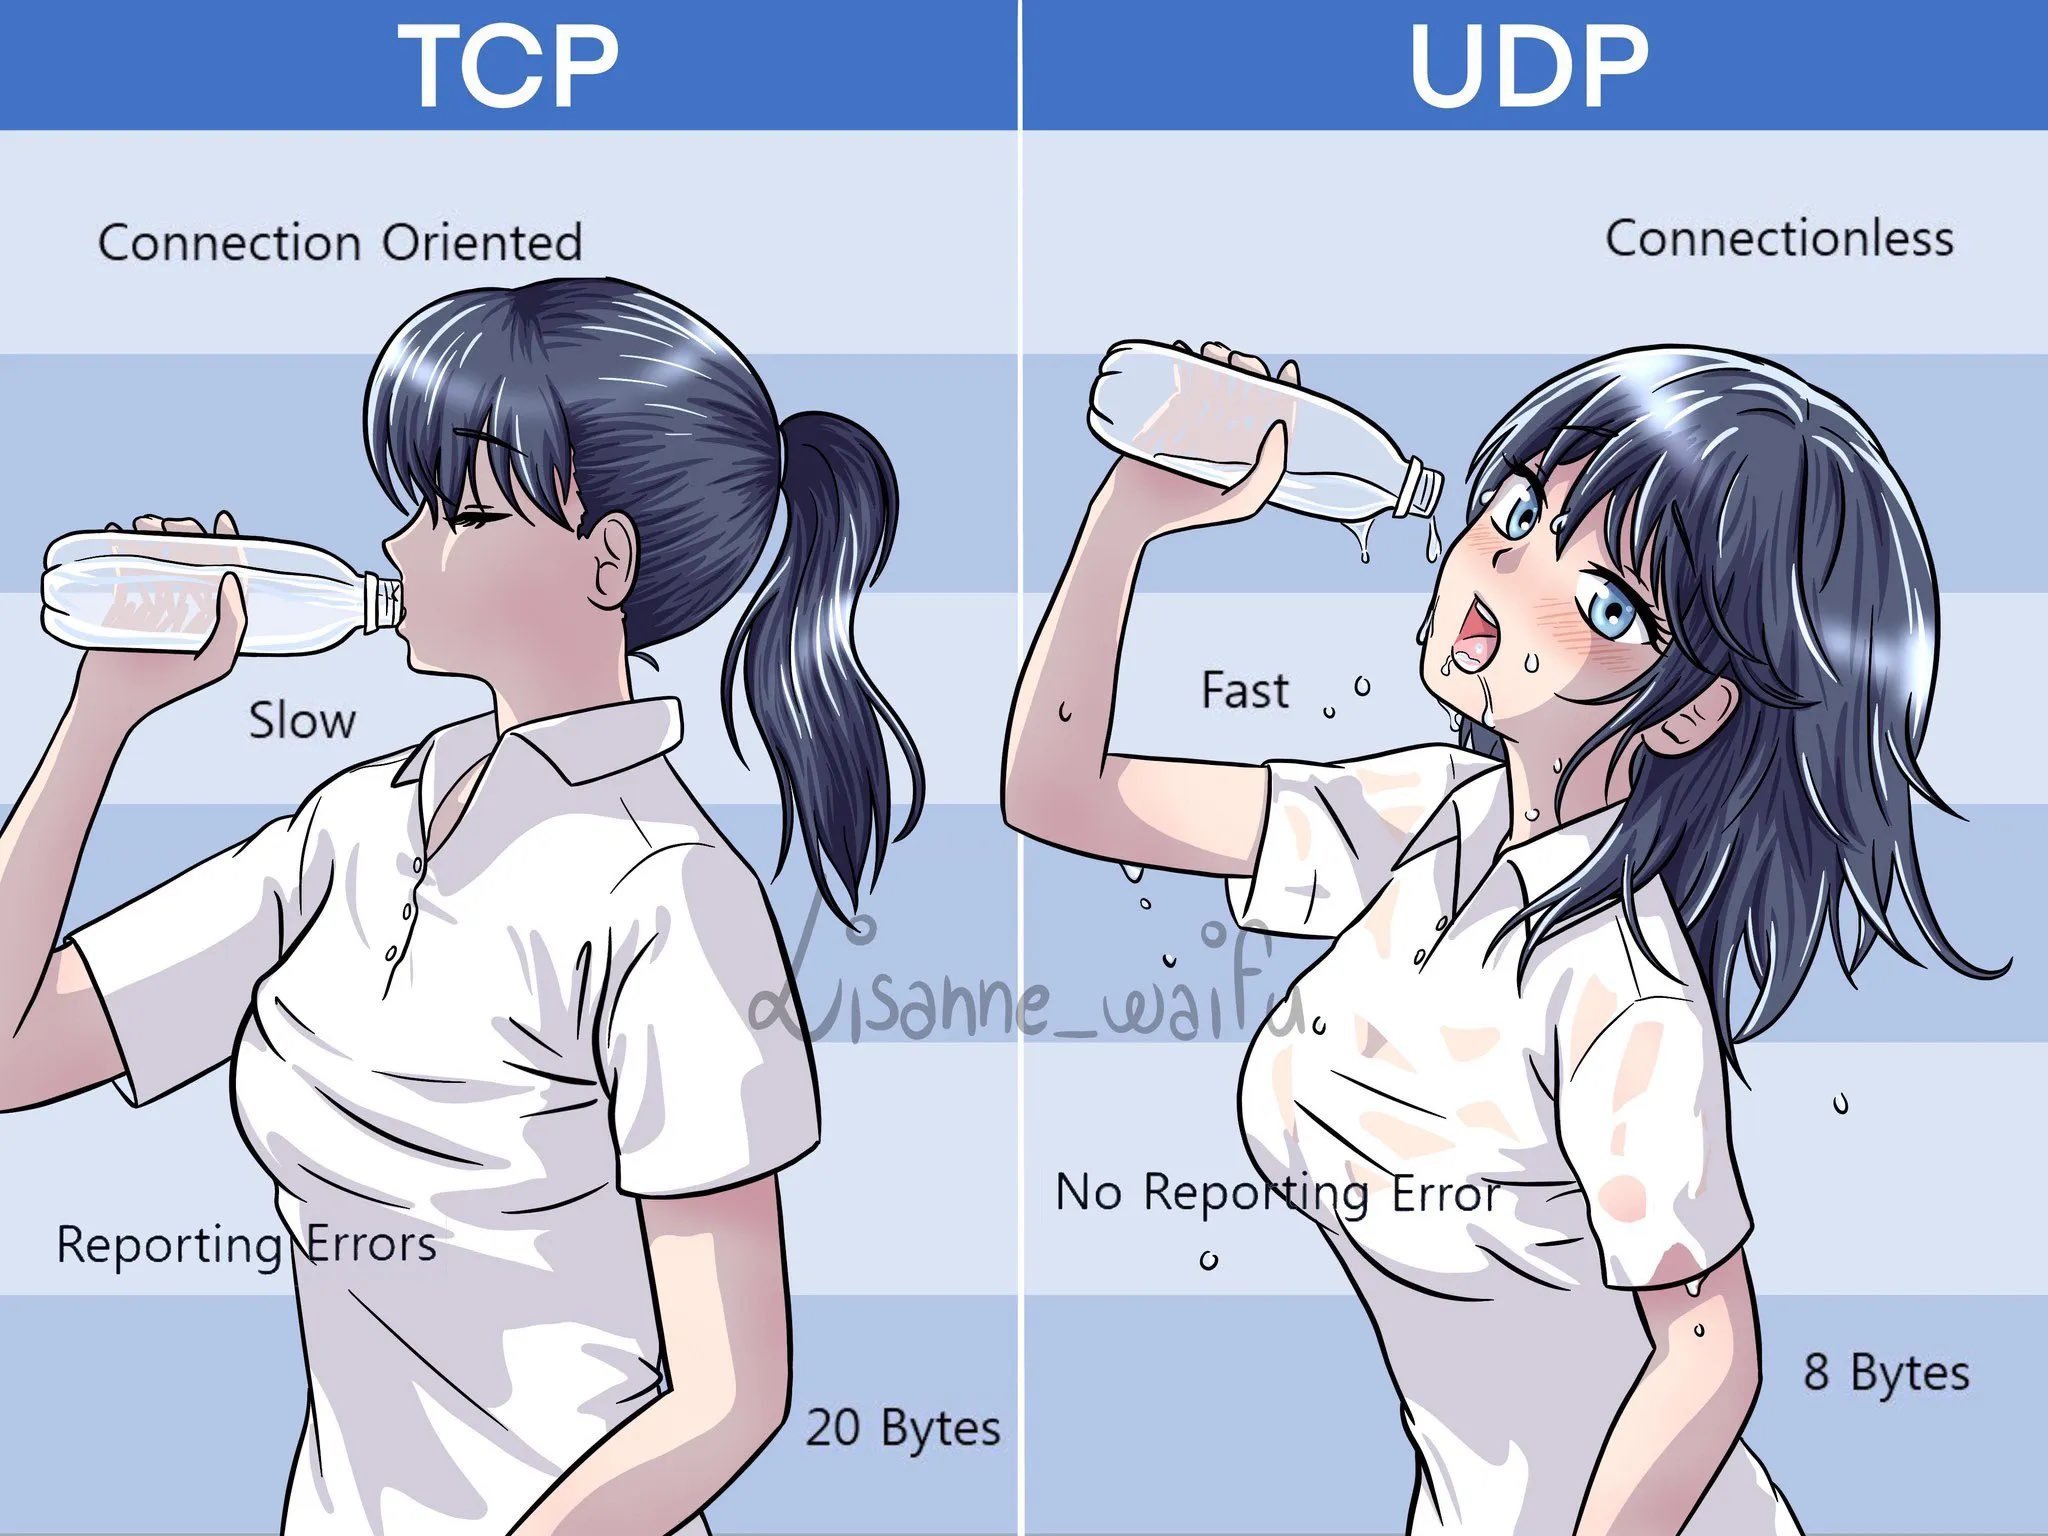
TCP 与 UDP 在不可靠的 IP 服务之上,最基础的共同职责是将“主机间交付”扩展为“进程间交付”(即多路复用与多路分解),并通过报文段首部的校验和字段提供基础的比特差错校验。在此之上,TCP 进一步引入序号、确认、重传定时器以及拥塞窗口机制,构建了严格可靠的字节流交付系统。
多路复用与多路分解
在实际运行中,一台主机上往往同时并发运行着数十个网络进程。运输层并没有直接将数据报文丢给进程,而是通过中间的 套接字(Socket) 进行中转。每一个处于活动状态的套接字均拥有唯一的标识符(即端口号):
- 多路分解(Demultiplexing):接收端运输层检查传入报文段中的首部字段,将数据正确分发到与其匹配的目的套接字。
- 多路复用(Multiplexing):发送端运输层从不同的应用套接字收集数据块,为每个数据块封装上包含源/目的端口等信息的运输层首部生成报文段,并将报文段逐一传递给网络层。
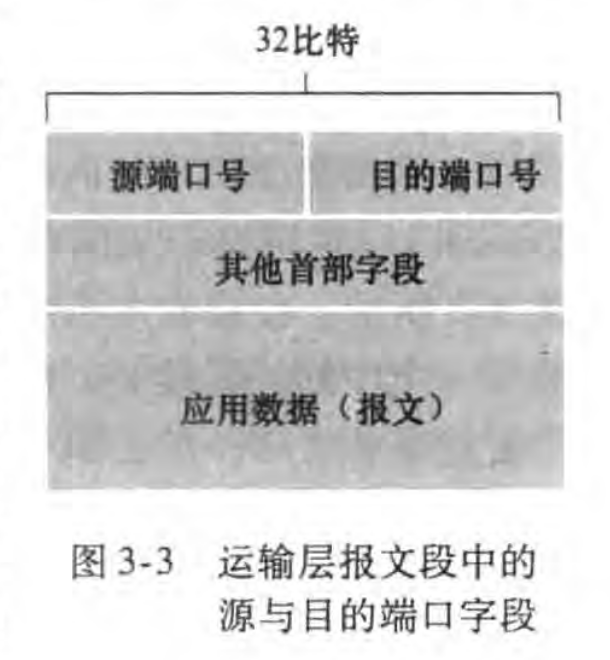
端口号为 16 比特的无符号整数(范围 0 ~ 65535)。其中 0 ~ 1023 为熟知端口号(Well-Known Port Number)(RFC 3232),严格保留给标准应用层协议使用(如 HTTP 80、HTTPS 443、SMTP 25、DNS 53)。客户端套接字的端口号通常由操作系统在发起连接时透明动态分配(临时端口),而服务器端则绑定固定的周知端口。
无连接的多路复用与分解(UDP)
一个 UDP 套接字仅由一个二元组唯一标识:(目的 IP 地址, 目的端口号)。
当主机收到一个 UDP 报文段时,操作系统只需检查该报文段的目的端口号,并将其直接导向监听该端口的套接字。即使两个到达的 UDP 报文段拥有不同的源 IP 地址或源端口号,只要它们的目的 IP 和目的端口相同,就会被递交至同一个套接字进程。报文段中的源端口号主要作为“返回地址”,便于接收端在回信时将其填入目的端口。
面向连接的多路复用与分解(TCP)
与 UDP 不同,一个 TCP 套接字由一个严格的四元组全面标识:(源 IP 地址, 源端口号, 目的 IP 地址, 目的端口号)。
当 TCP 报文段到达主机时,系统必须同时匹配这四个字段才能将其定向至对应的连接套接字。两条来自不同客户端、或来自同一客户端不同端口的连接,即便连接到服务器相同的目标端口(如 80),服务端也会为其创建独立的专属套接字。
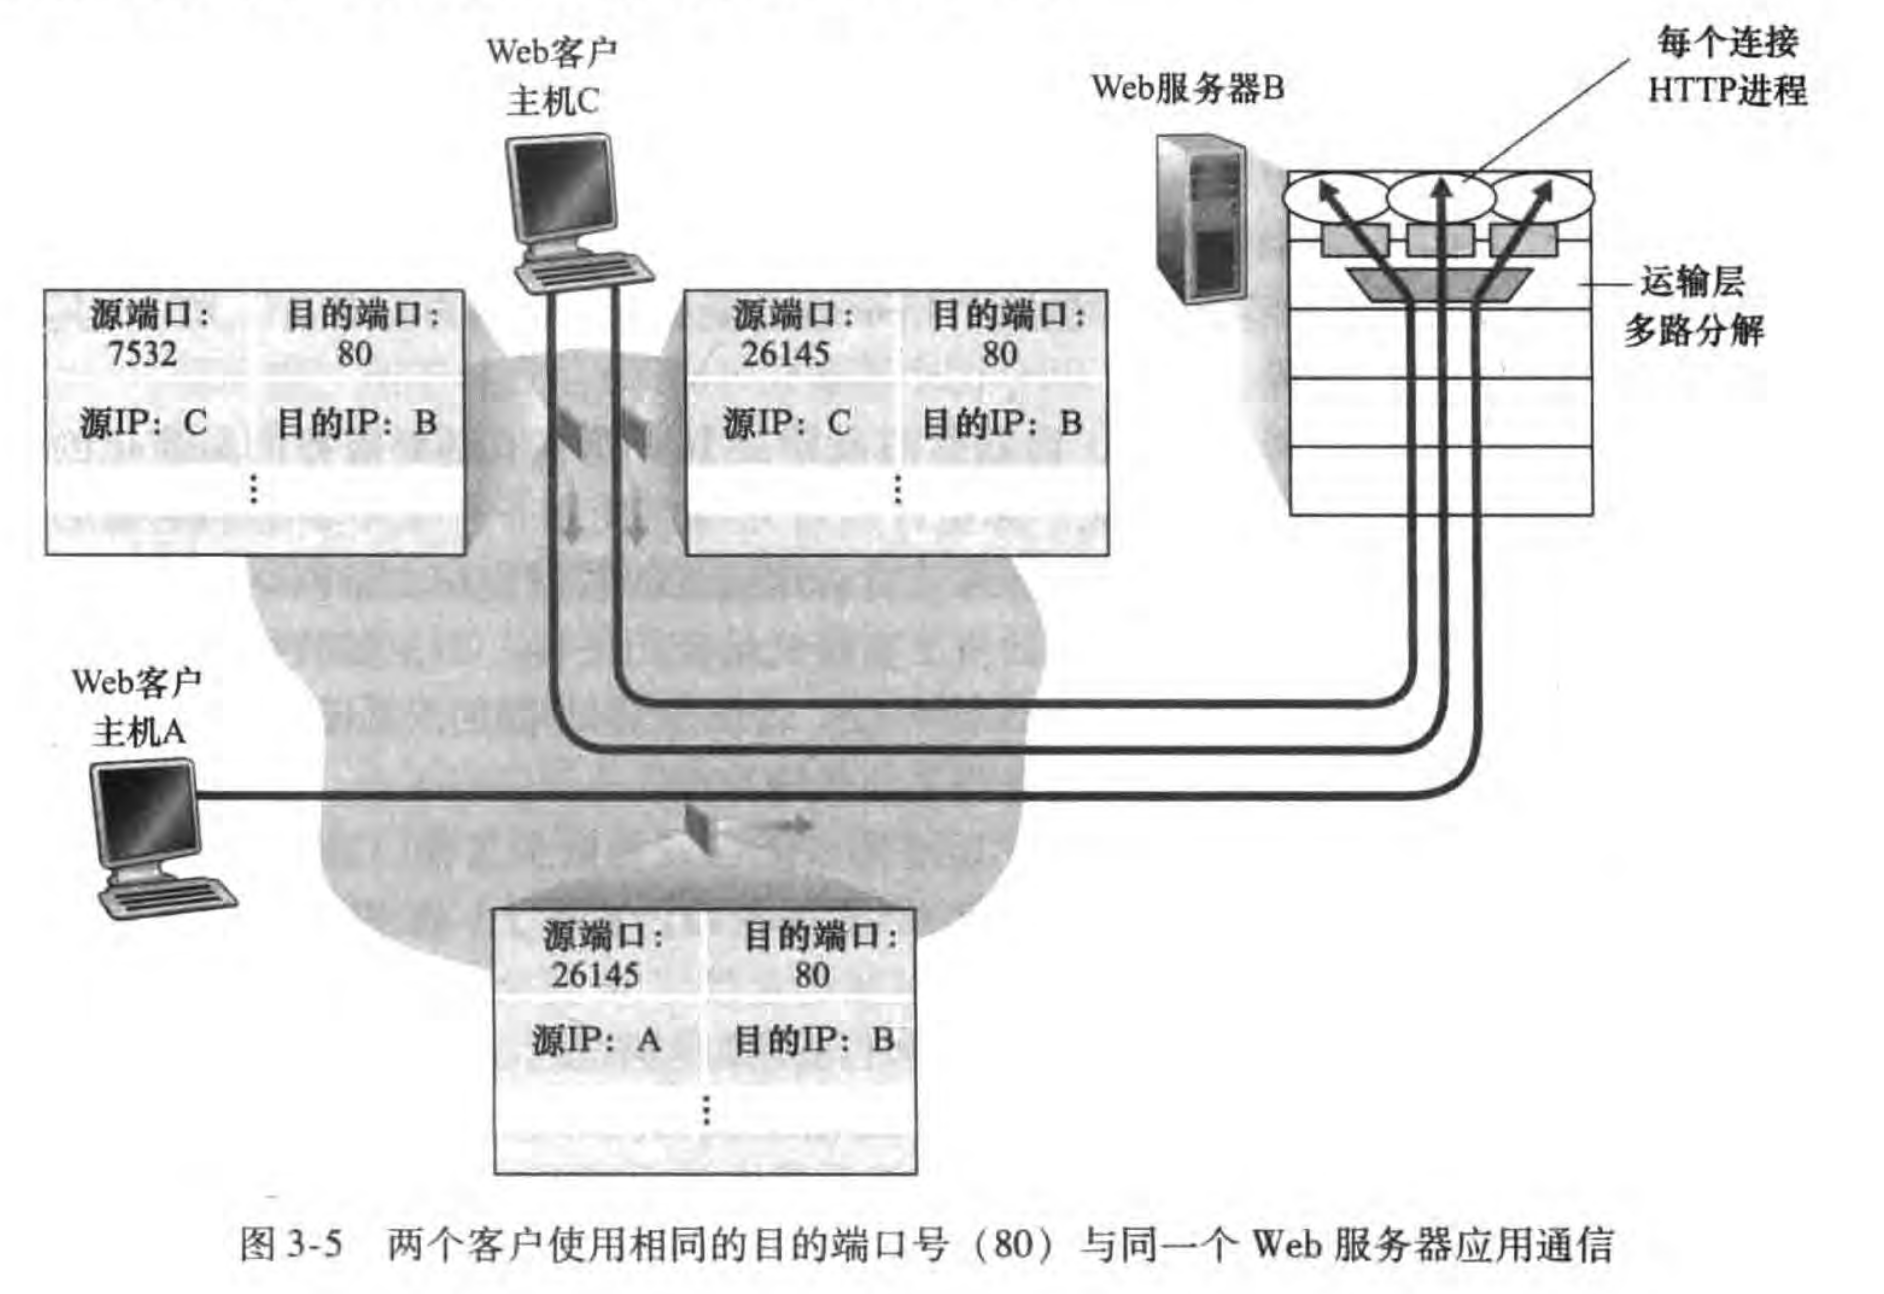
针对成千上万的高并发连接,服务器通常采用不同的并发处理架构:
- 多进程模型(Forking):每接受一个新连接,通过
fork()创建子进程独立处理。 - 多线程模型(Threading):为每个活动连接分配或复用工作线程。
- 事件驱动与异步 IO 模型(Event-Driven / Async IO):基于操作系统的非阻塞 IO 与多路复用机制(如
epoll、kqueue、io_uring),利用单一或少量事件循环线程高效管理海量套接字连接。
无连接运输:UDP
UDP 只在 IP 协议之上做了极少量的增量封装(主要是端口多路复用以及轻量级的首部校验),许多应用之所以倾向于选择 UDP,是因为其具备以下显著优势:
- 精细化的发送控制:一旦应用把数据注入套接字,UDP 立即将其封装打包并推入网络层,不会像 TCP 那样受制于拥塞控制与重传队列而推迟发送(这对容忍部分丢包但追求极致实时的音视频应用至关重要)。
- 零握手时延:无连接特性避免了 TCP 三次握手的往返时延(例如 DNS 解析使用 UDP 可直接在一个 RTT 内完成问答)。
- 无连接状态开销:服务器无需为每个客户端分配连接状态变量、收发缓冲区和序号跟踪,单机并发承载能力远高于 TCP。
- 首部开销极小:每个 UDP 报文段仅有固定的 8 字节首部,而 TCP 首部在无选项时也有 20 字节。
UDP 报文段结构与检验和
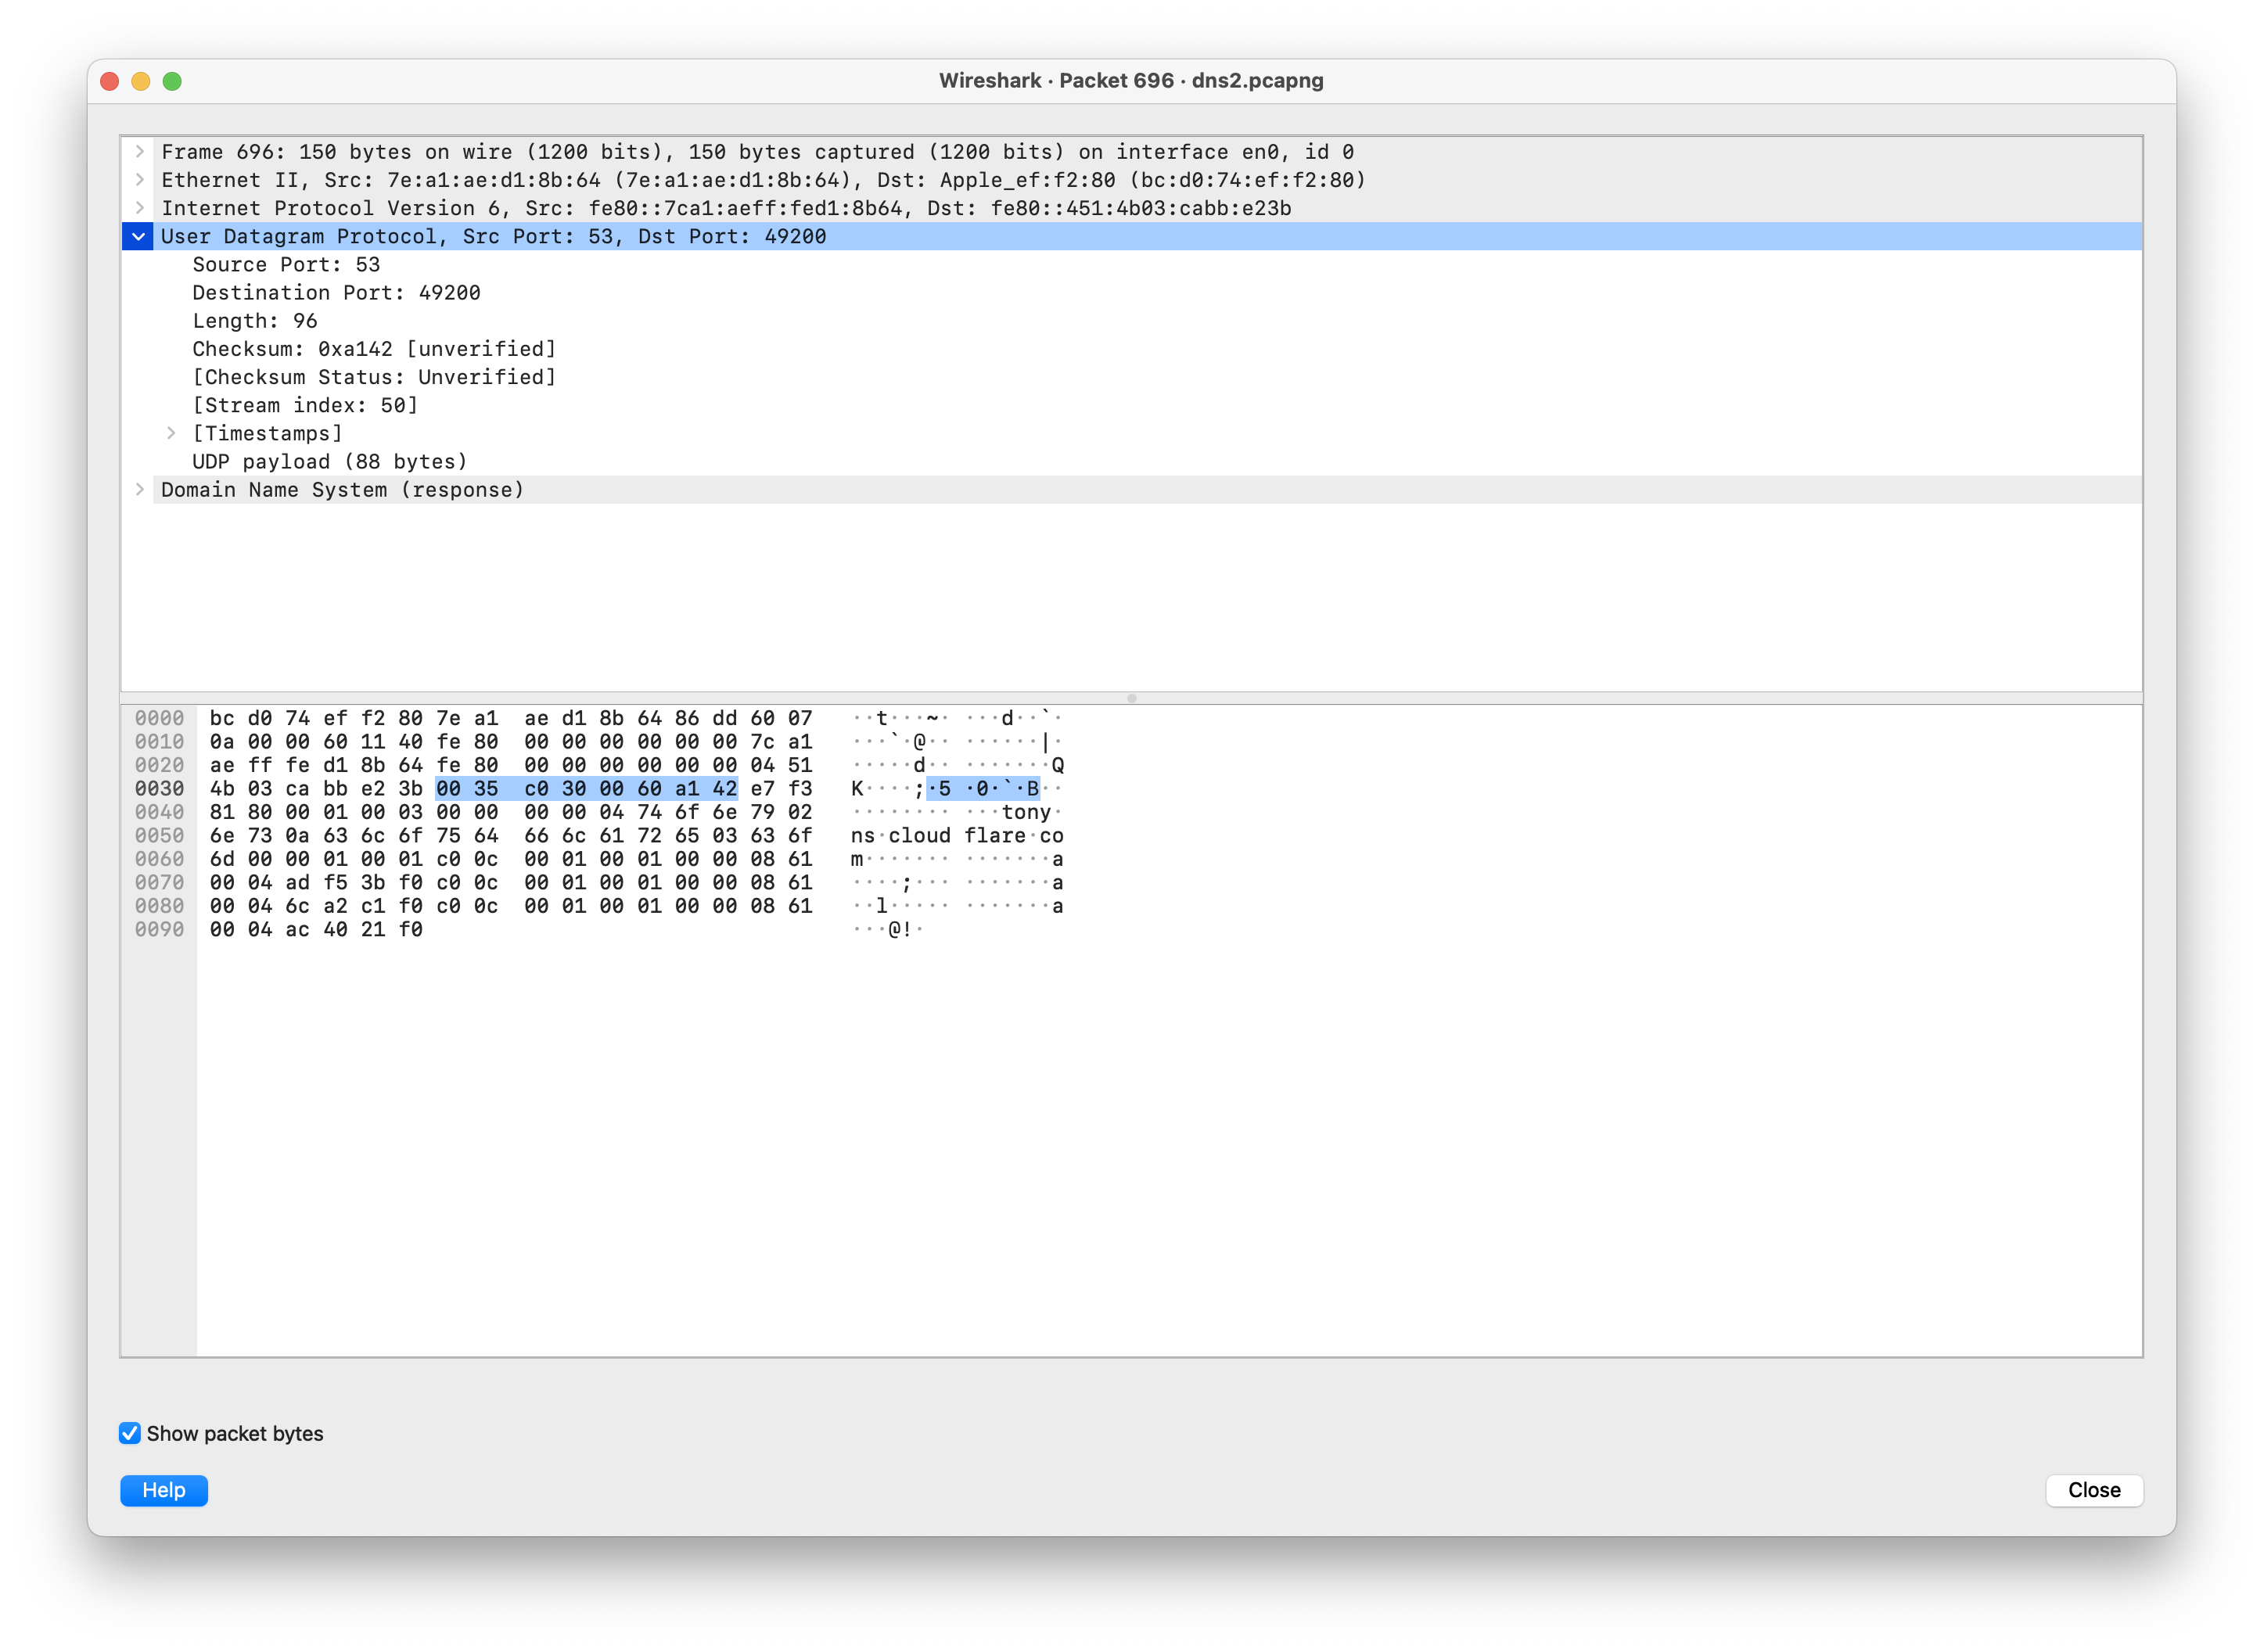
UDP 首部仅由四个字段构成(各占 2 字节):源端口号、目的端口号、长度(包含首部与数据的总字节数)与检验和。
- 因特网检验和:发送端将 UDP 报文段中所有 16 比特字(包括伪首部、首部和数据)按二进制反码算术累加求和,再对累加结果取反码存入检验和字段。接收端对所有 16 比特字再次累加(若无差错,结果应当全为 1)。
- 尽管许多链路层提供了 CRC 硬件检错,但在端到端路径上的路由器内存、交换机转发表或主机总线中仍可能发生内存位翻转或软件 Bug,这体现了著名的端到端原则(End-to-End Principle)——低层提供的机制不能完全替代高层的终极端到端可靠性校验。
可靠数据传输原理
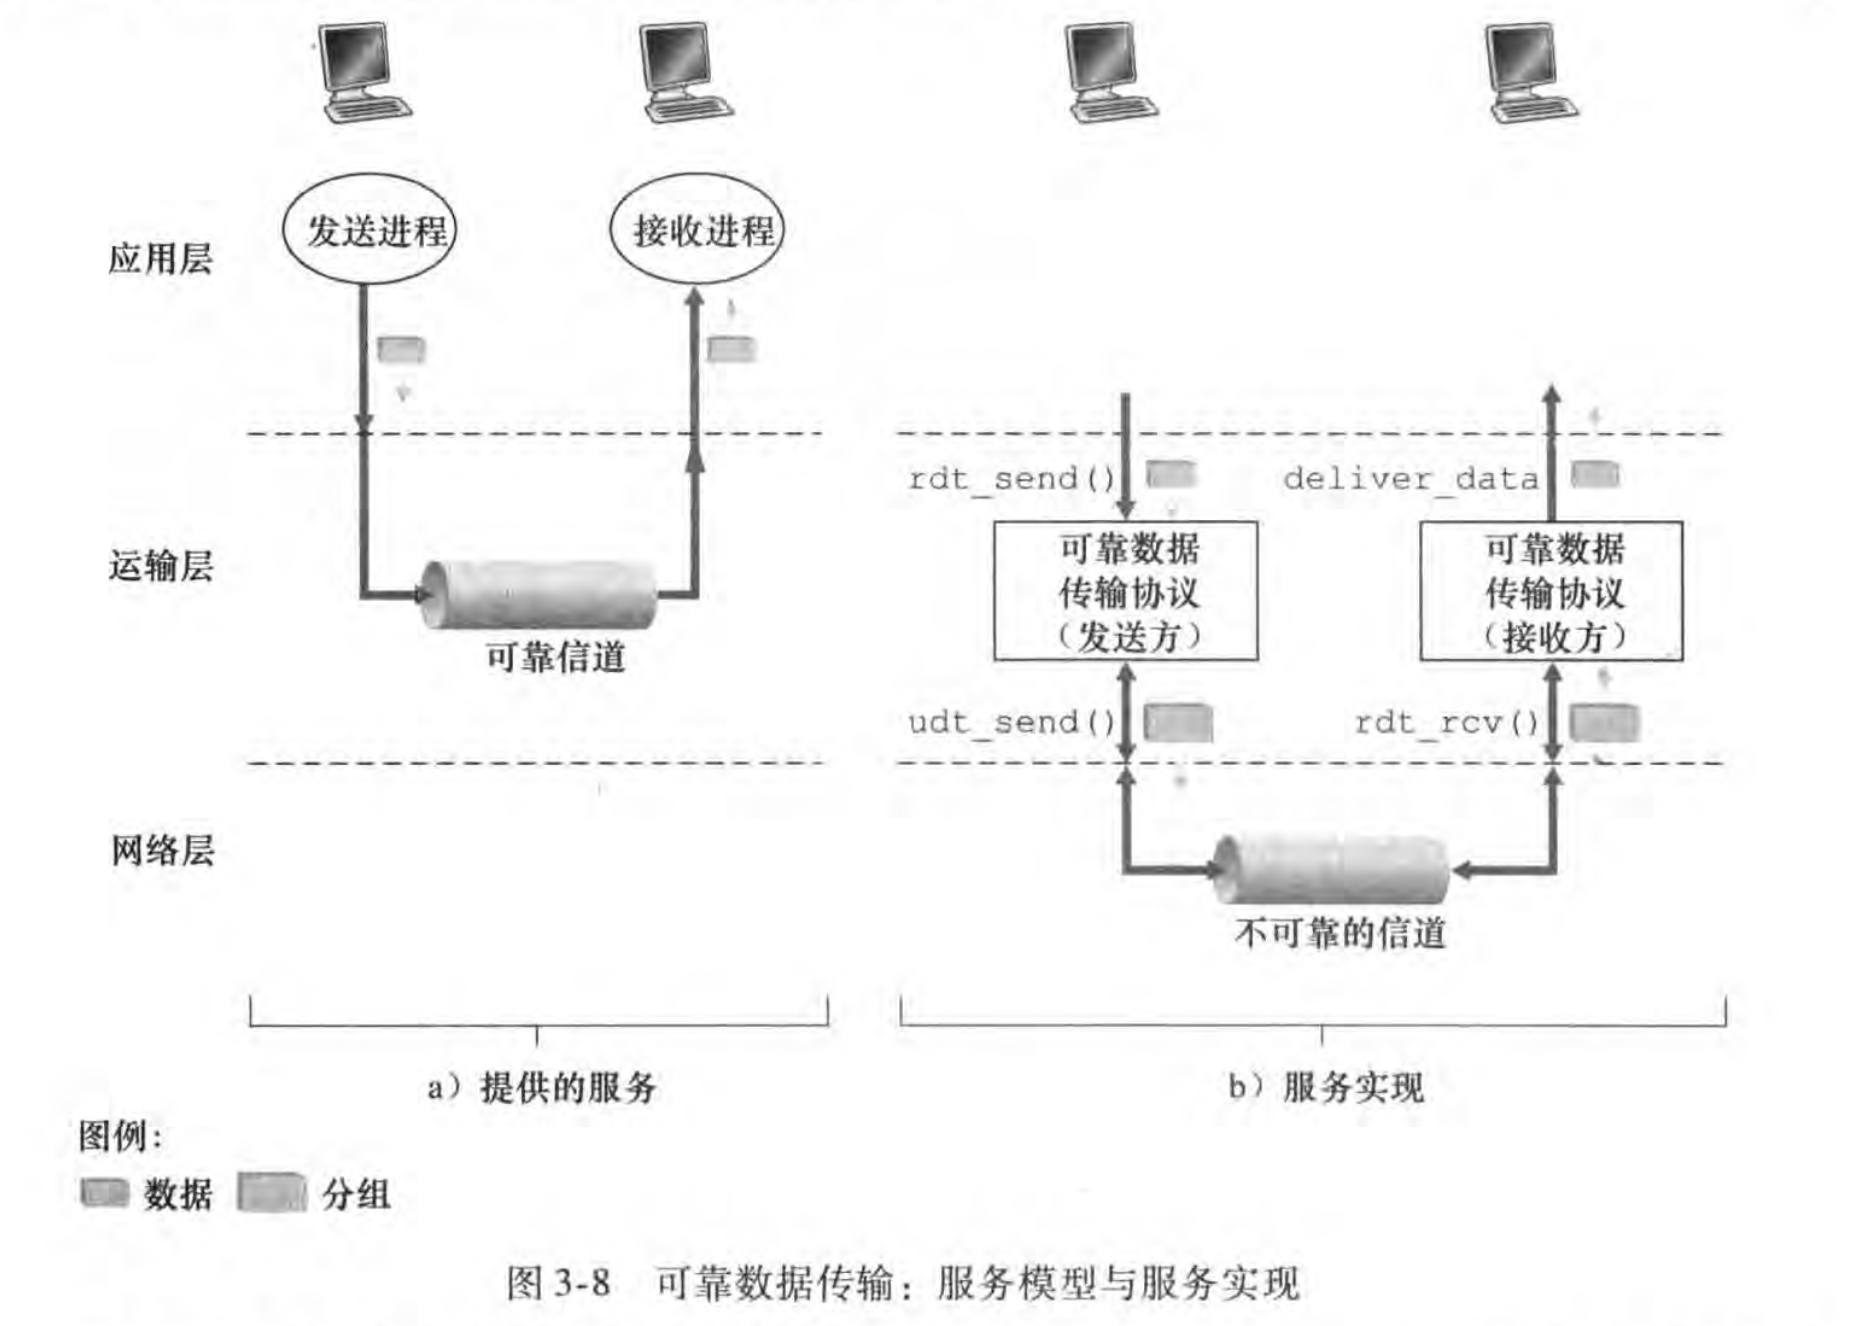
可靠数据传输协议的核心职责,是将底层可能发生比特损伤、分组丢失或乱序的物理信道,向上层抽象封装为一条无比特差错、无数据丢失、严格保序的虚拟可靠信道。
为简化分析,我们首先考察单向数据传输(Unidirectional Data Transfer)的模型演进(控制分组需双向传递),并借助 有限状态机(Finite-State Machine, FSM) 逐步推导演进。
构造可靠传输协议:rdt 的演进
1. 完全可靠信道:rdt 1.0
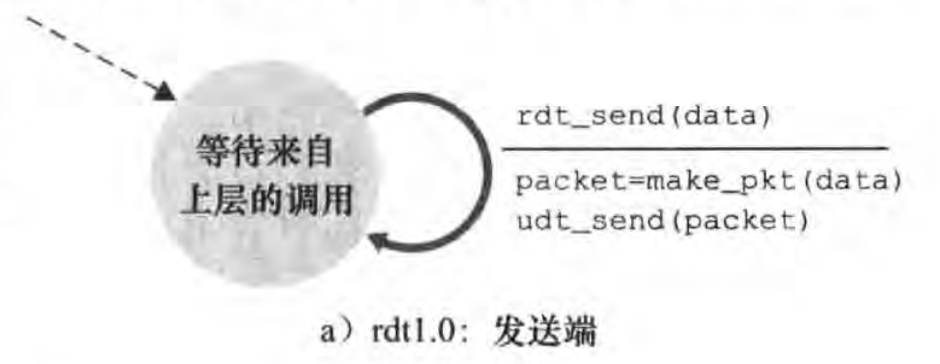
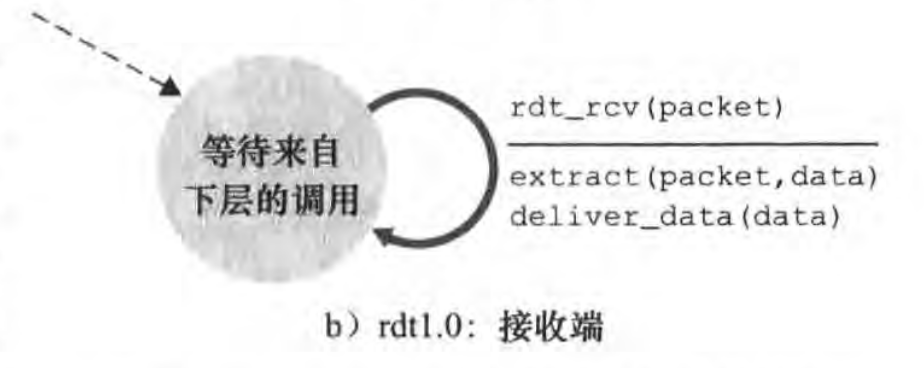
在底层信道百分百可靠(无差错、无丢包、保序)的理想假设下,发送方与接收方均只有一个状态:发送端等待上层调用打包并直接下发,接收端等待下层分组到来解包交付即可。
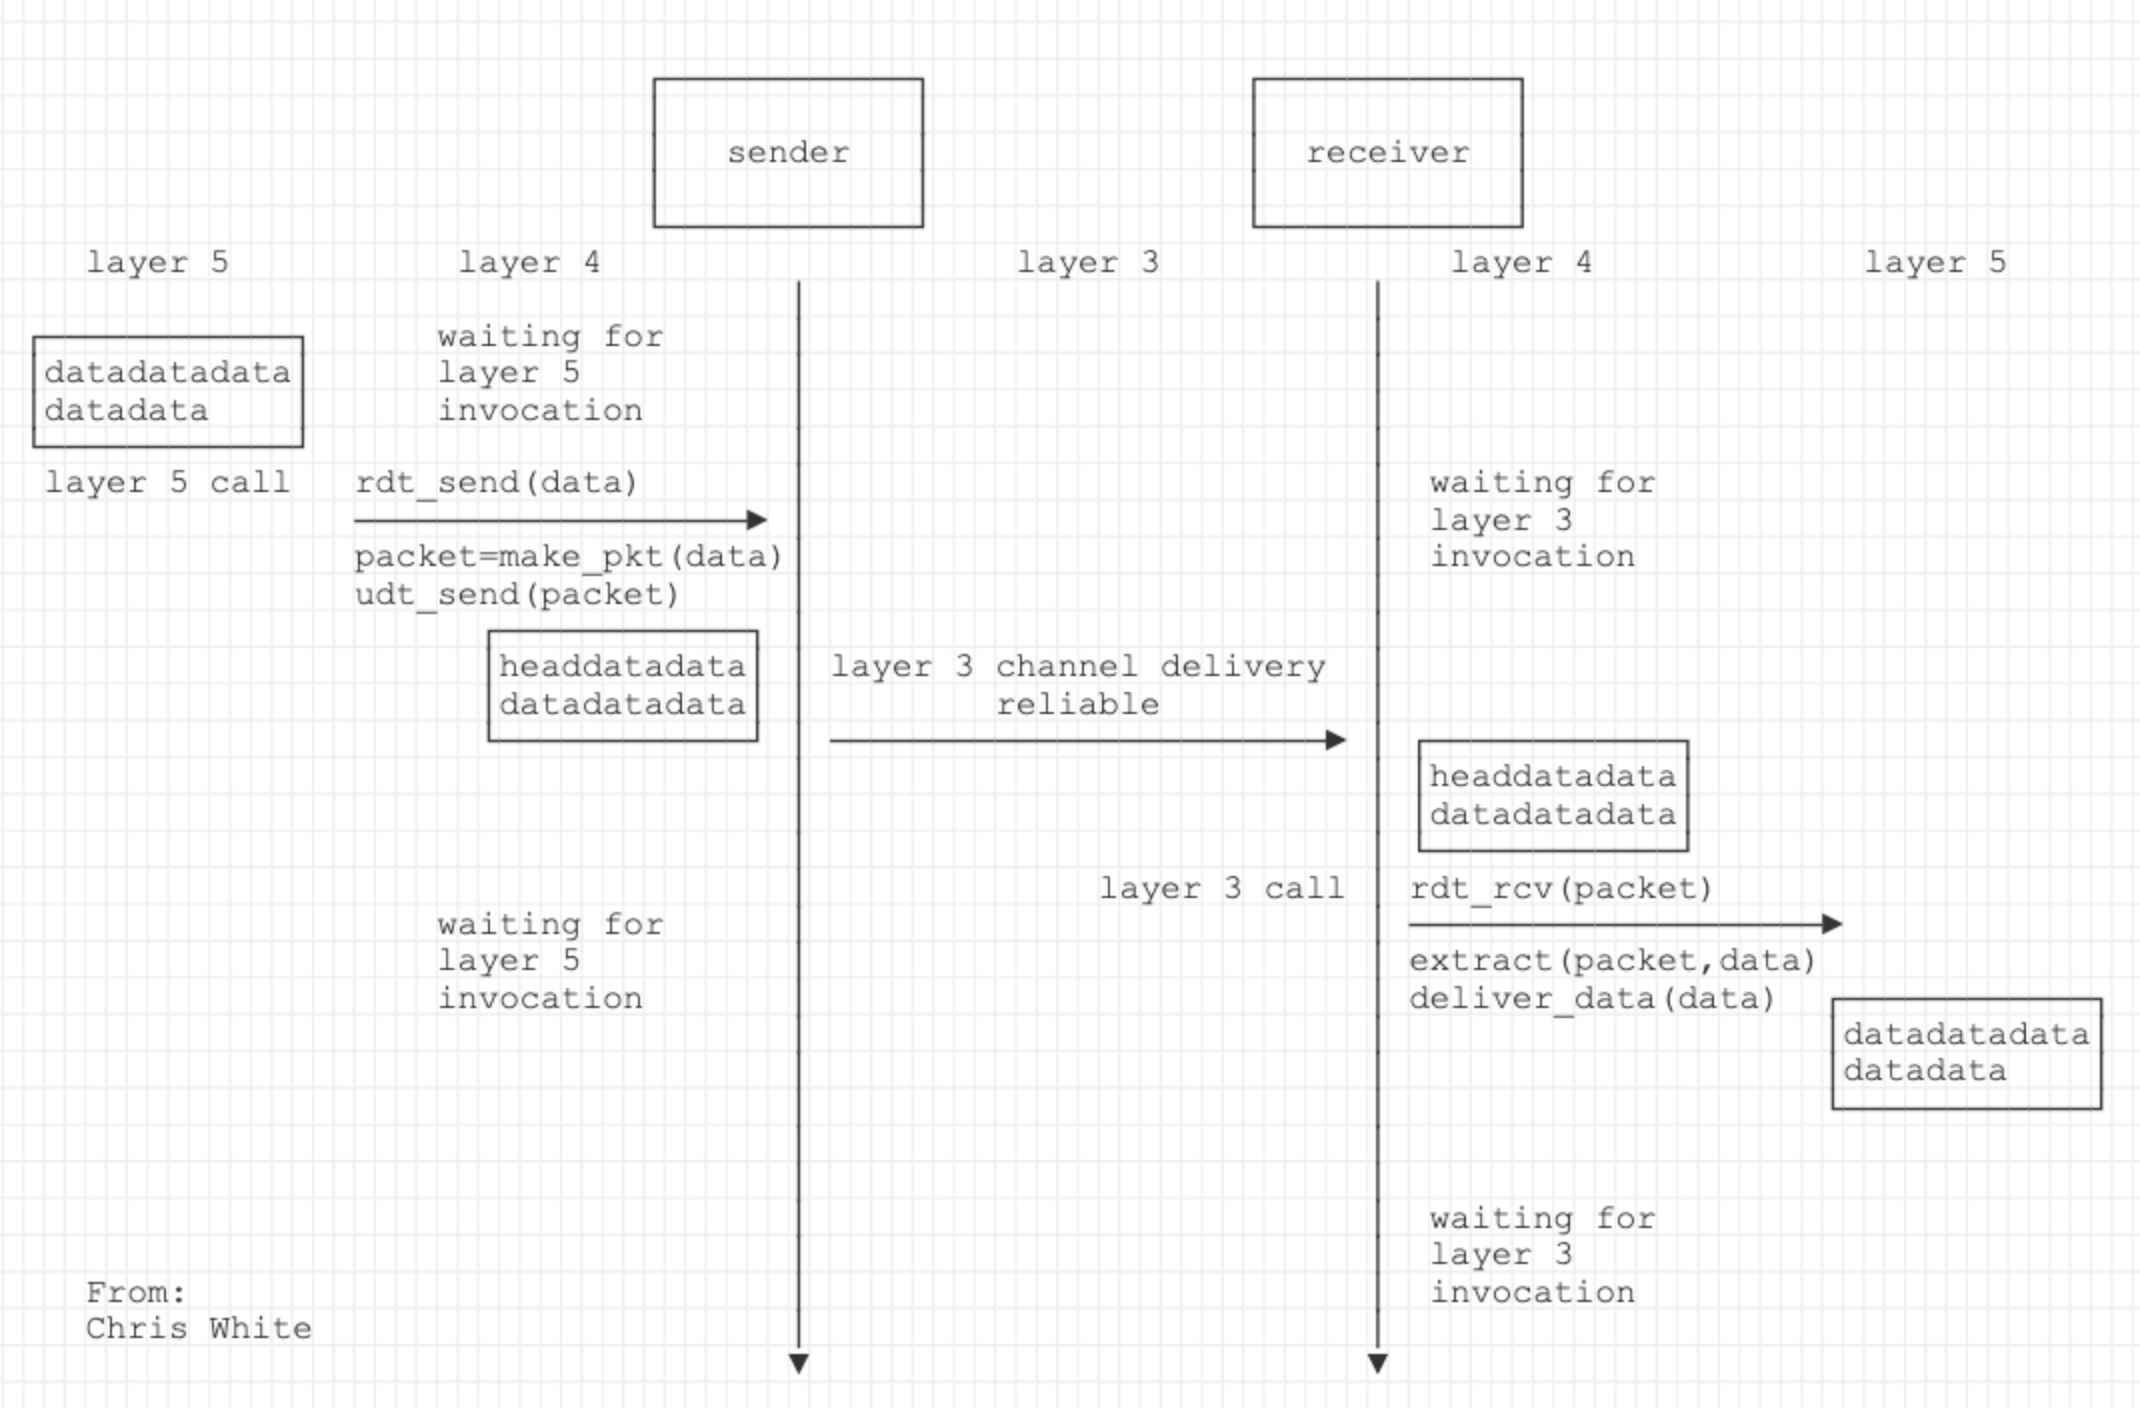
                              ┌────────────┐               ┌────────────┐
                              │            │               │            │
                              │   sender   │               │  receiver  │
                              │            │               │            │
                              └────────────┘               └────────────┘
   layer 5           layer 4                    layer 3              layer 4             layer 5
                                     │                           │
┌────────────┐      waiting for      │                           │
│datadatadata│      layer 5          │                           │
│datadata    │      invocation       │                           │
└────────────┘                       │                           │
 layer 5 call   rdt_send(data)       │                           │  waiting for
                ───────────────────► │                           │  layer 3
                packet=make_pkt(data)│                           │  invocation
                udt_send(packet)     │                           │
                      ┌────────────┐ │                           │
                      │headdatadata│ │ layer 3 channel delivery  │
                      │datadatadata│ │         reliable          │
                      └────────────┘ │ ────────────────────────► │ ┌────────────┐
                                     │                           │ │headdatadata│
                                     │                           │ │datadatadata│
                                     │                           │ └────────────┘
                                     │              layer 3 call │ rdt_rcv(packet)
                    waiting for      │                           │ ────────────────────►
                    layer 5          │                           │ extract(packet,data)
                    invocation       │                           │ deliver_data(data)  ┌────────────┐
                                     │                           │                     │datadatadata│
                                     │                           │                     │datadata    │
                                     │                           │                     └────────────┘
                                     │                           │
                                     │                           │
                                     │                           │  waiting for
                                     │                           │  layer 3
   From:                             │                           │  invocation
   Chris White                       │                           │
                                     ▼                           ▼
2. 具有比特差错的信道:rdt 2.0、2.1 与 2.2
当底层信道可能出现比特受损(0 变 1,1 变 0)时,系统需要引入 自动重传请求(Automatic Repeat reQuest, ARQ) 机制,它包含三个支柱:
- 差错检测:通过校验和使接收端能够检测出受损分组。
- 接收端反馈:接收方显式向发送方返回肯定确认(ACK)或否定确认(NAK)。
- 重传机制:收到 NAK 时,发送方重新发送该分组。
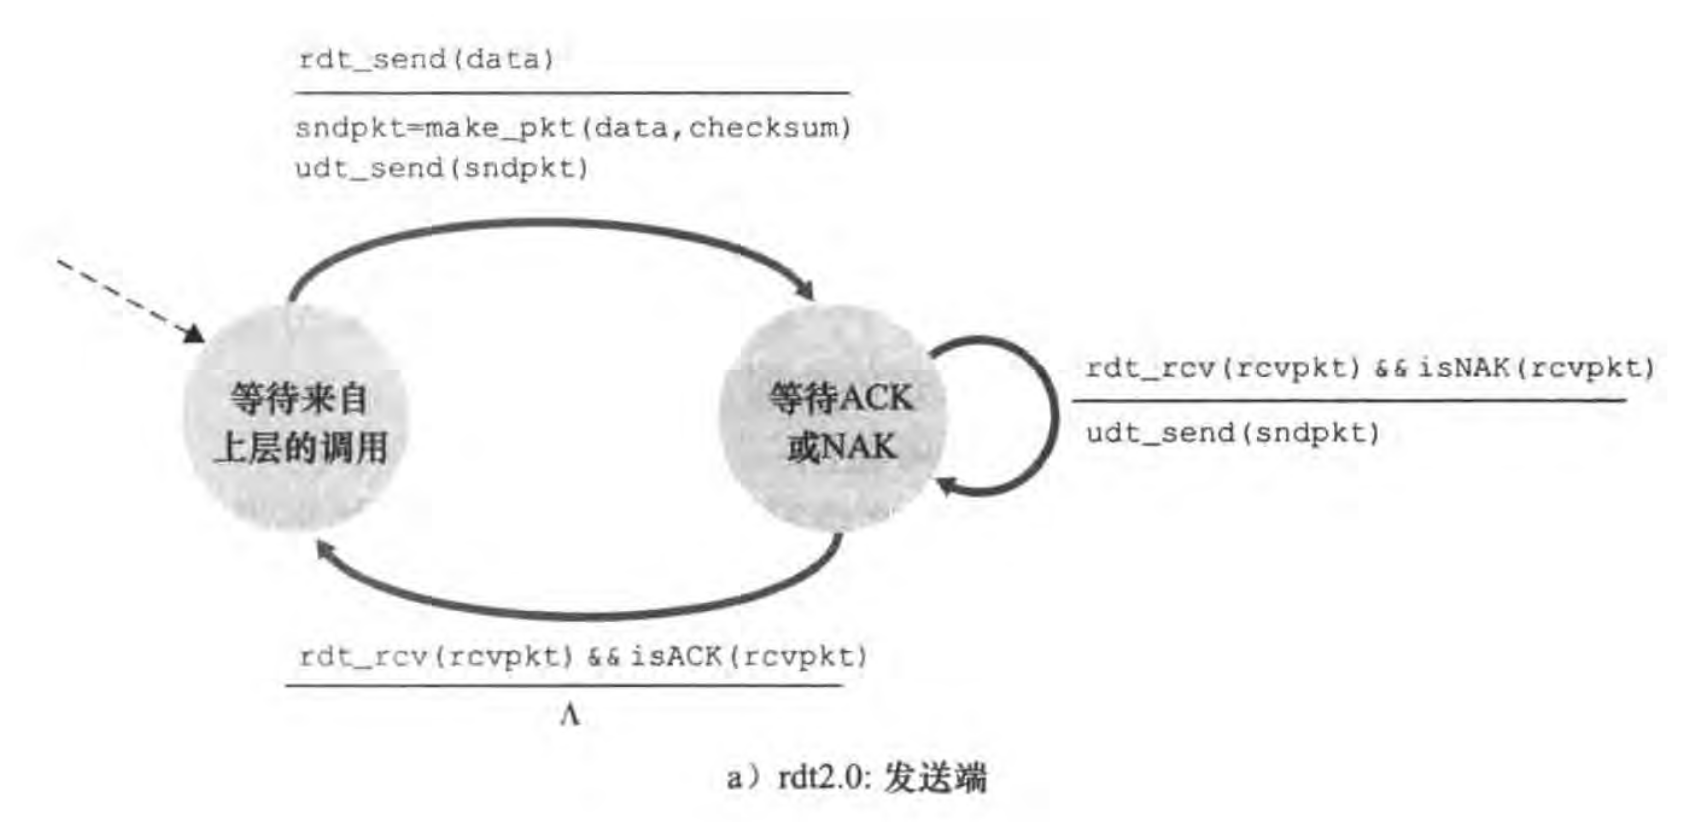
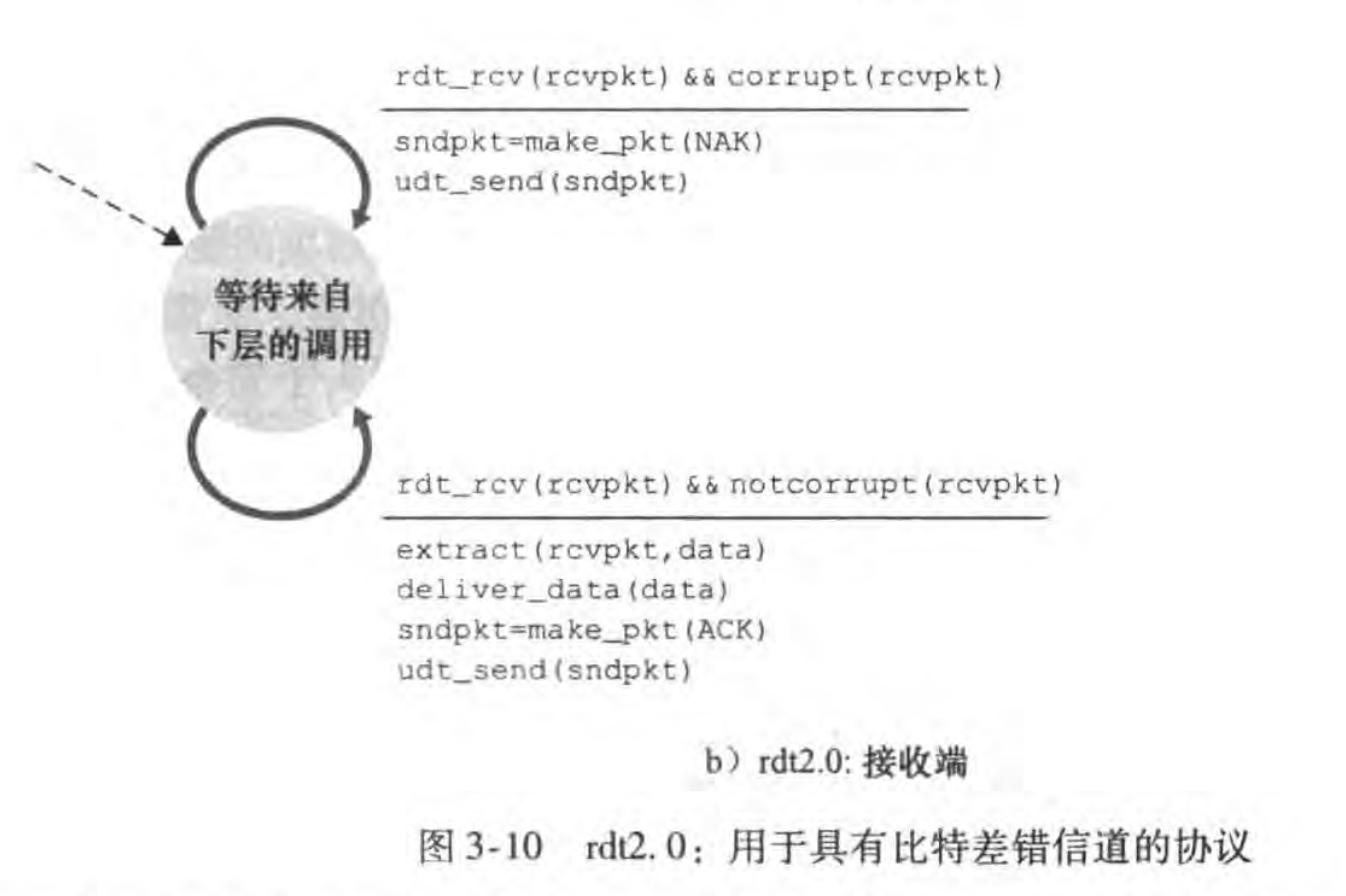
rdt 2.0 的致命缺陷: 发送方发送数据后必须停下来等待确认(停等协议,Stop-and-Wait)。但 rdt 2.0 忽视了 ACK 或 NAK 本身在回传过程中也可能受损!如果发送方收到受损的 ACK/NAK,盲目重传会导致接收端收到冗余分组(Duplicate Packet),且接收端无法分清这是重传的分组还是新数据。
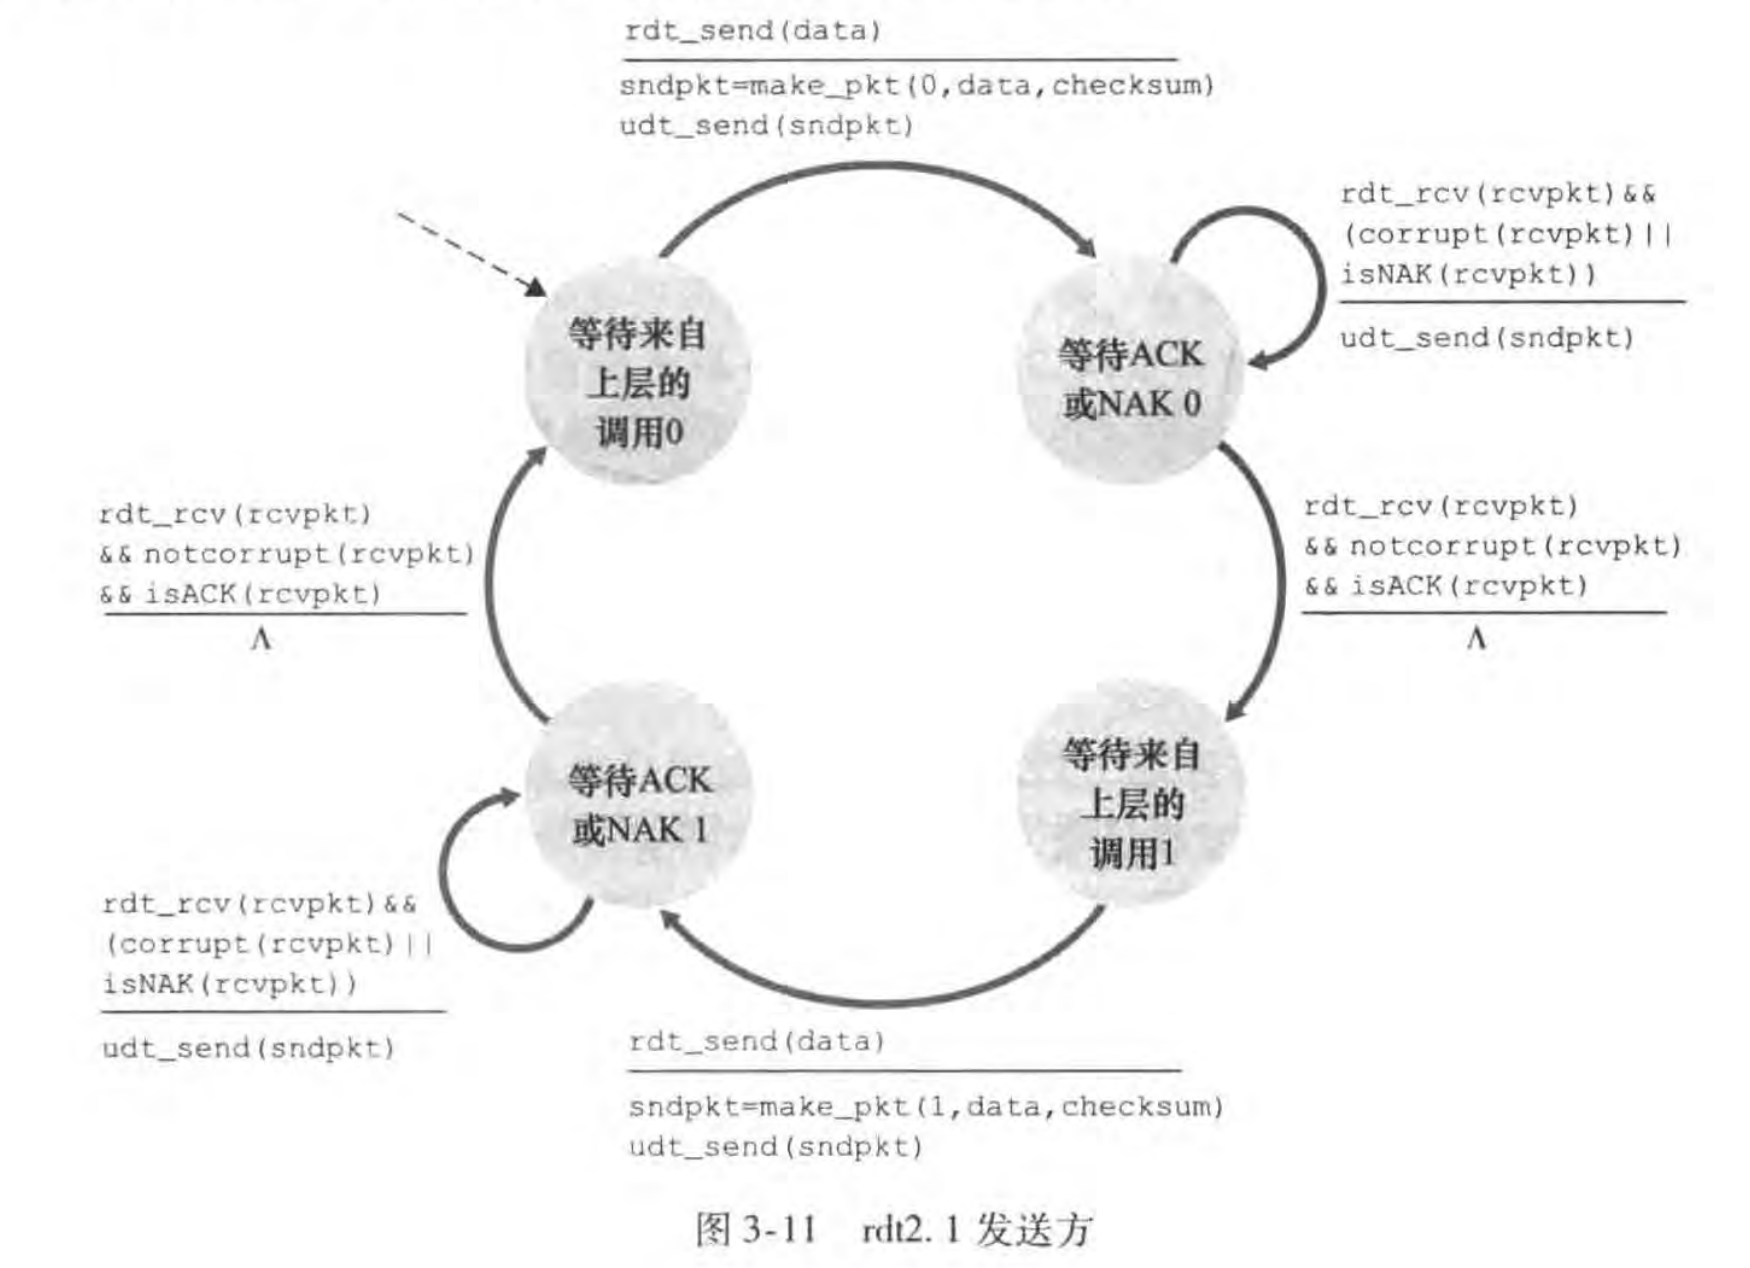
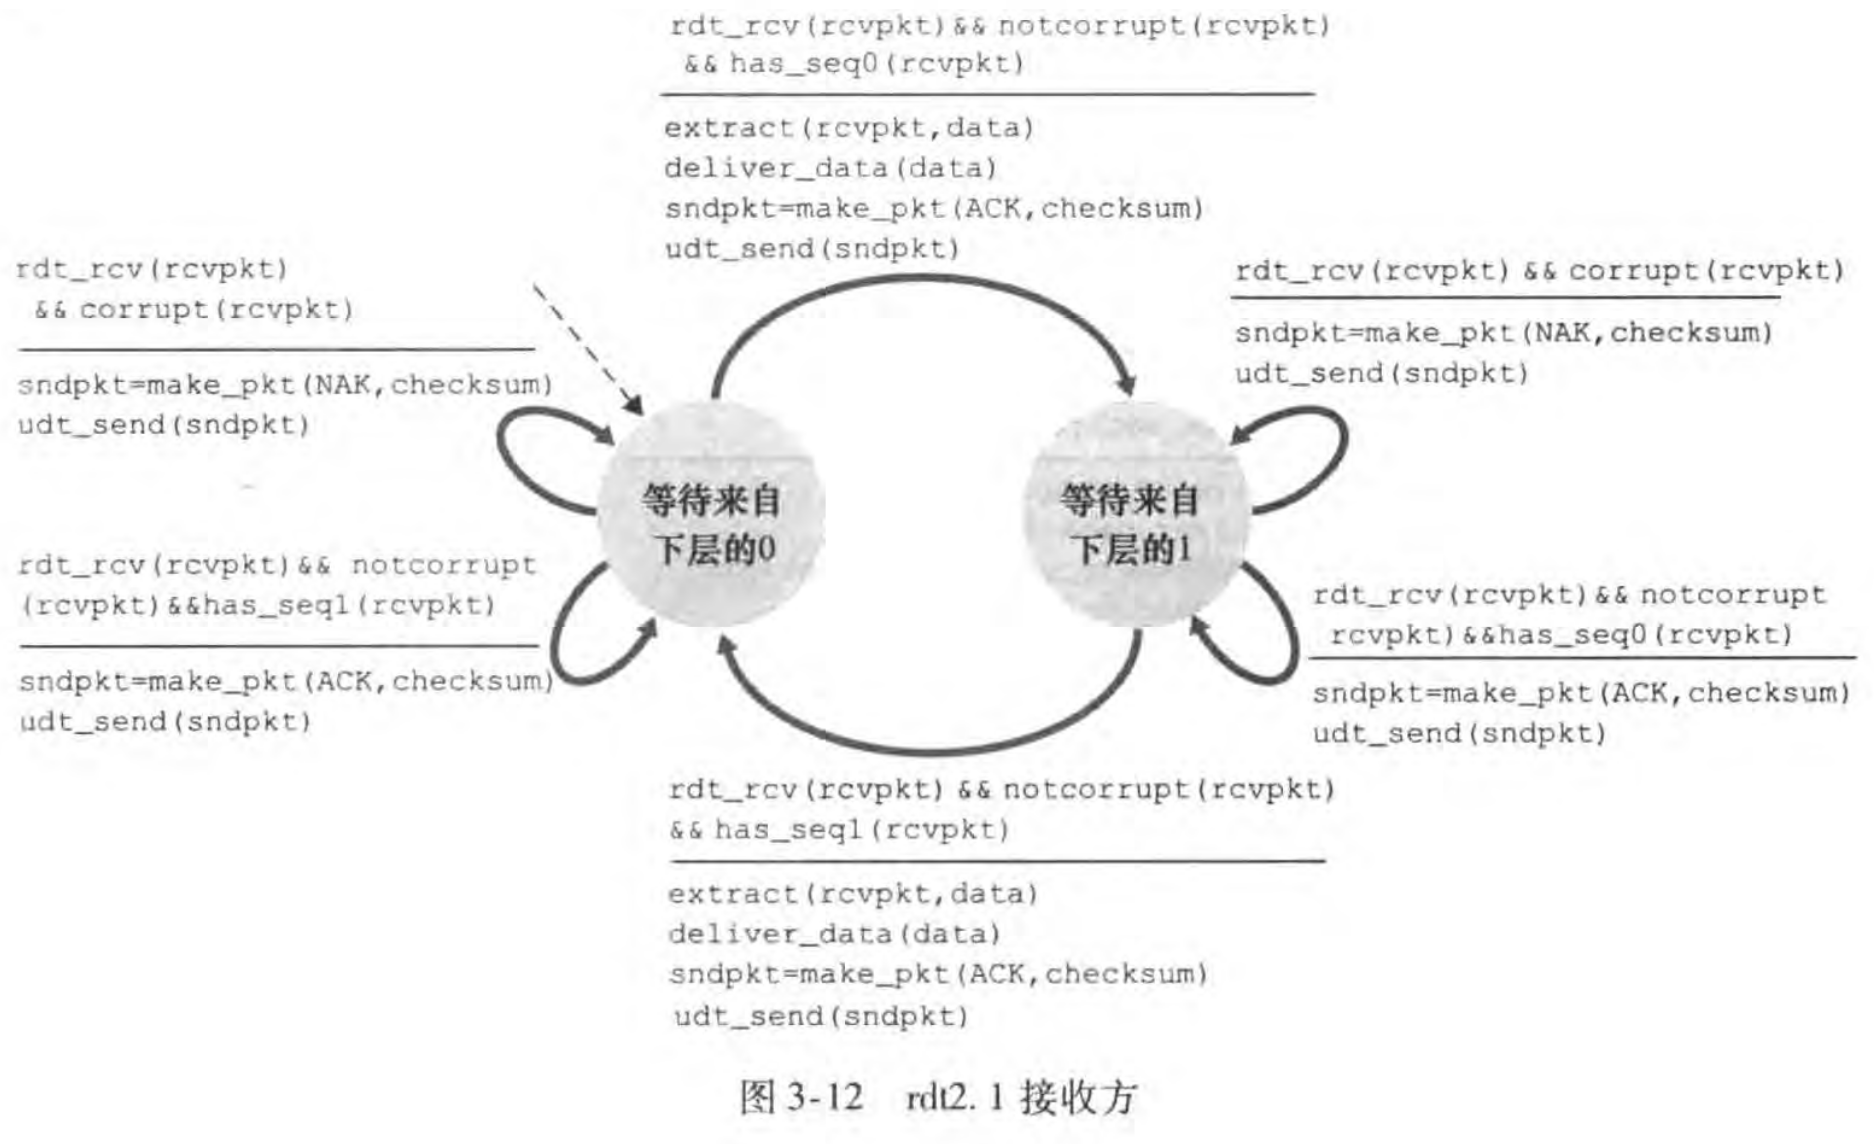
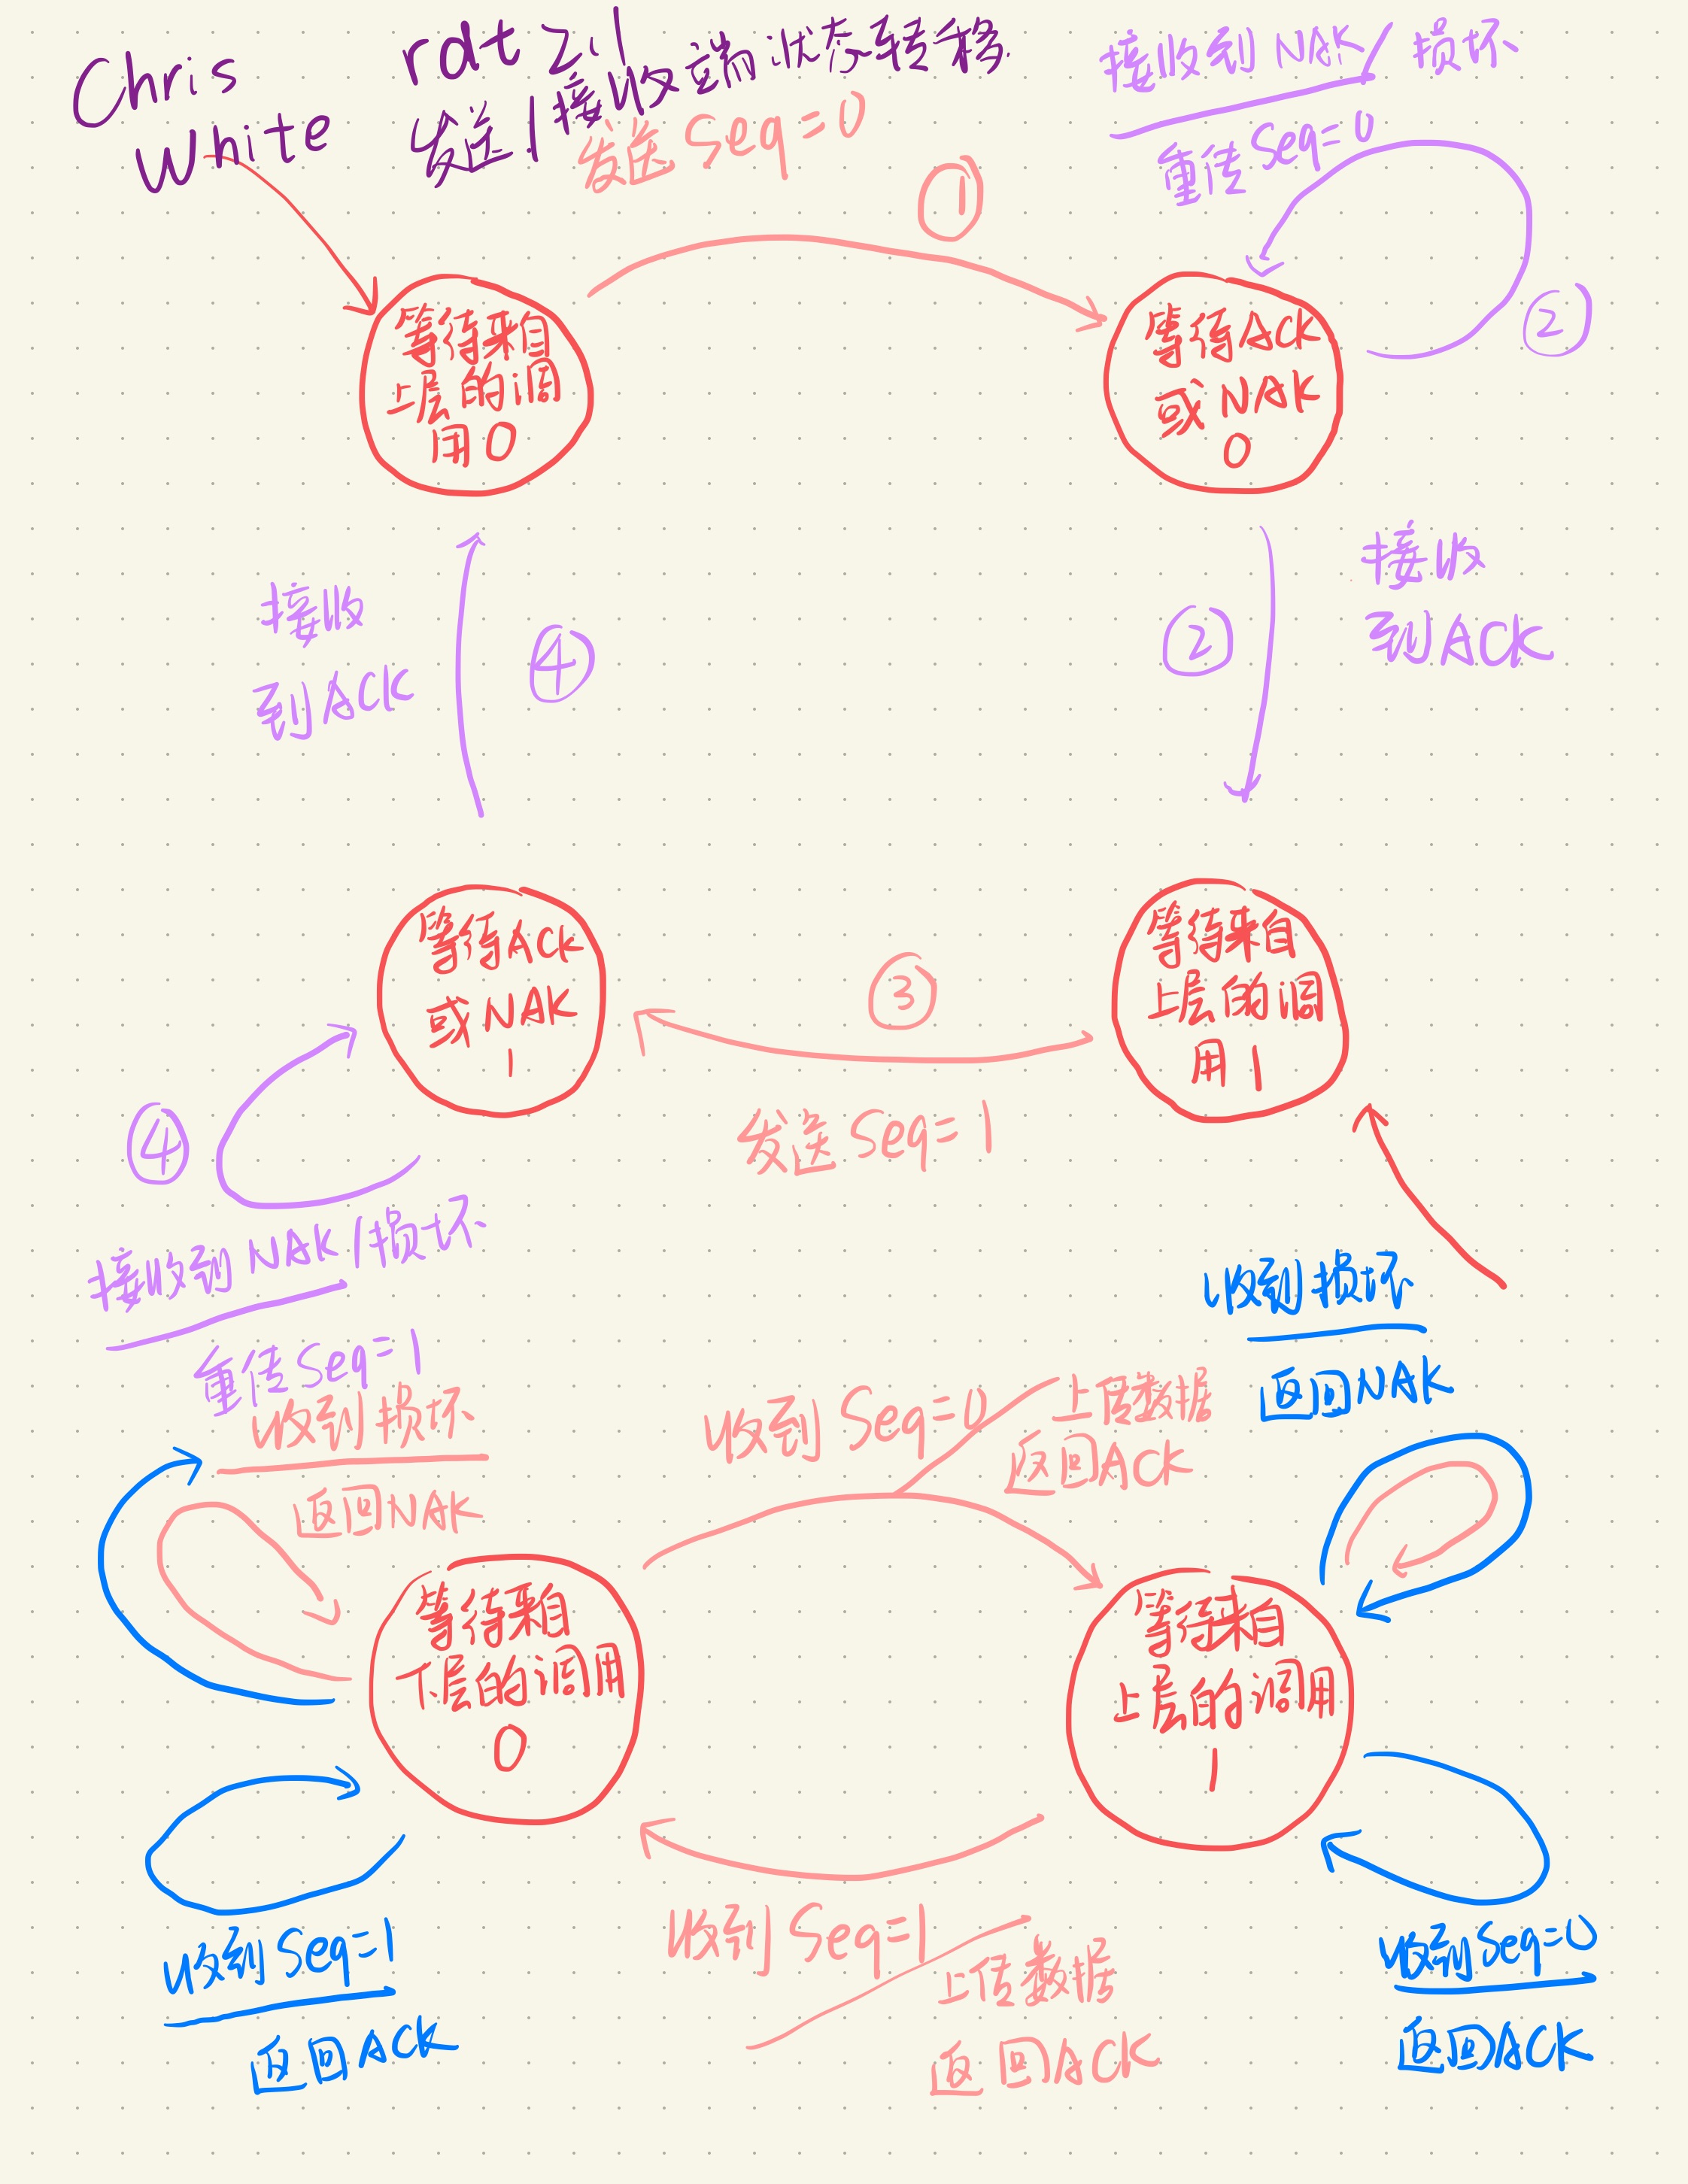
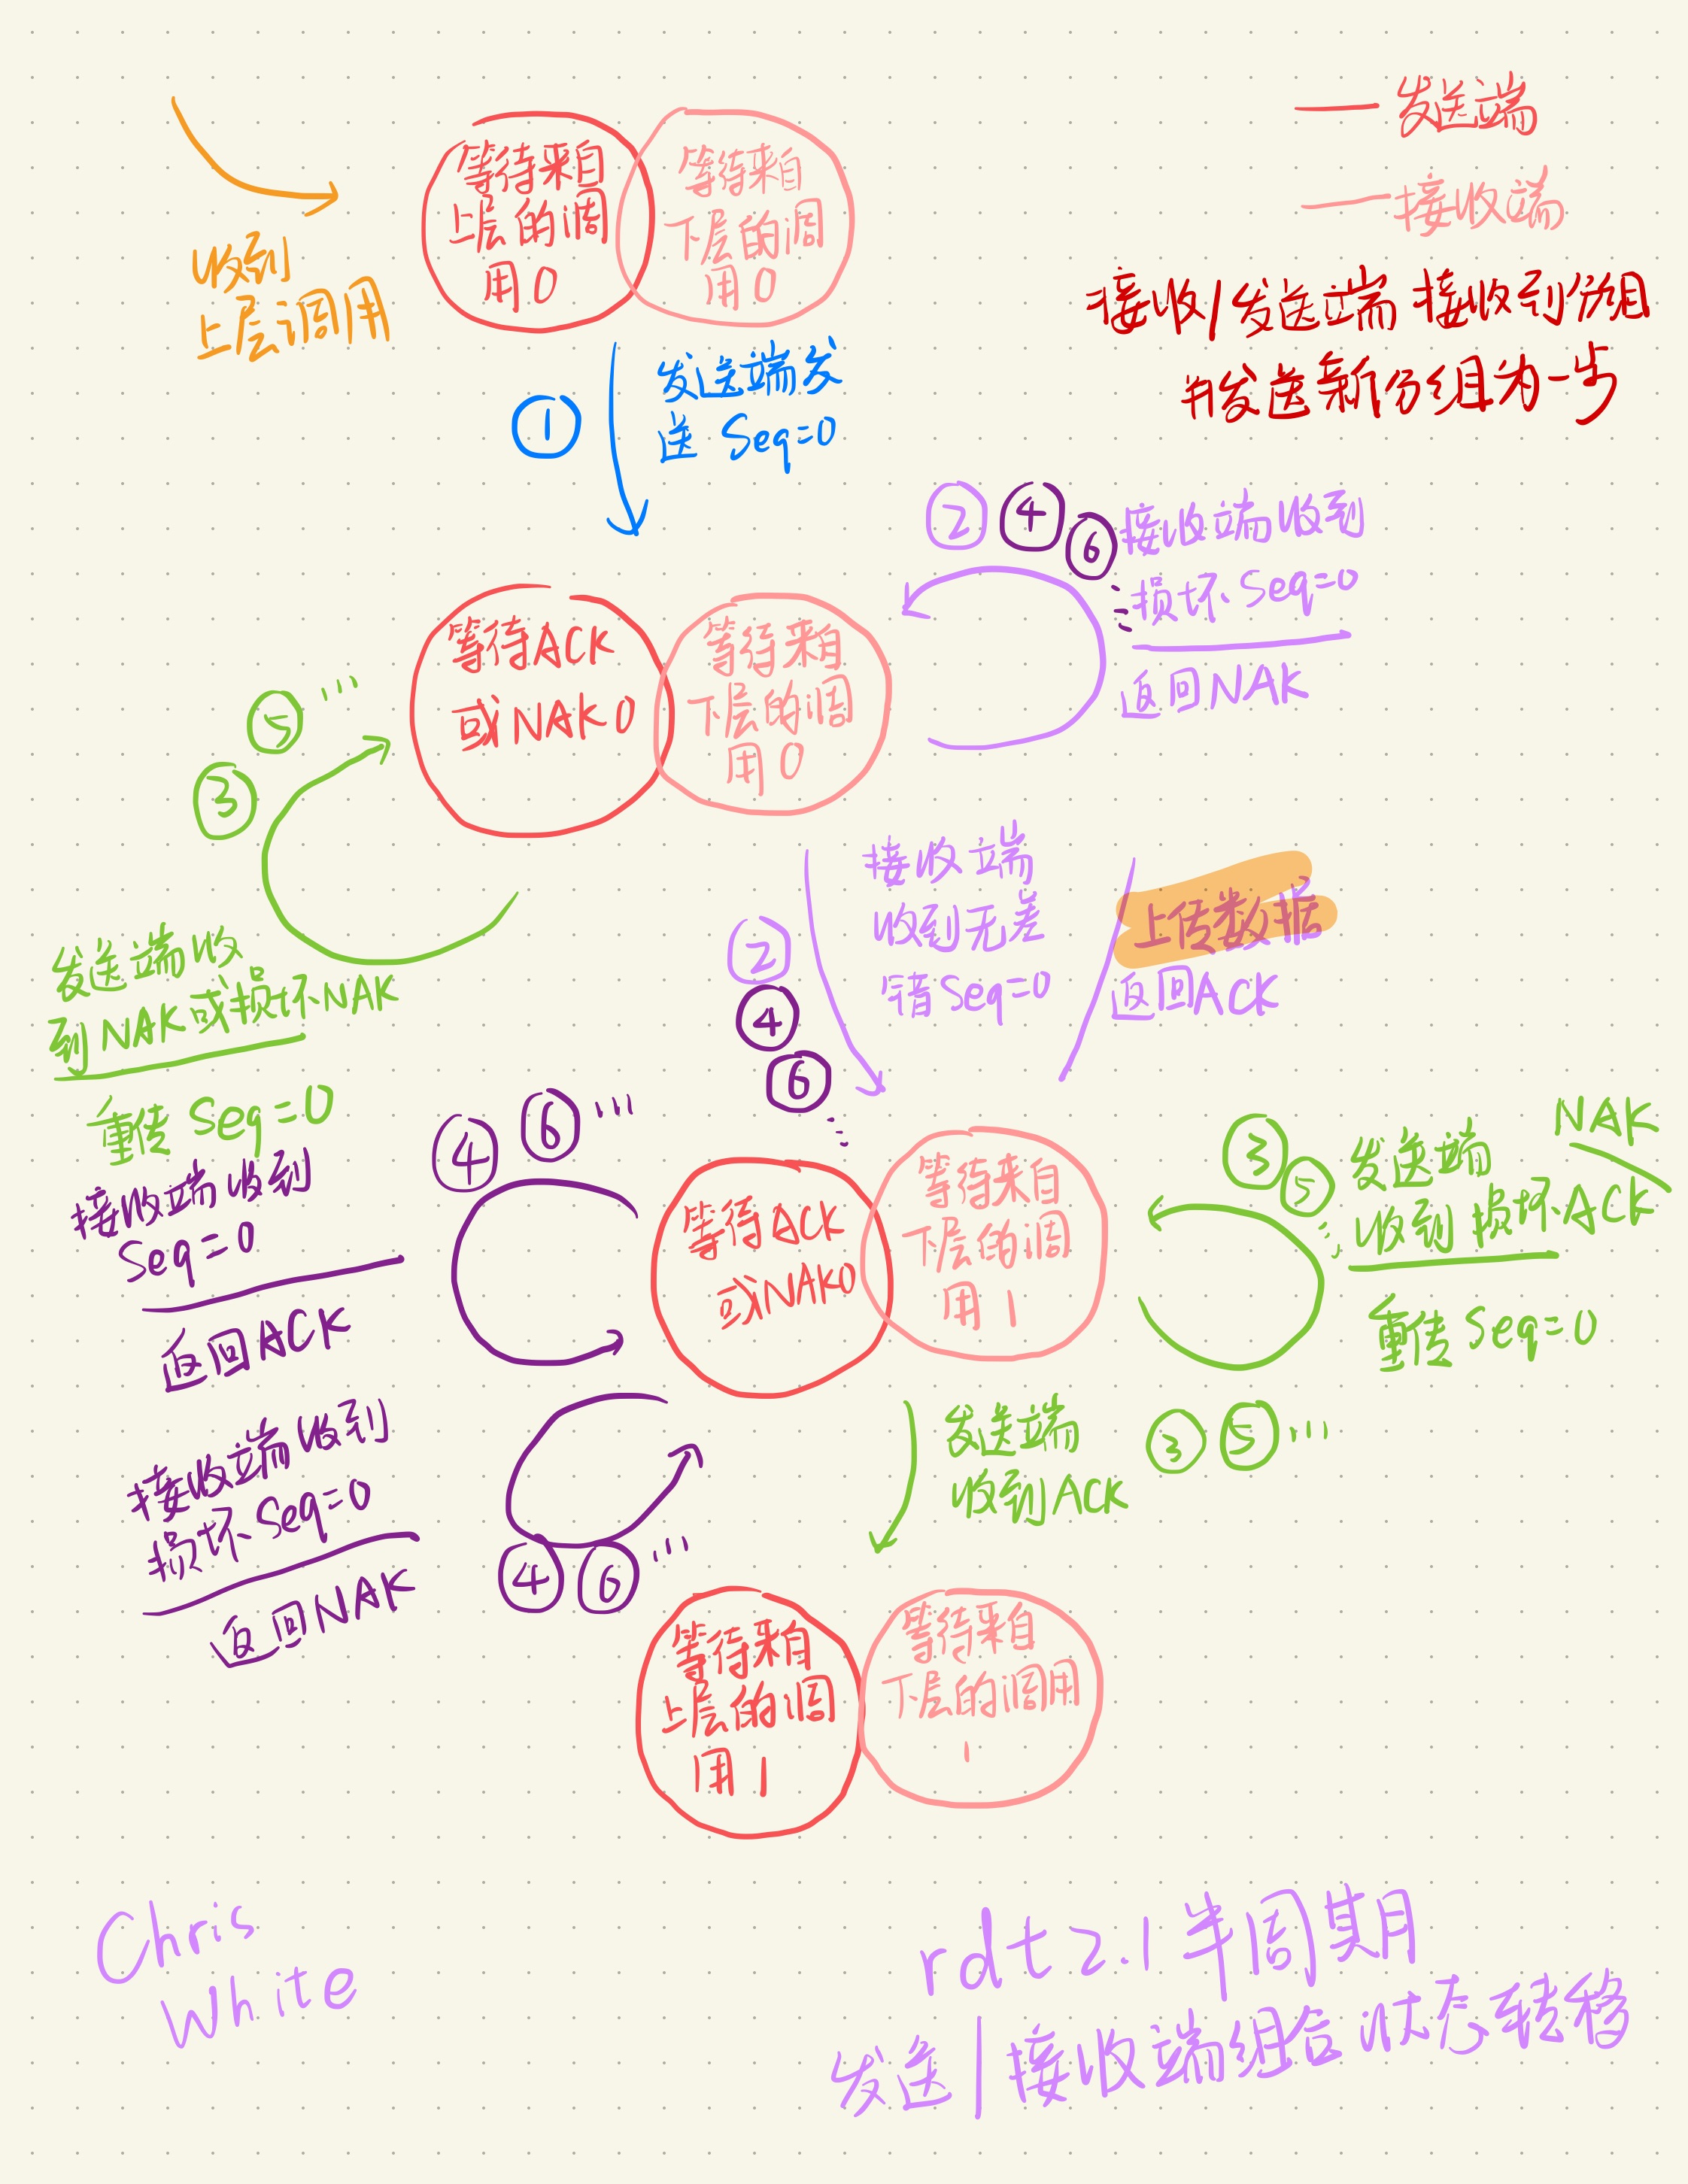
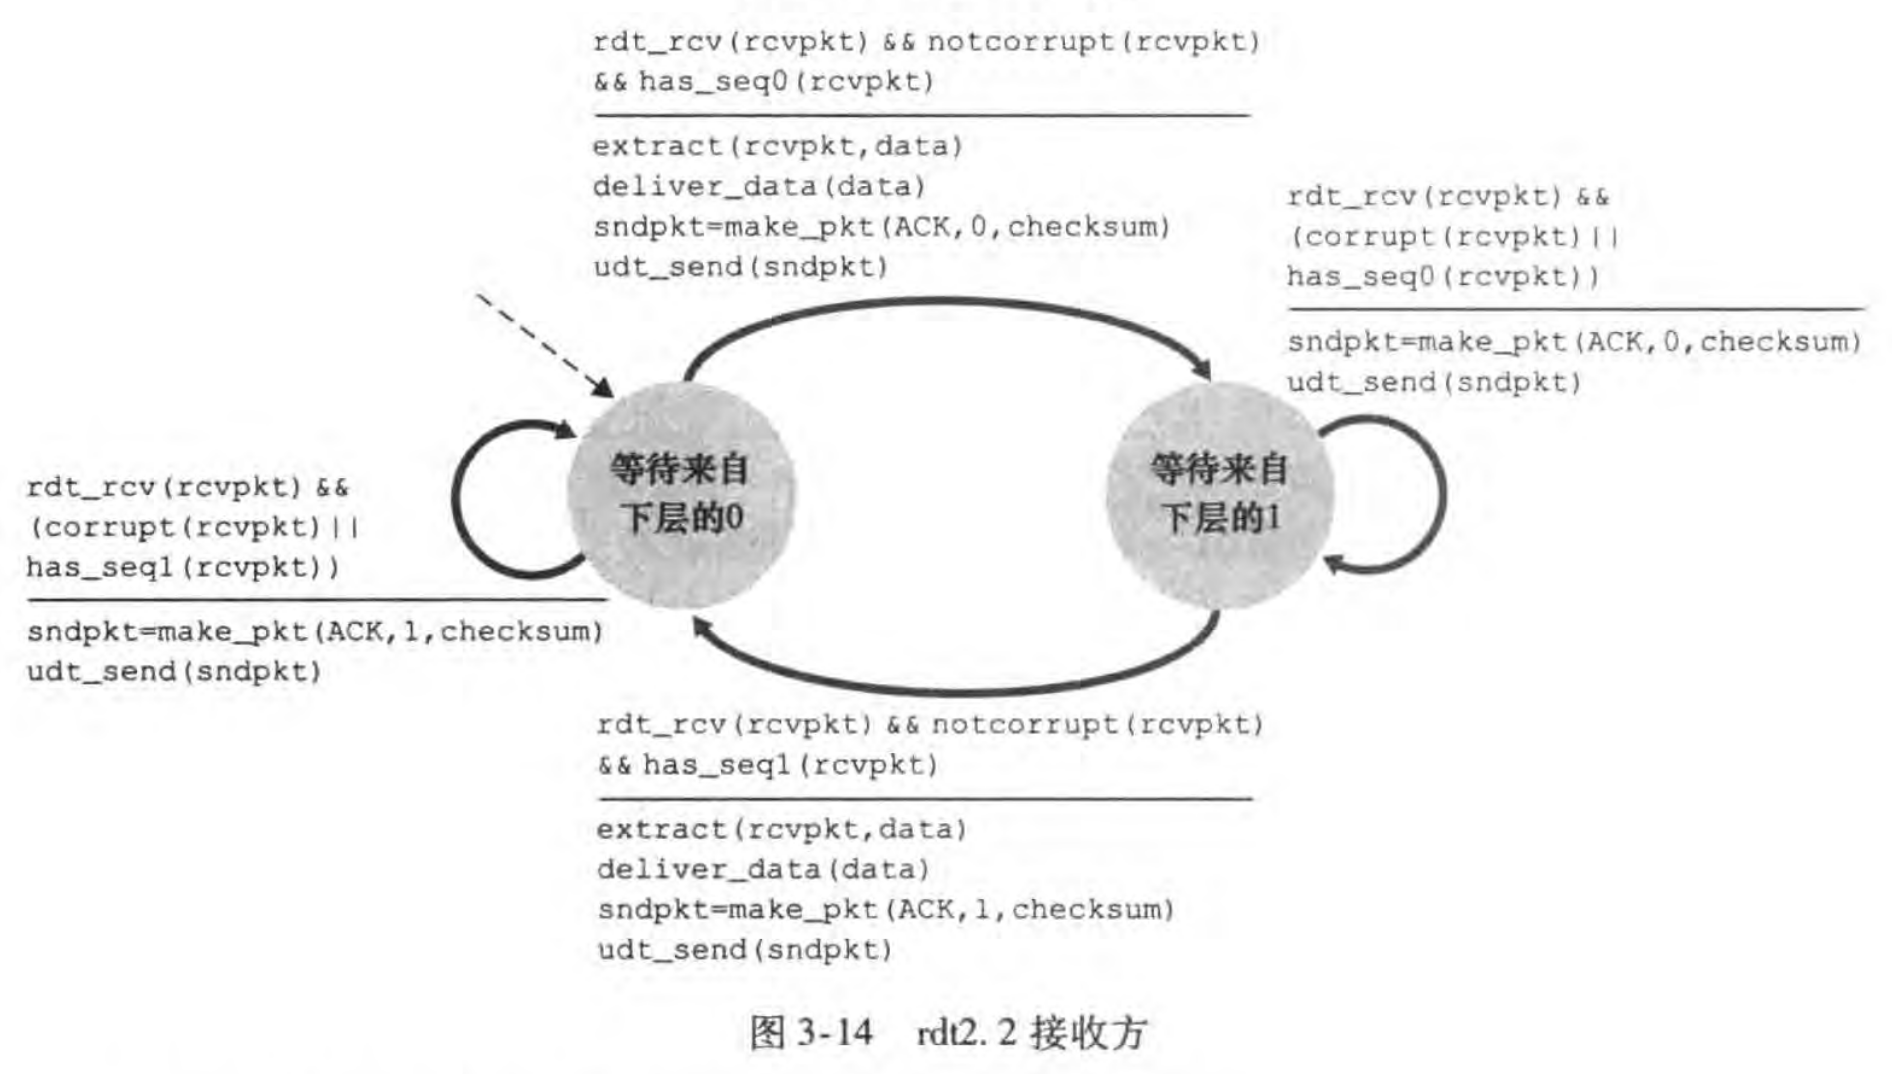
引入序号:rdt 2.1 为了解决冗余分组带来的歧义,必须在分组首部增加 序号(Sequence Number) 字段。对于停等协议,最简只需 1 比特的序号(0 和 1 循环交替)。接收方通过对比序号即可明确获知到达的分组是新数据还是重传数据:
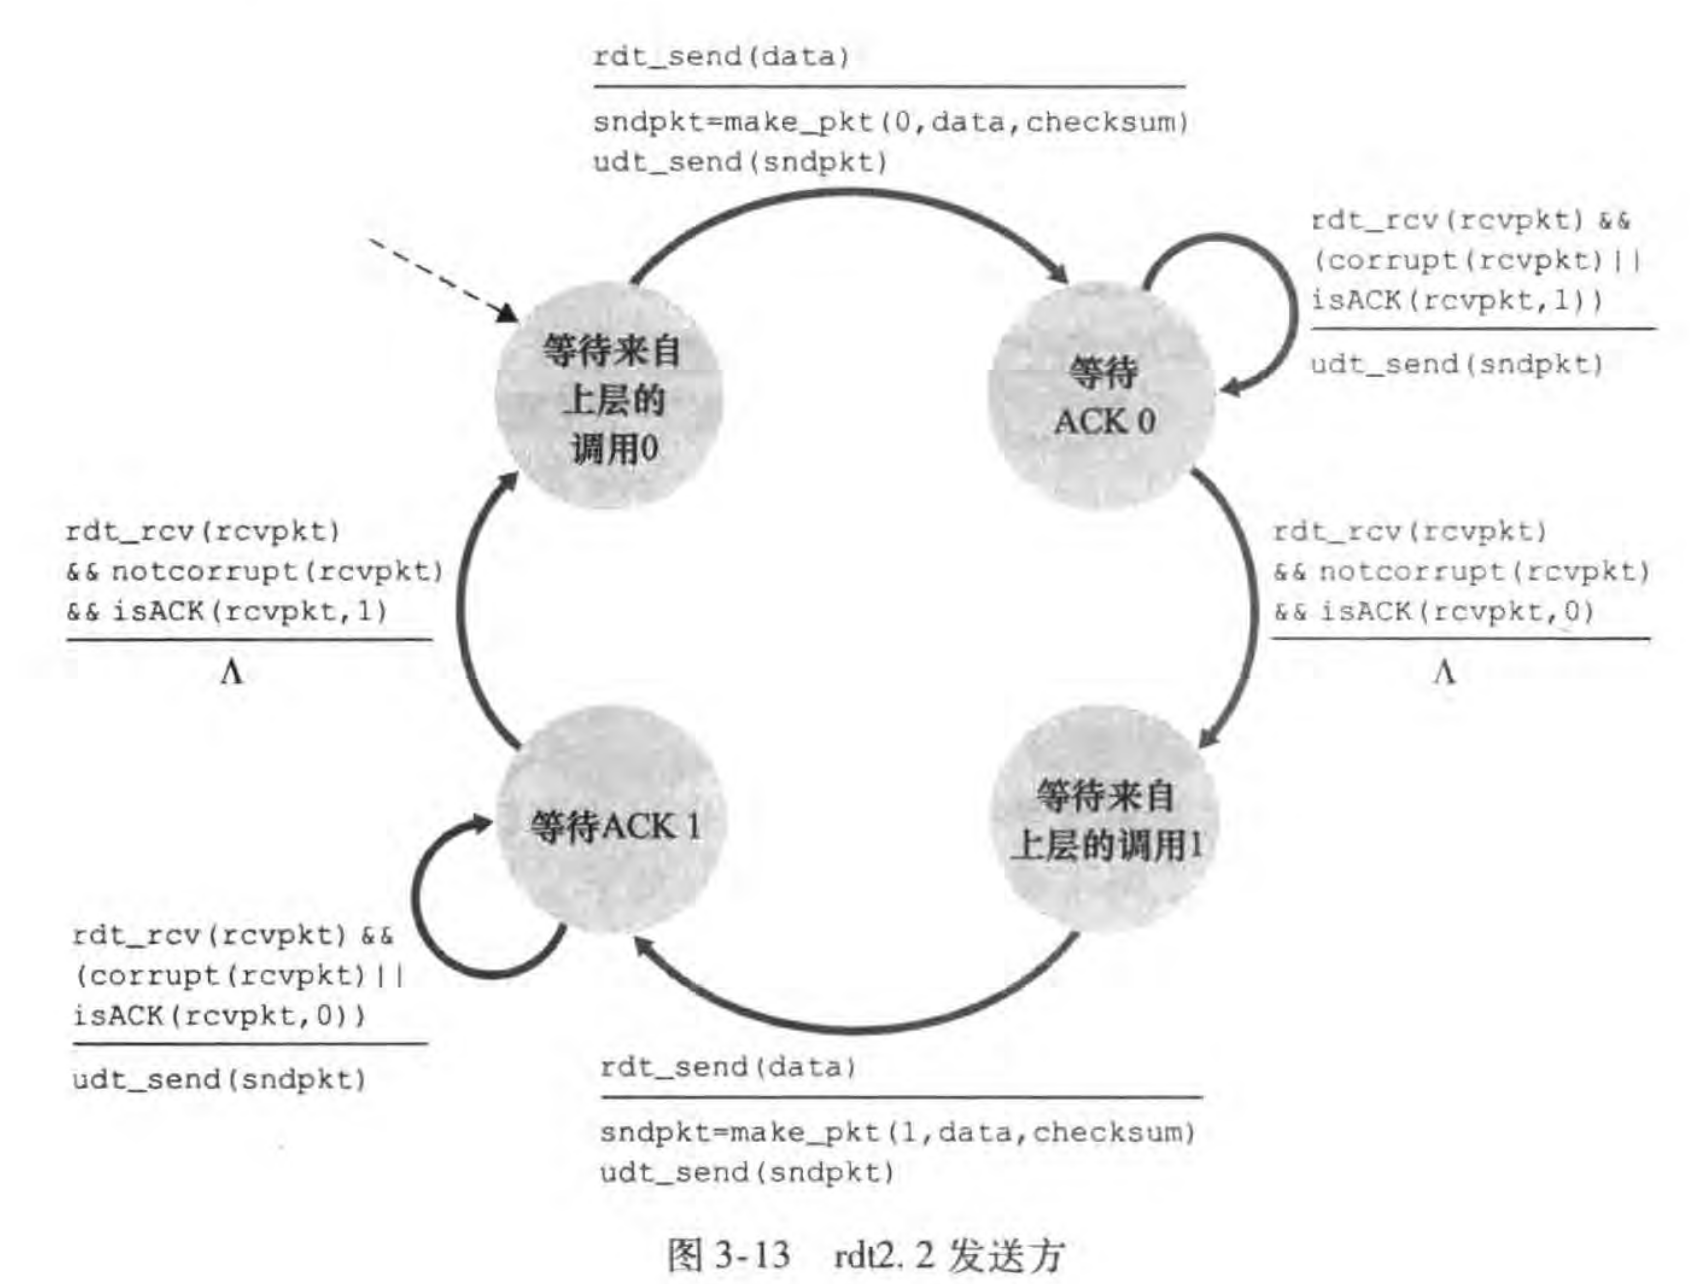
抛弃 NAK:rdt 2.2 在 rdt 2.2 中,可以完全省去 NAK 报文——如果接收端检测到差错,只需对上一个成功接收的分组重复发送 ACK(携带上一个成功分组的序号)。发送端一旦收到对同一个序号的冗余 ACK,即等价于收到了 NAK,触发当前分组重传。
3. 具有比特差错与丢包的信道:rdt 3.0
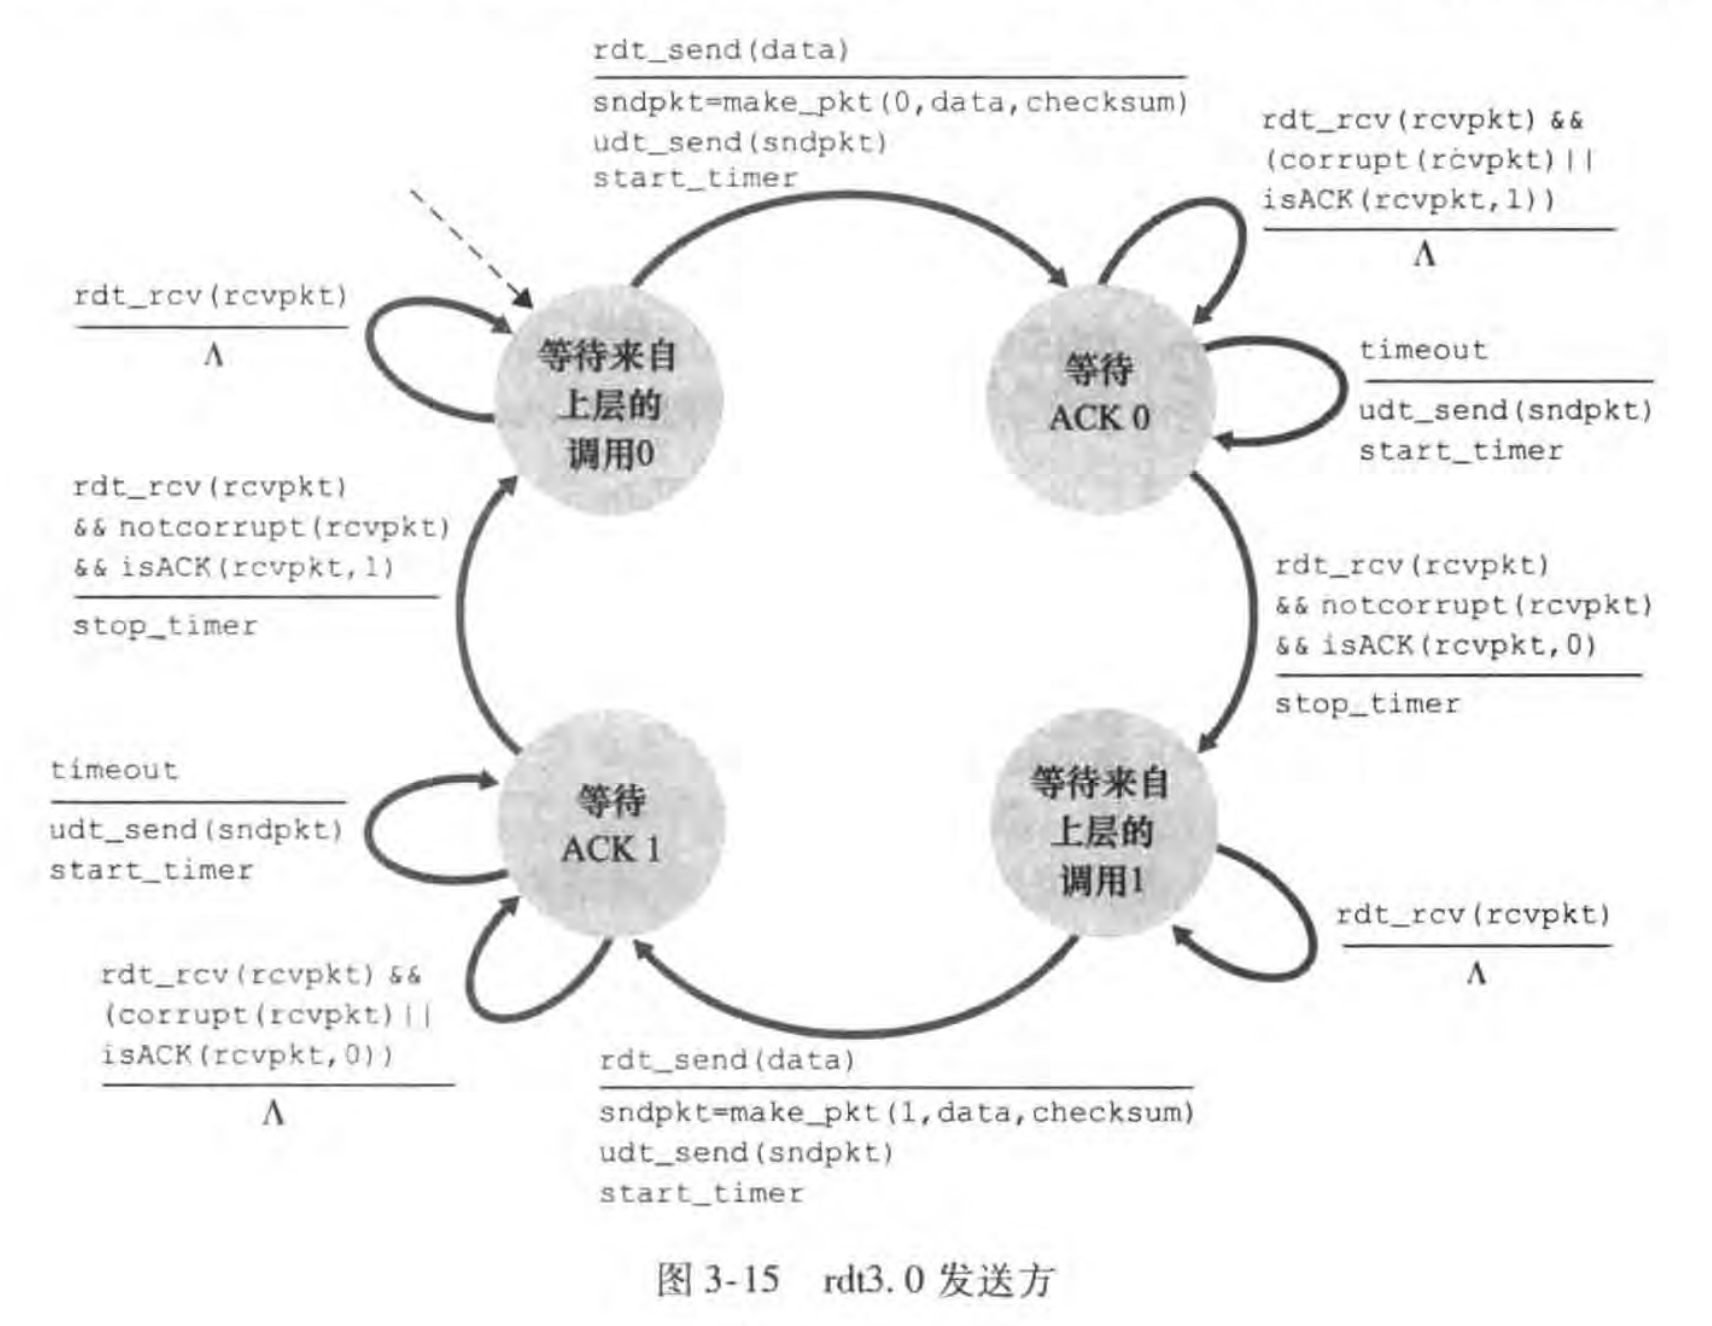
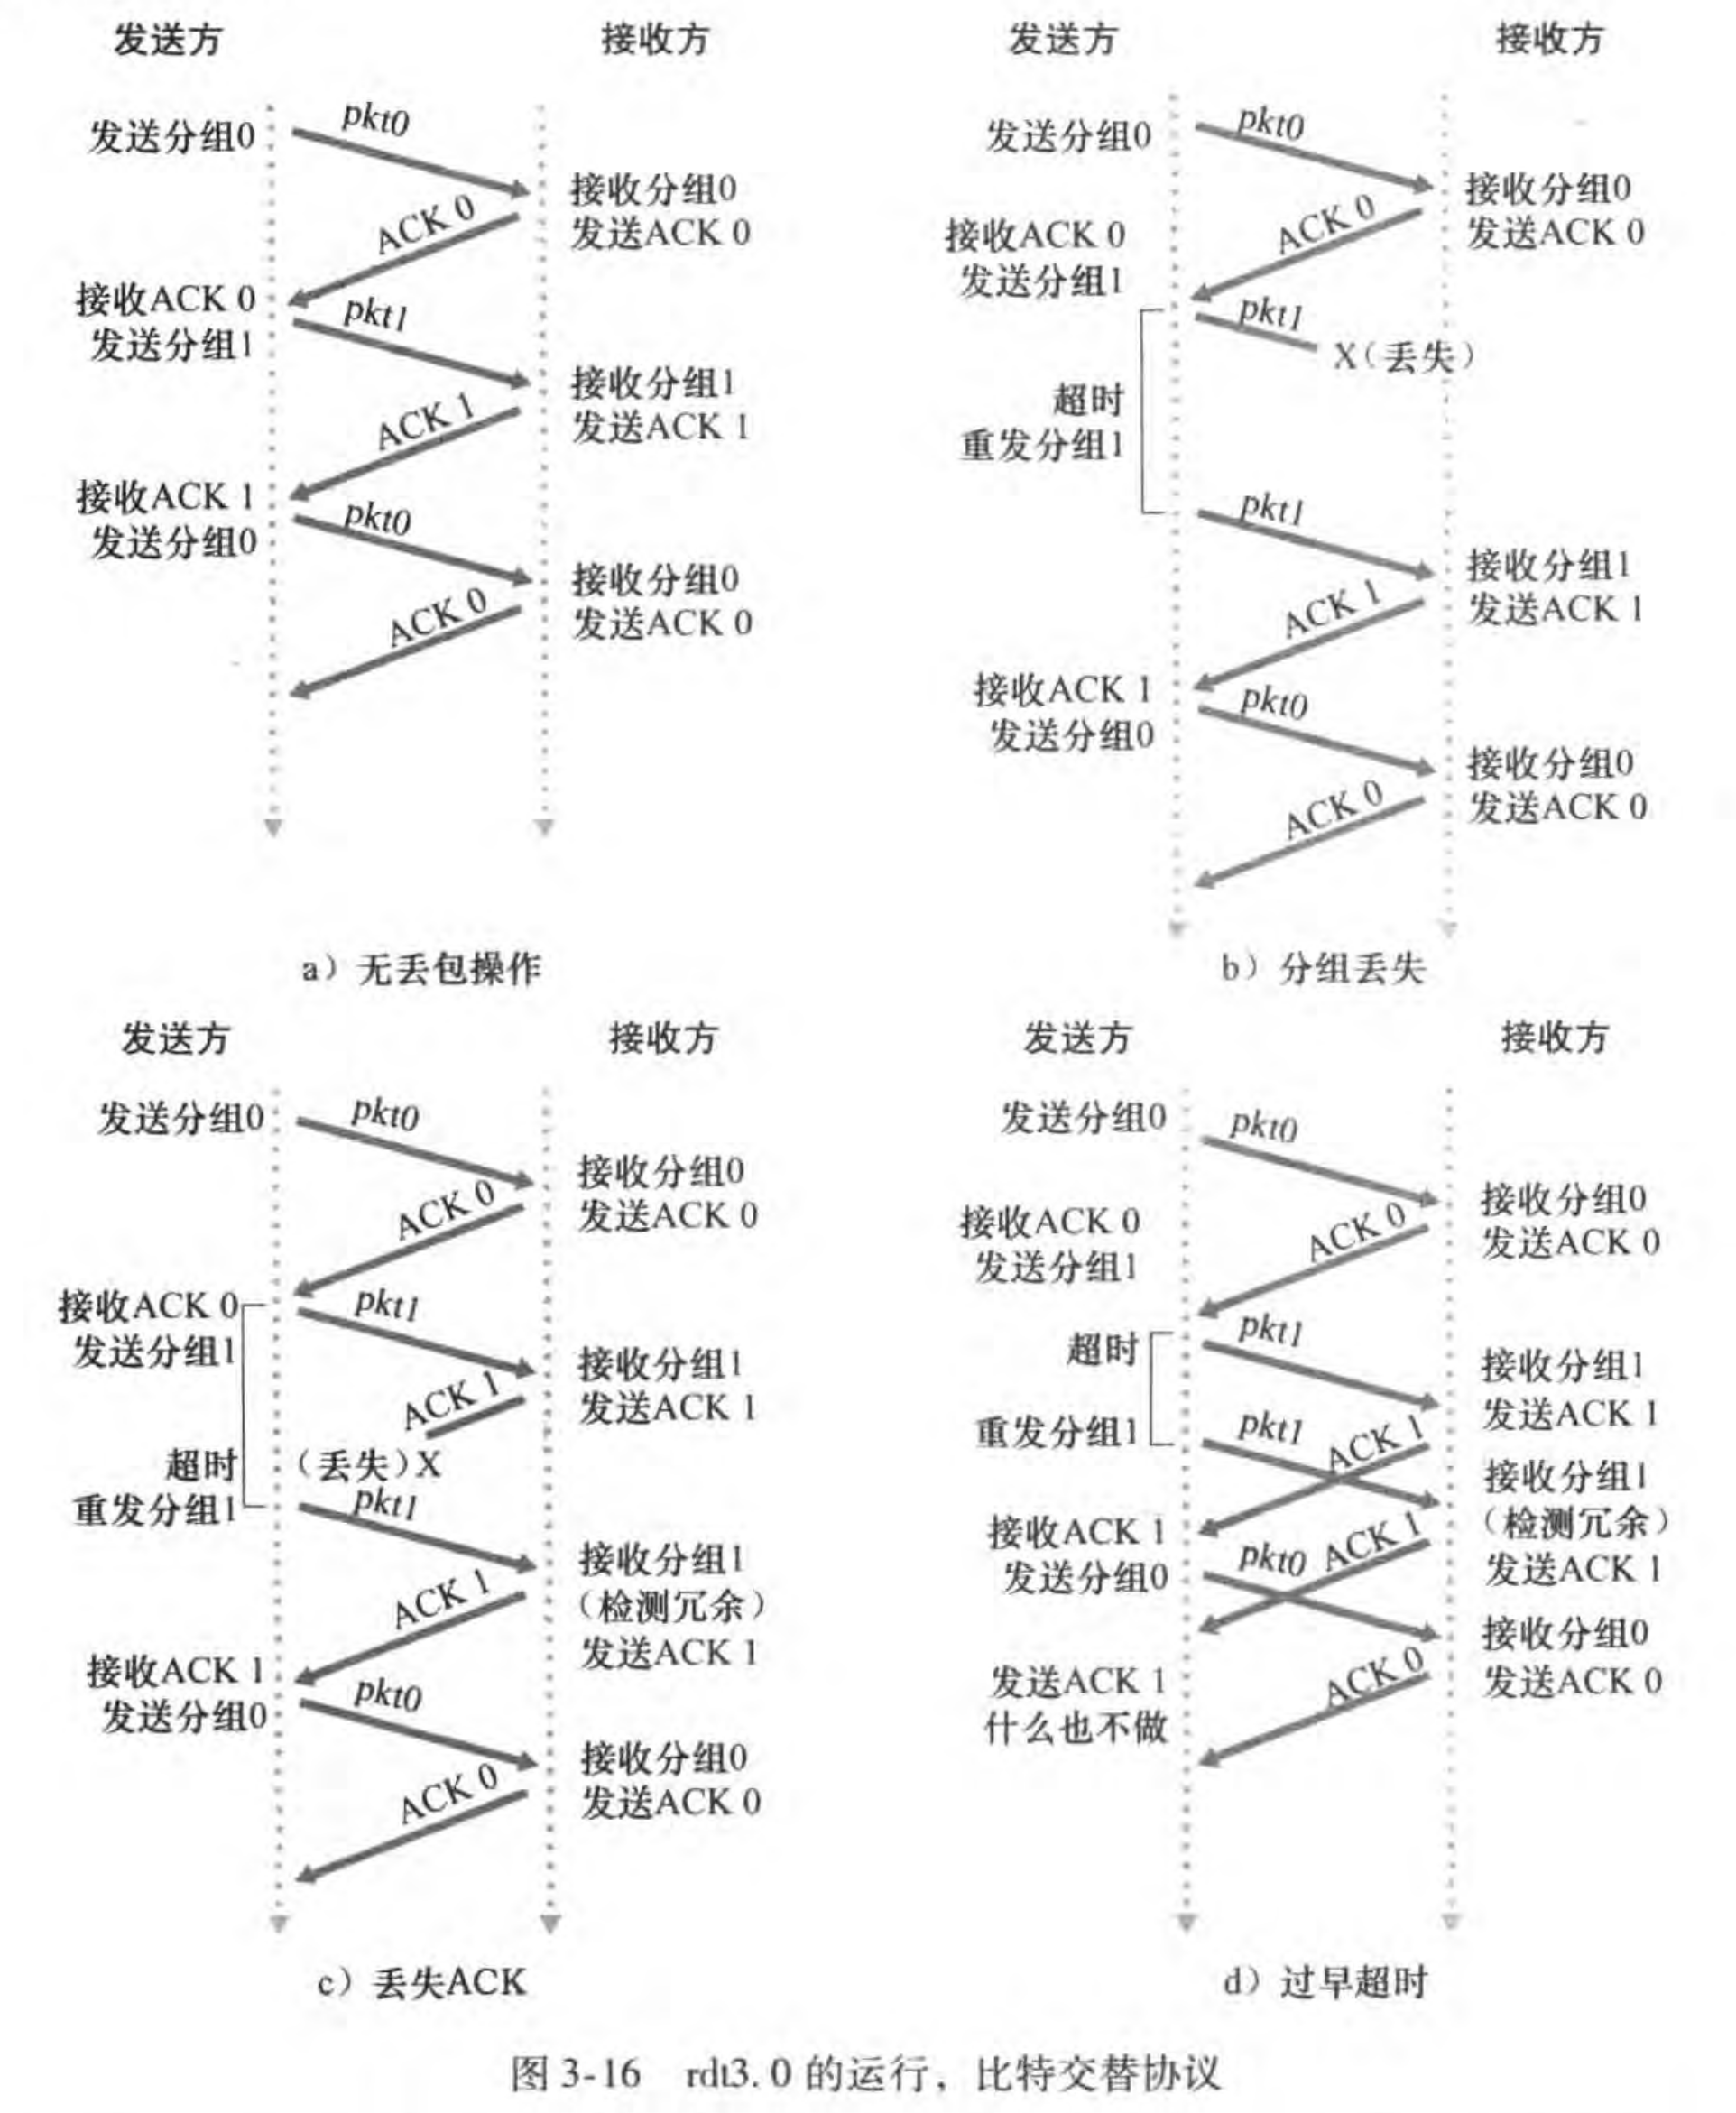
当信道不仅损坏比特、还会彻底丢失分组(数据分组丢失或 ACK 丢失)时,发送方将永远等不到确认。
为此,发送方引入倒数定时器(Countdown Timer):每次发送分组时启动定时器,若在预设超时间隔内未收到对应 ACK,发送方即断定分组丢失并触发重传。因为协议在 0 和 1 两个序号间交替往复,rdt 3.0 也被称为比特交替协议(Alternating-Bit Protocol)。
流水线可靠传输协议
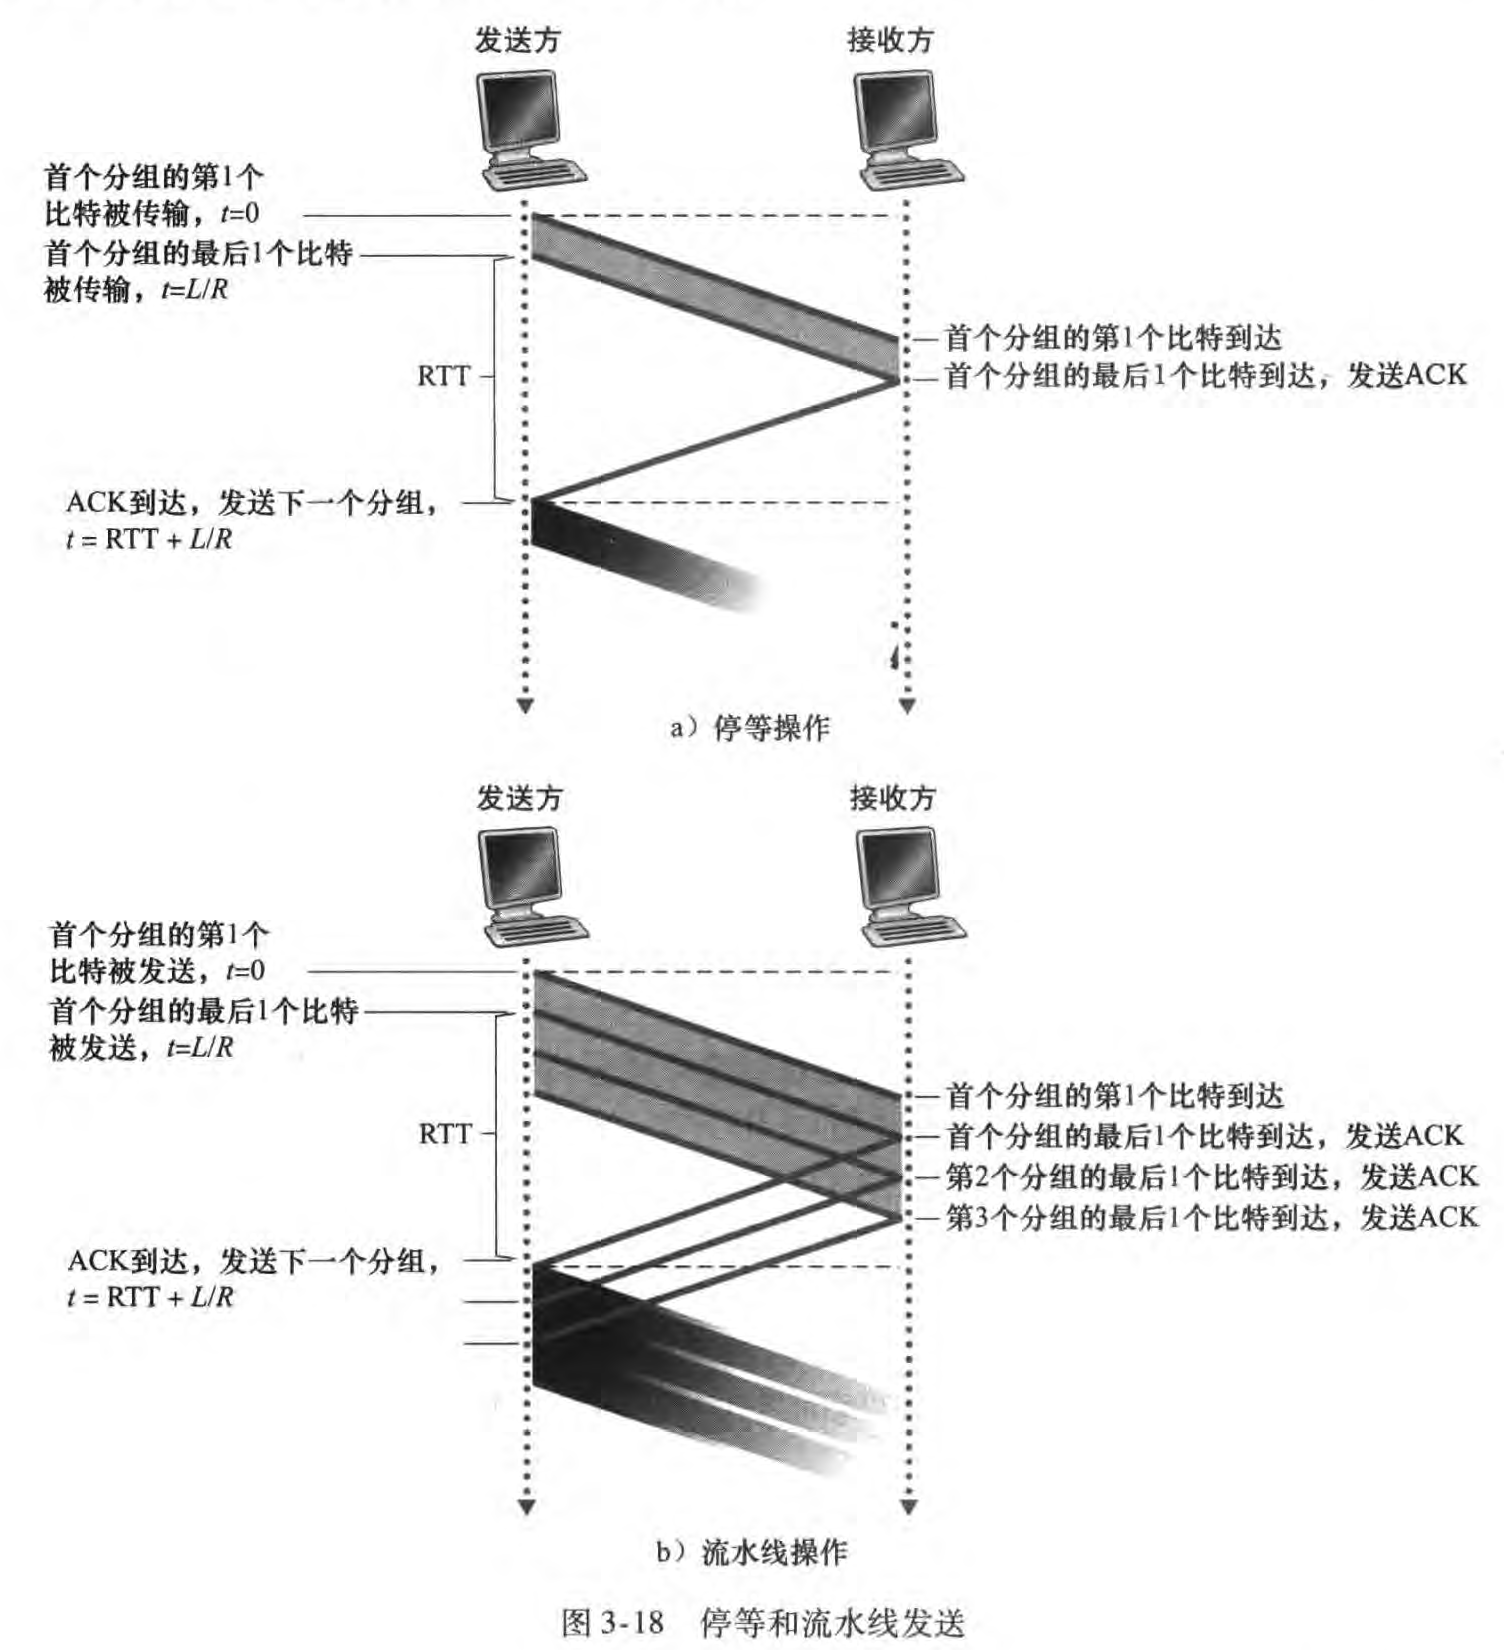
停等协议虽然逻辑完备,但网络利用率极低。设端到端 RTT 为 30 ms,链路带宽为 1 Gbps,分组长度 字节(8000 比特),传输时延为: 在停等协议下,发送方花费 发送一个分组后必须等待整整 30 ms 才能发下一个,信道有效利用率仅为:
为了突破停等瓶颈,必须引入 流水线(Pipelining) 技术:允许发送方连续发送多个尚未确认的分组。
流水线协议的核心机制分为两类:回退 N 步(GBN) 与 选择重传(SR)。
回退 N 步(Go-Back-N, GBN)
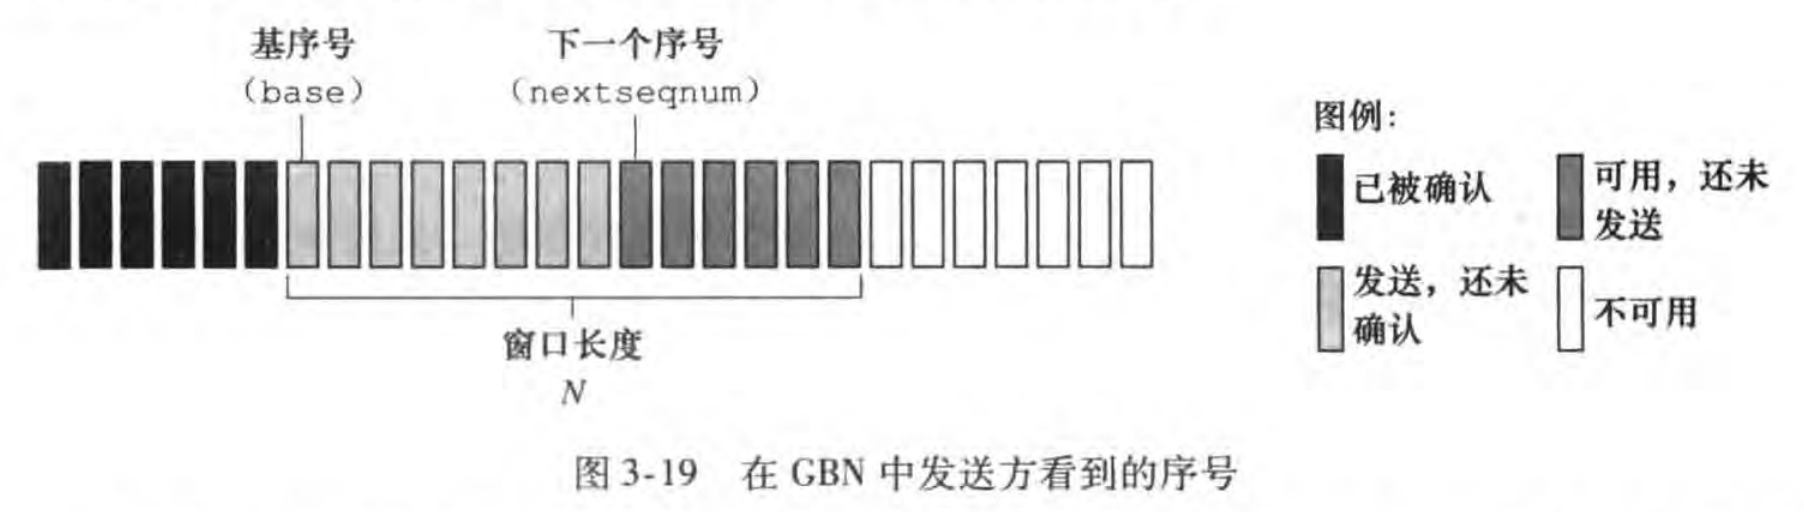
在 GBN 中,发送方维护一个长度为 的滑动窗口,定义:
base:最早发送但尚未收到确认的分组序号。nextseqnum:下一个待发送的可用序号。- 窗口内最多允许有 个已发送但未确认的分组在空中飞行。
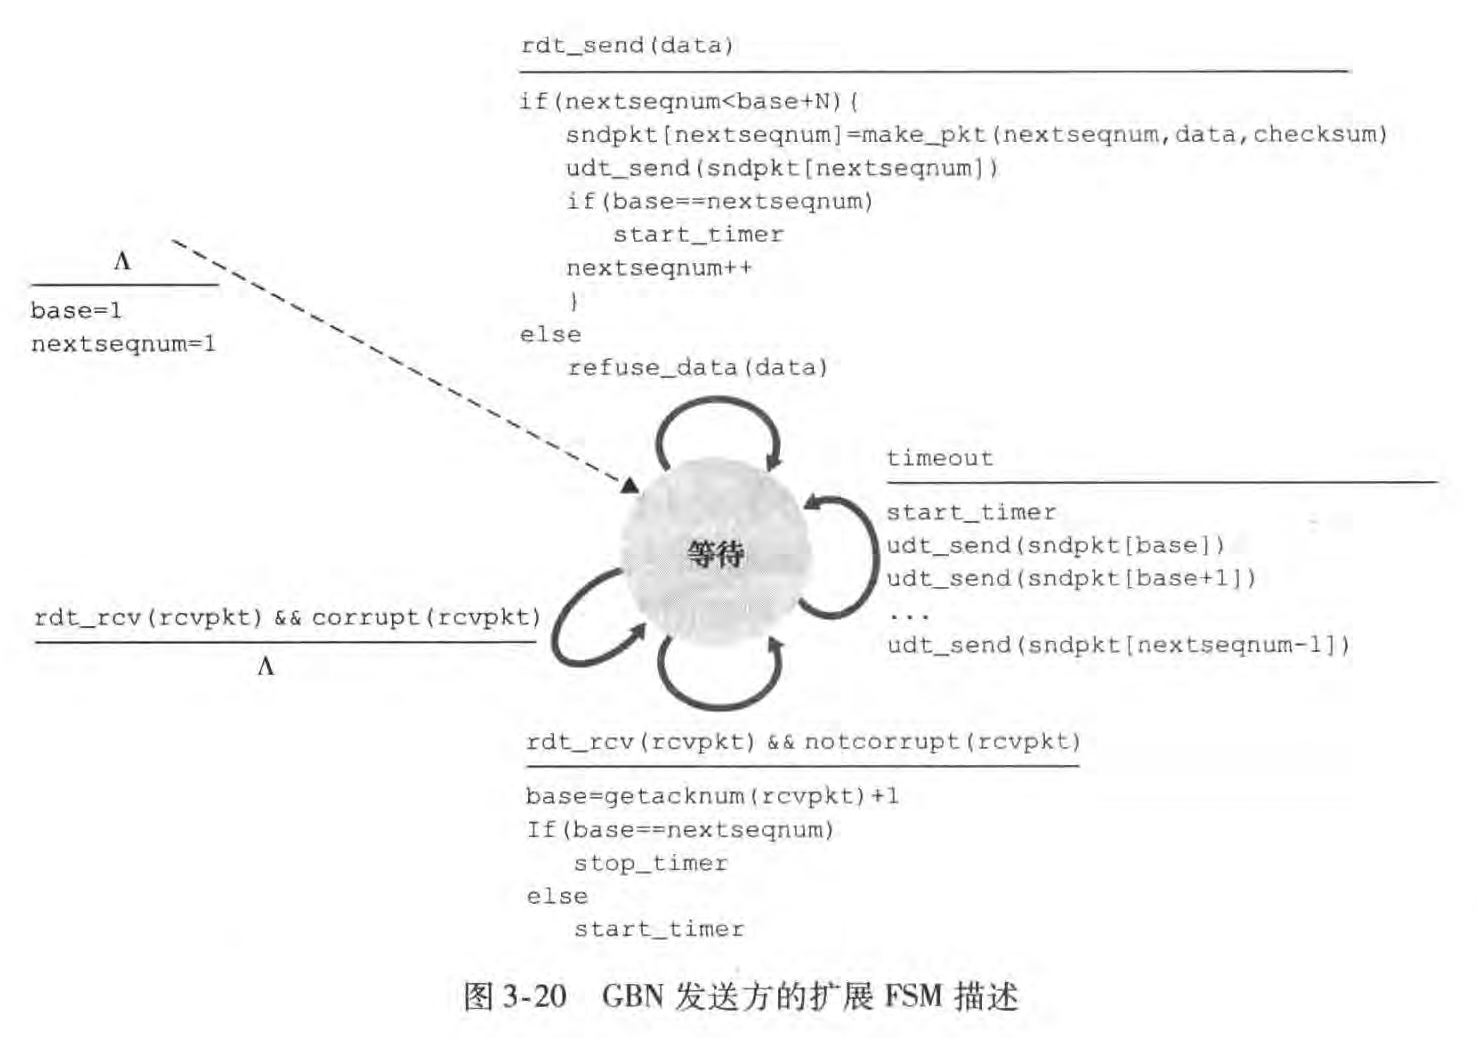
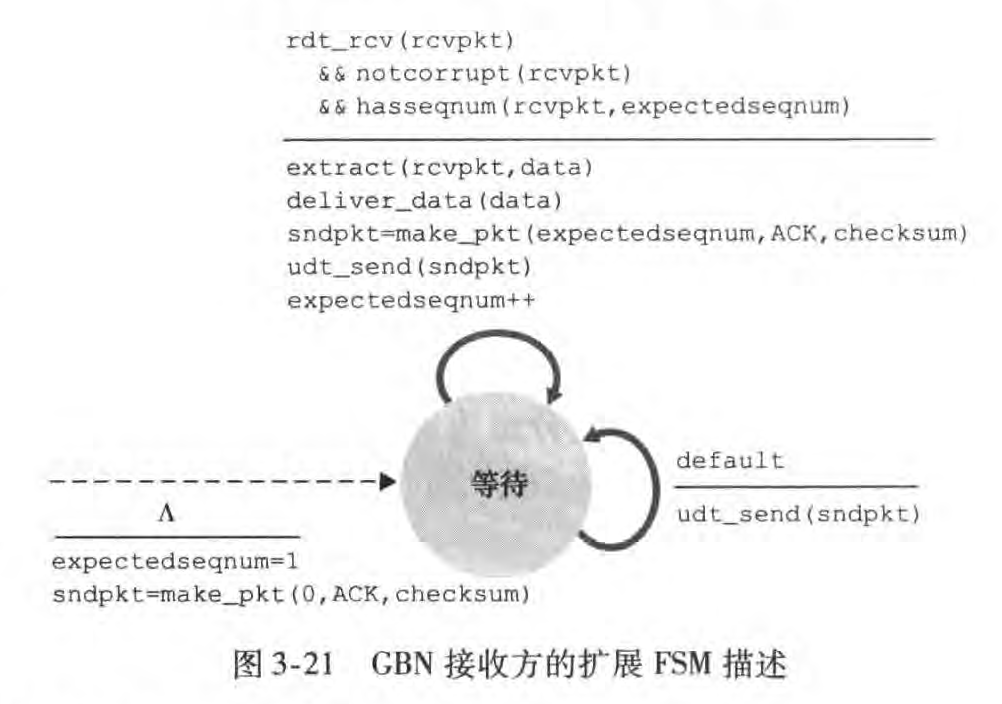
- 累积确认:接收端按序接收,若收到失序分组则直接丢弃,并对当前已按序接收的最高序号重复发送 ACK。
- 超时动作:发送方仅维护一个对应
base的定时器。若该定时器超时,发送方必须回退并重传当前窗口中所有未被确认的 个分组。当网络带宽时延积很大且单个分组出错时,GBN 会造成大量无谓的重复重传。
选择重传(Selective Repeat, SR)
为了规避 GBN 的整批重传开销,选择重传(SR)协议允许接收方单独确认并缓存所有无差错到达的失序分组:
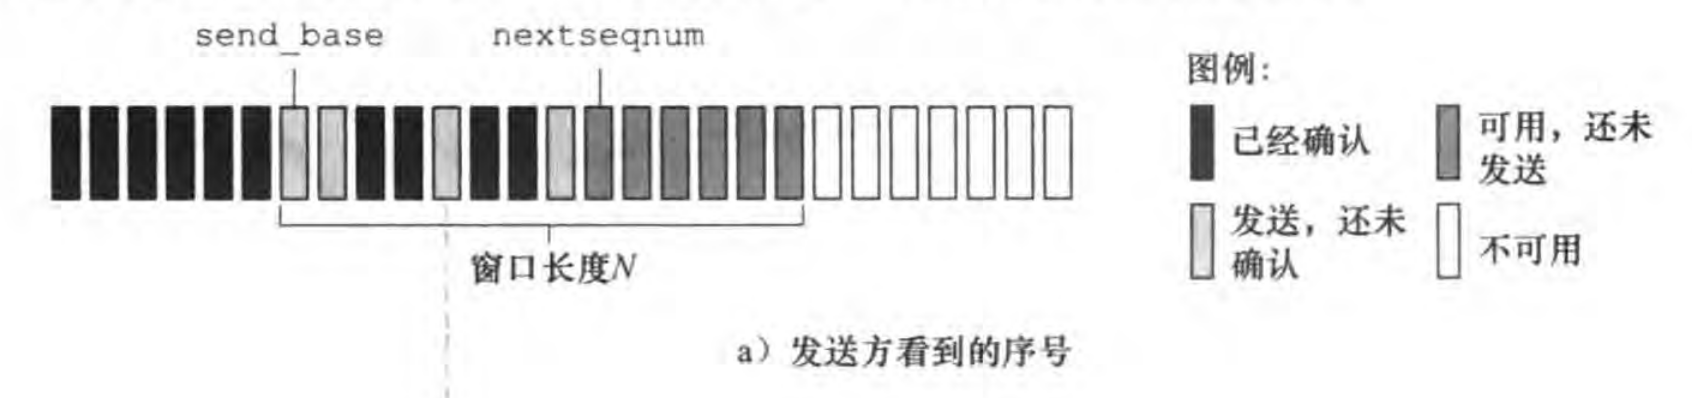
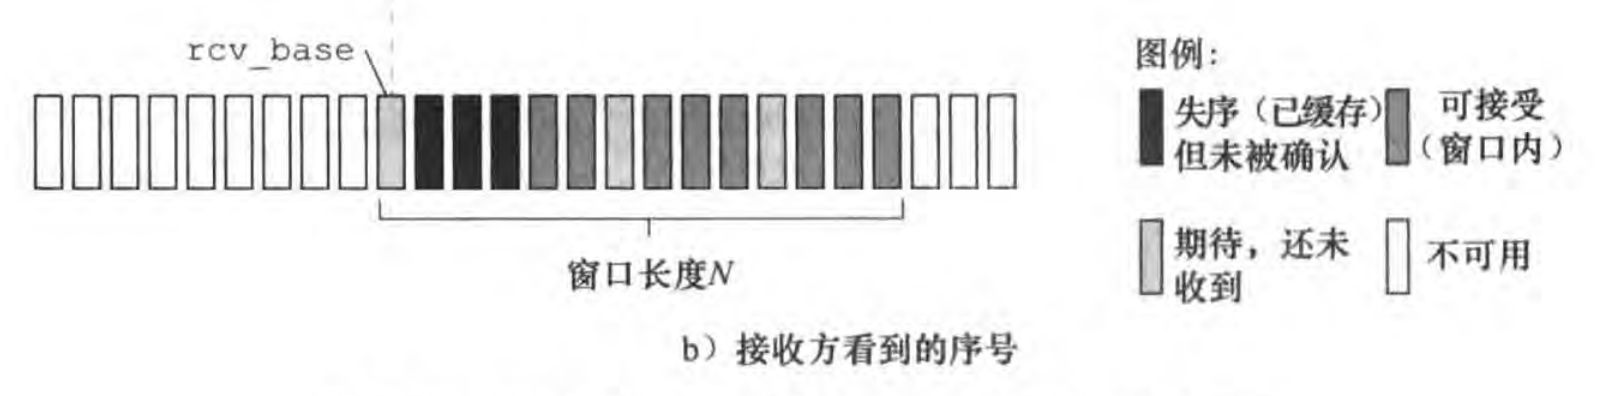
- 独立逻辑定时器:发送方为每个在飞分组维护独立的逻辑定时器,超时时仅重传对应超时的那单个分组。
- 窗口约束定理:在 SR 协议中,为了避免接收方对“当前窗口的新分组”与“由于 ACK 丢失而重传的前一个窗口的分组”产生混淆,窗口长度 必须小于或等于序号空间总大小的一半(即 )。
面向连接的运输:TCP
TCP 是因特网中最为核心的运输层协议,具有如下本质特征:
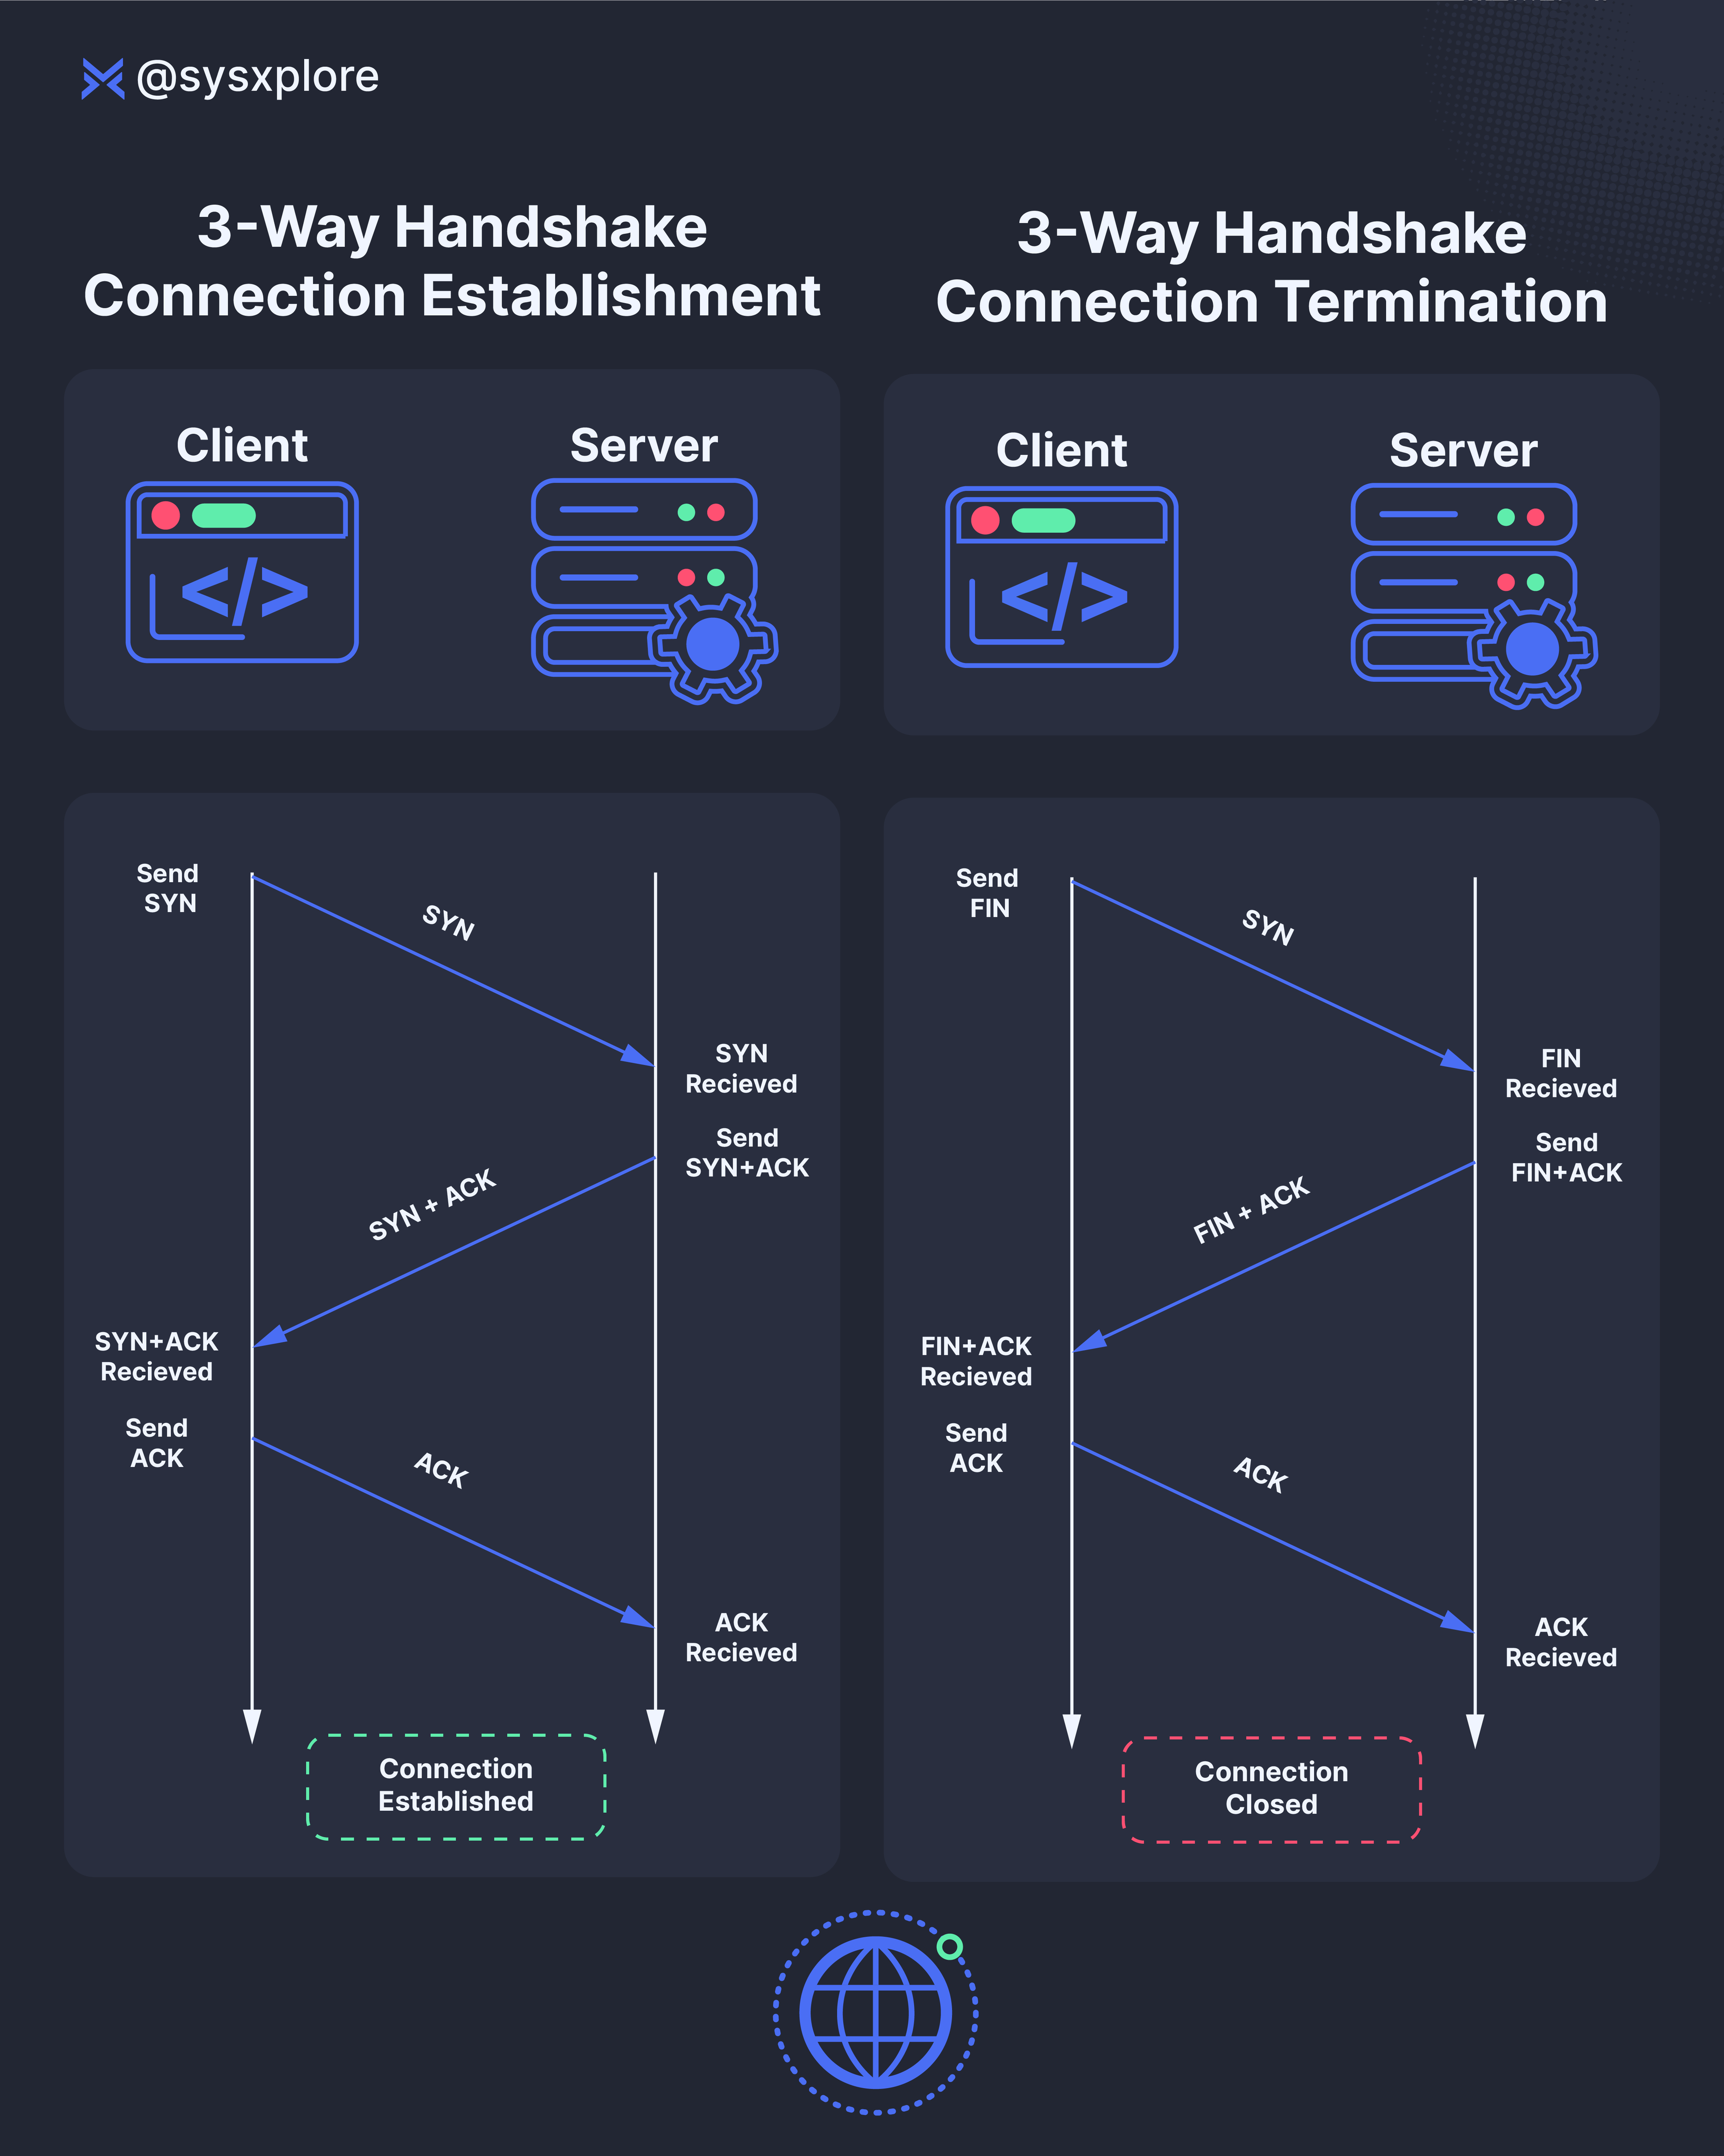
- 面向连接与点对点:通信前必须执行三次握手建立端到端的会话连接,连接不支持广播或多播。
- 全双工与字节流:两端可以同时双向收发数据;TCP 将数据视为无结构、有序的连续字节流,由协议自身根据 最大报文段长度(MSS, Maximum Segment Size) 进行自适应切片。
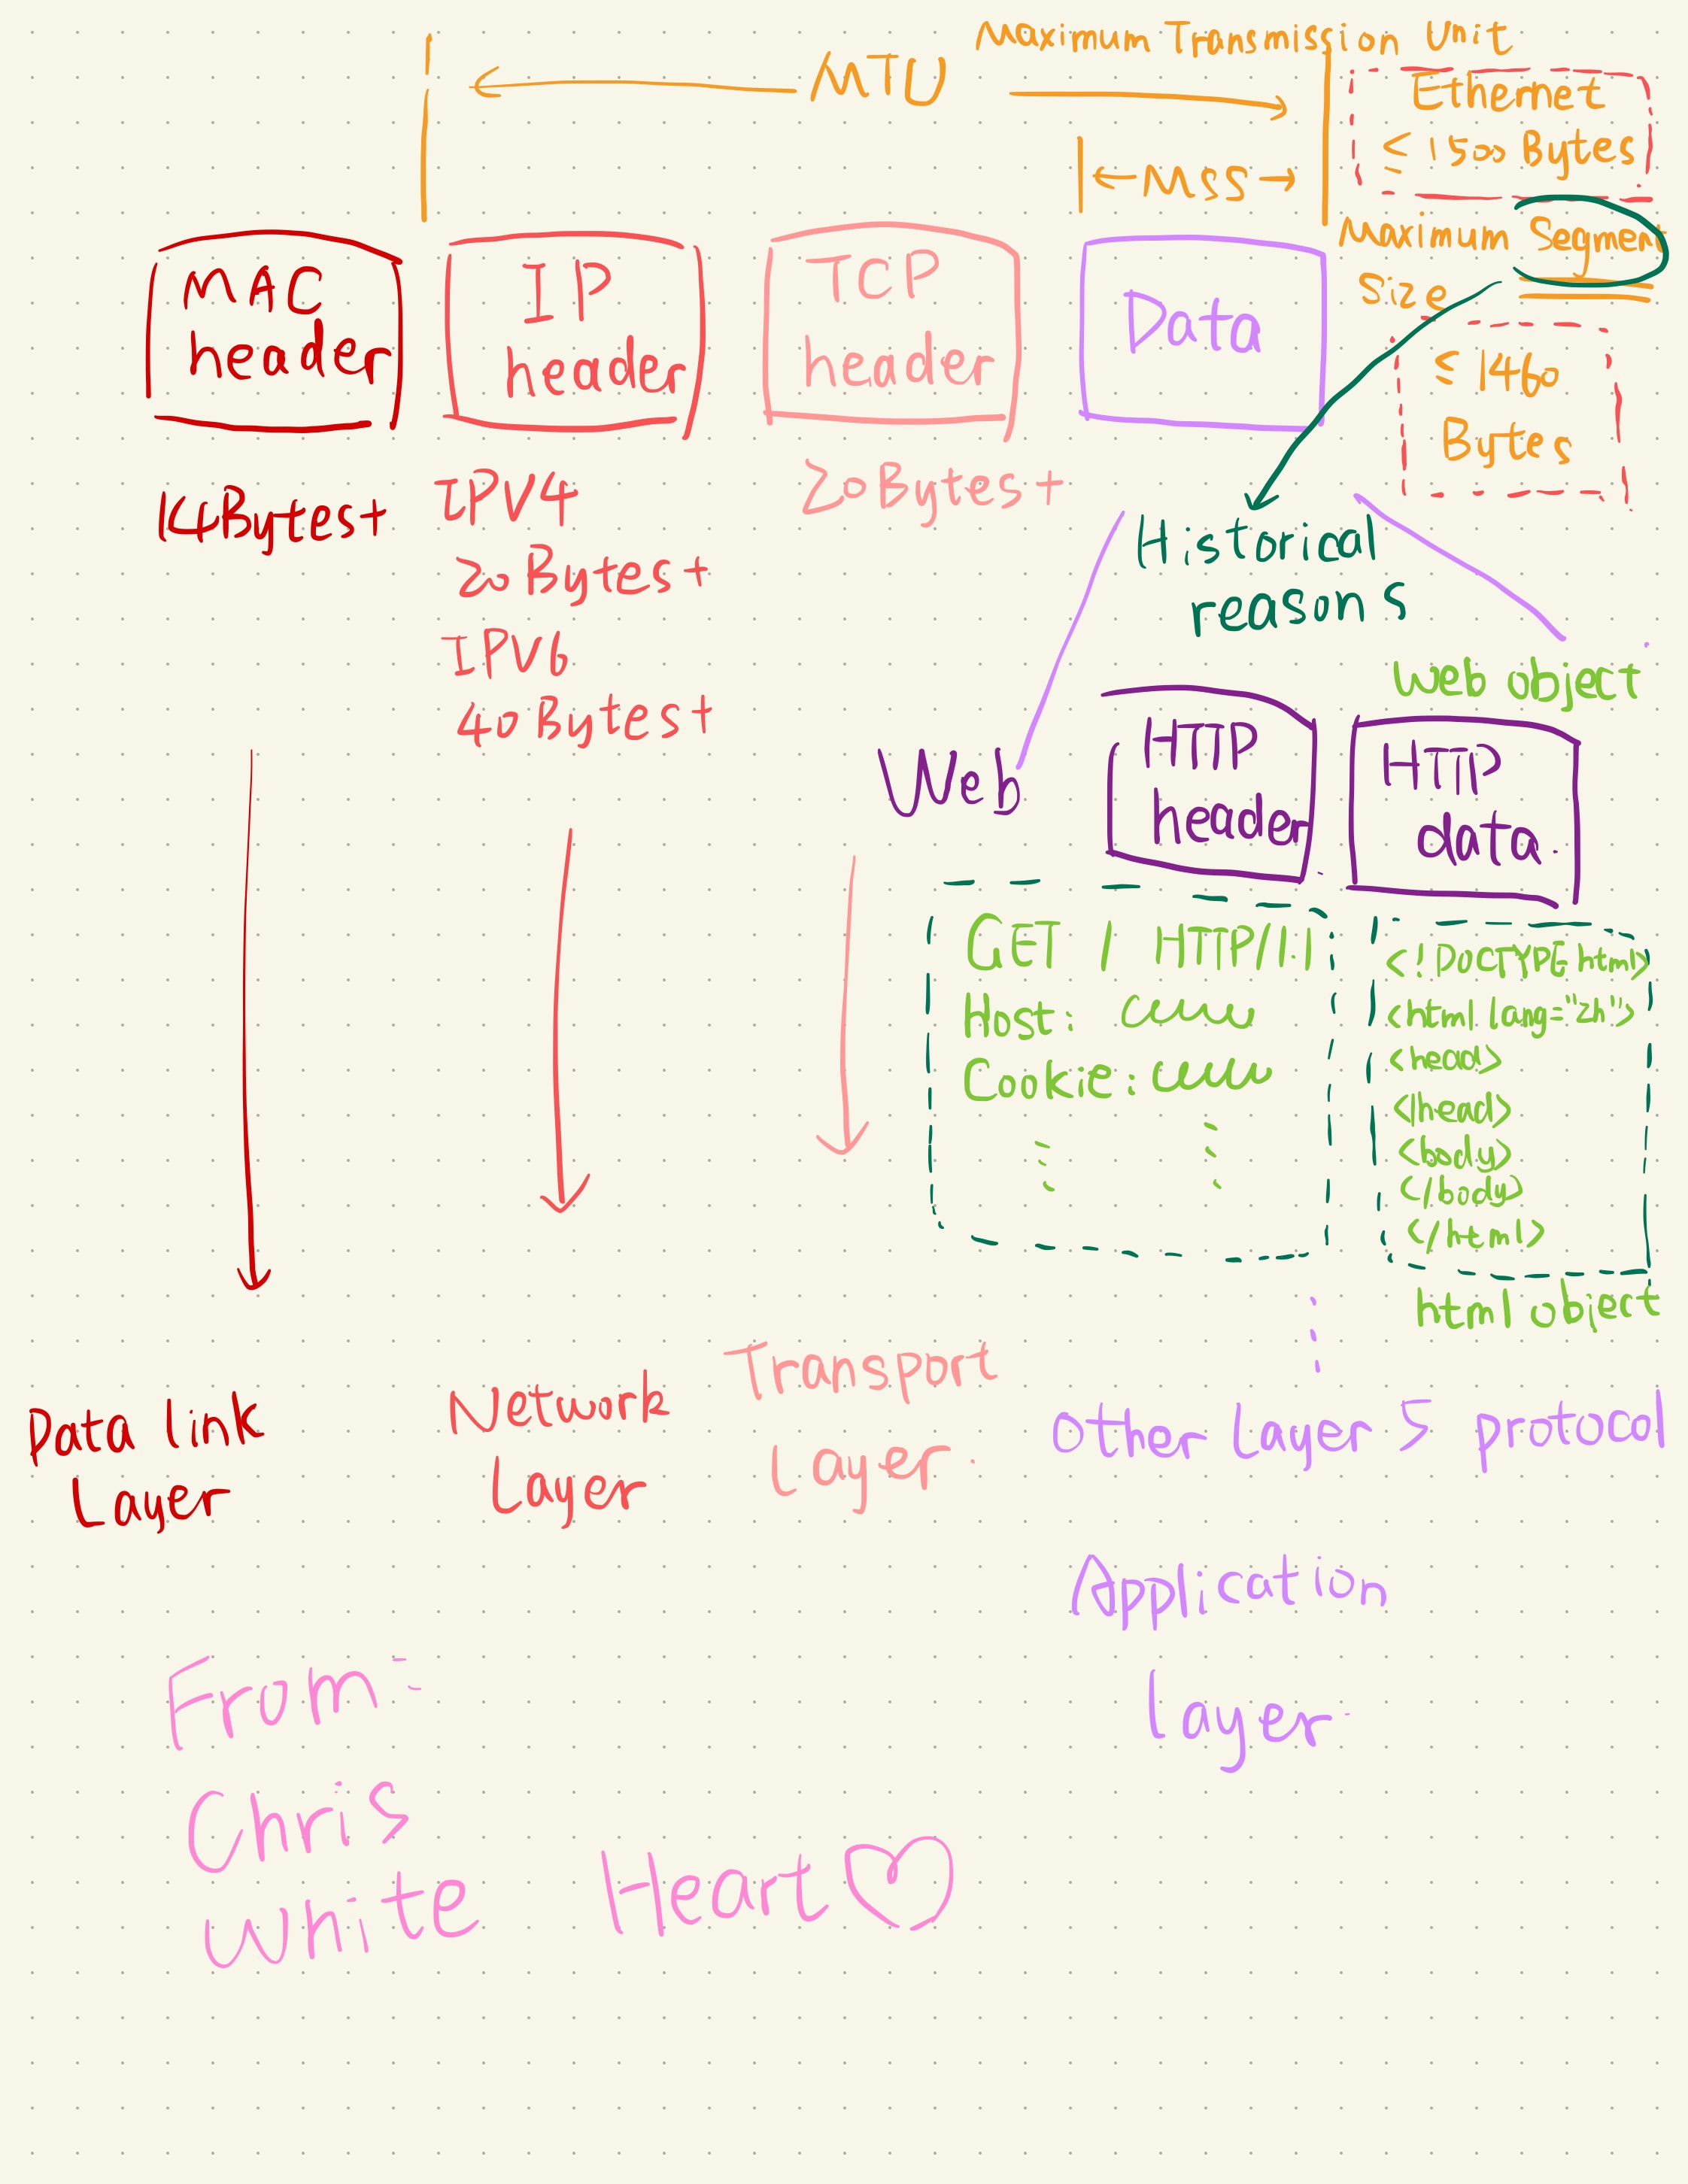
- MSS 与 MTU 辨析: 本地主机的最大链路层帧载荷称为最大传输单元(MTU)(以太网标准通常为 1500 字节)。MSS 指的是单个 TCP 报文段中应用层有效载荷数据的最大长度,不包含 TCP 首部与 IP 首部。因此以太网的标准 MSS 通常为:
TCP 报文段结构
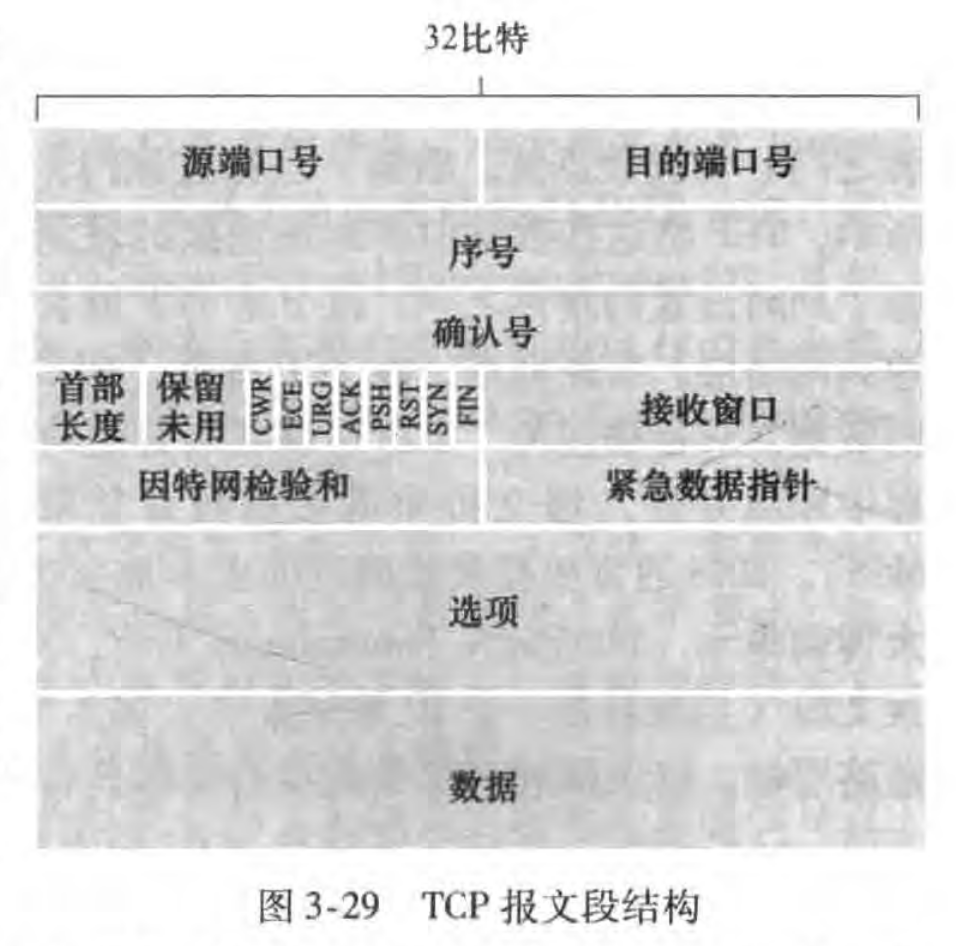
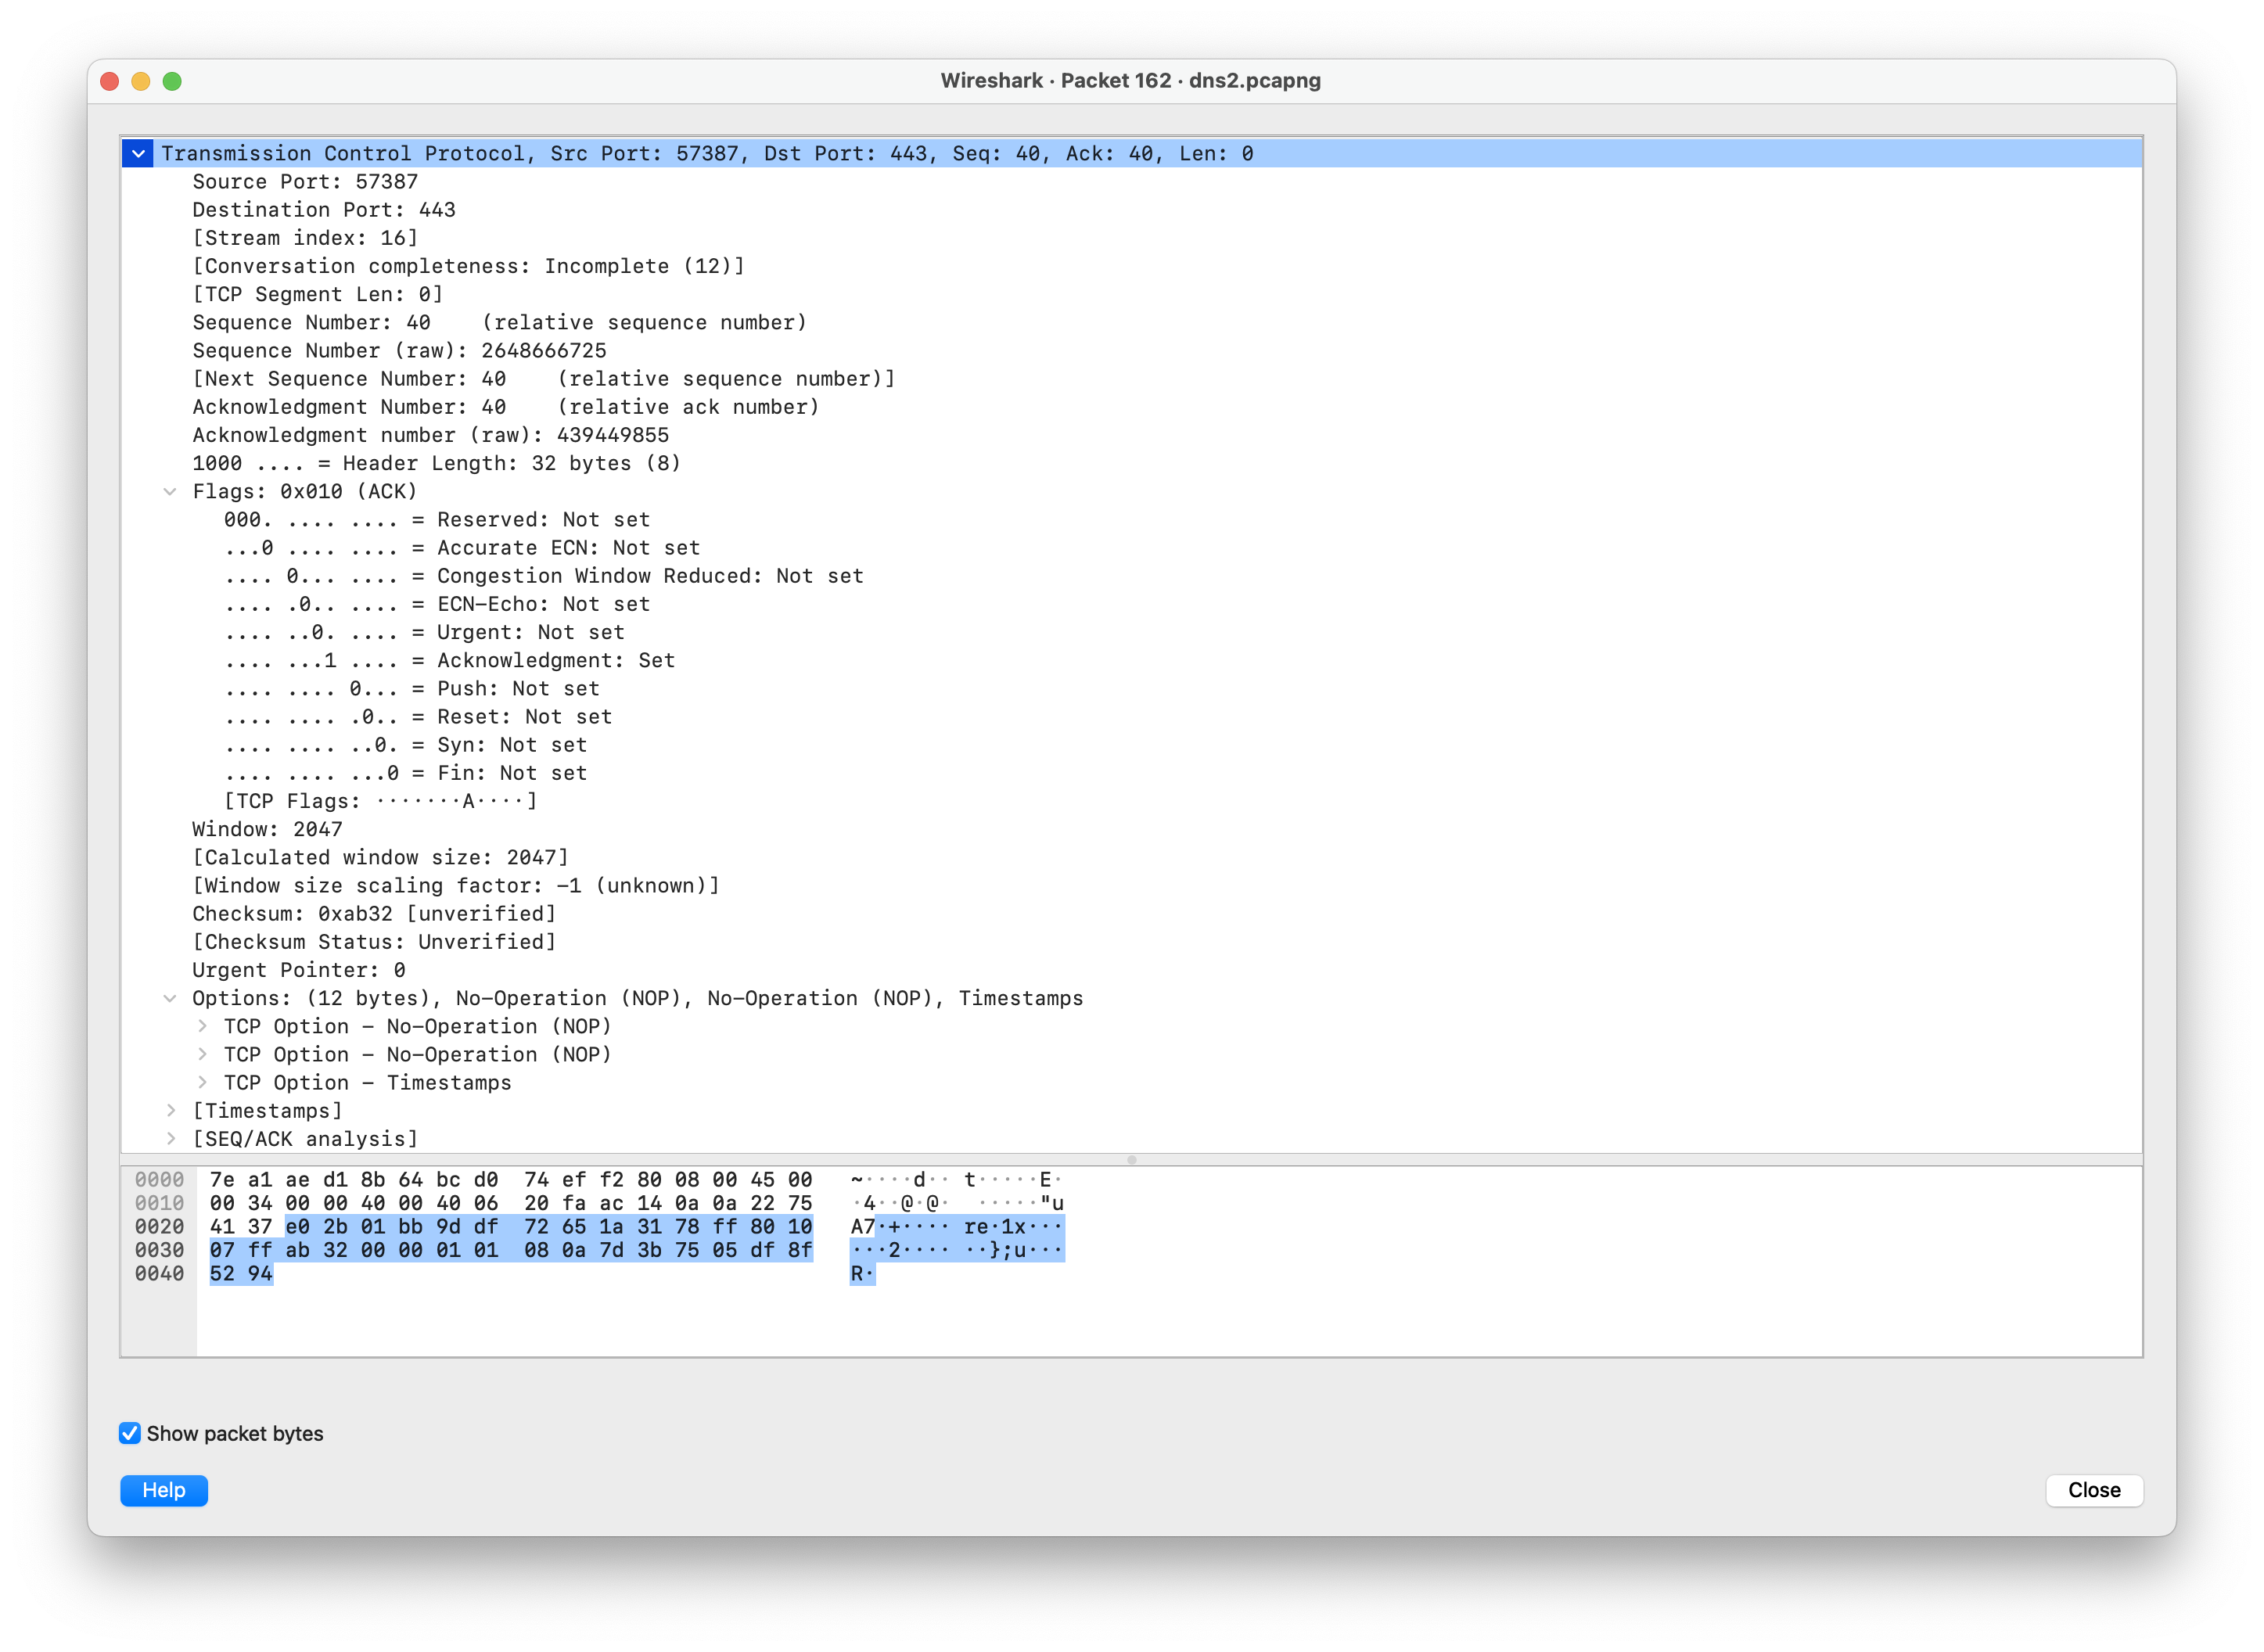
TCP 首部标准长度为 20 字节(若带可变选项则更长),各字段定义如下:
- 源端口号与目的端口号(各 16 bits):标识通信两端套接字。
- 序号(Sequence Number, 32 bits):该报文段数据载荷的第一个字节在整条发送字节流中的顺序编号。
- 确认号(Acknowledgment Number, 32 bits):接收端期望从对方收到的下一个字节的序号(累积确认)。
- 首部长度(4 bits):以 4 字节(32 位字)为单位指示 TCP 首部总长度。
- 标志字段(Flags):
Accurate ECN:指示途经路由器正经历拥塞。CWR(Congestion Window Reduced):通知对端已主动削减拥塞窗口。ECE(ECN-Echo):向发送方回显网络层检测到的显式拥塞信号。URG:紧急指针字段有效。ACK:确认号字段有效。PSH:指示接收方应尽快将缓存数据上送应用,不等待填满缓冲。RST:复位连接,强制拒绝或异常关闭连接。SYN:握手连接同步位,用于协商初始序号。FIN:发送完成标志,用于正常释放连接。
- 接收窗口(rwnd, 16 bits):用于流量控制,通告本地剩余可用接收缓存大小。
- 因特网检验和(16 bits):差错保护检验。
- 紧急数据指针(16 bits):指向紧急数据的末尾。
序号与累积确认工作机制
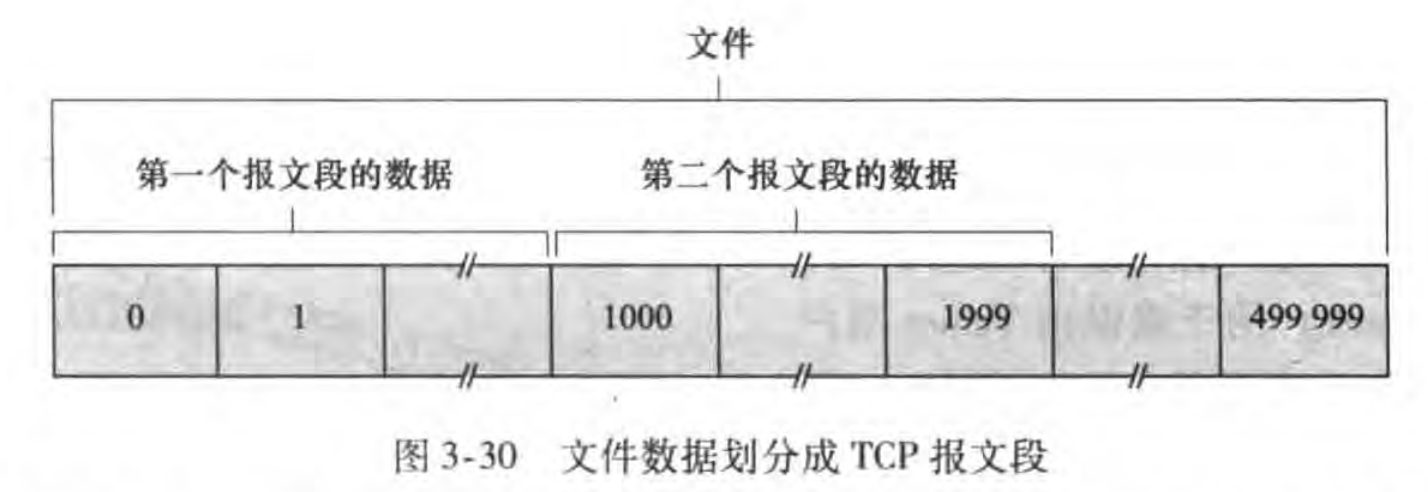
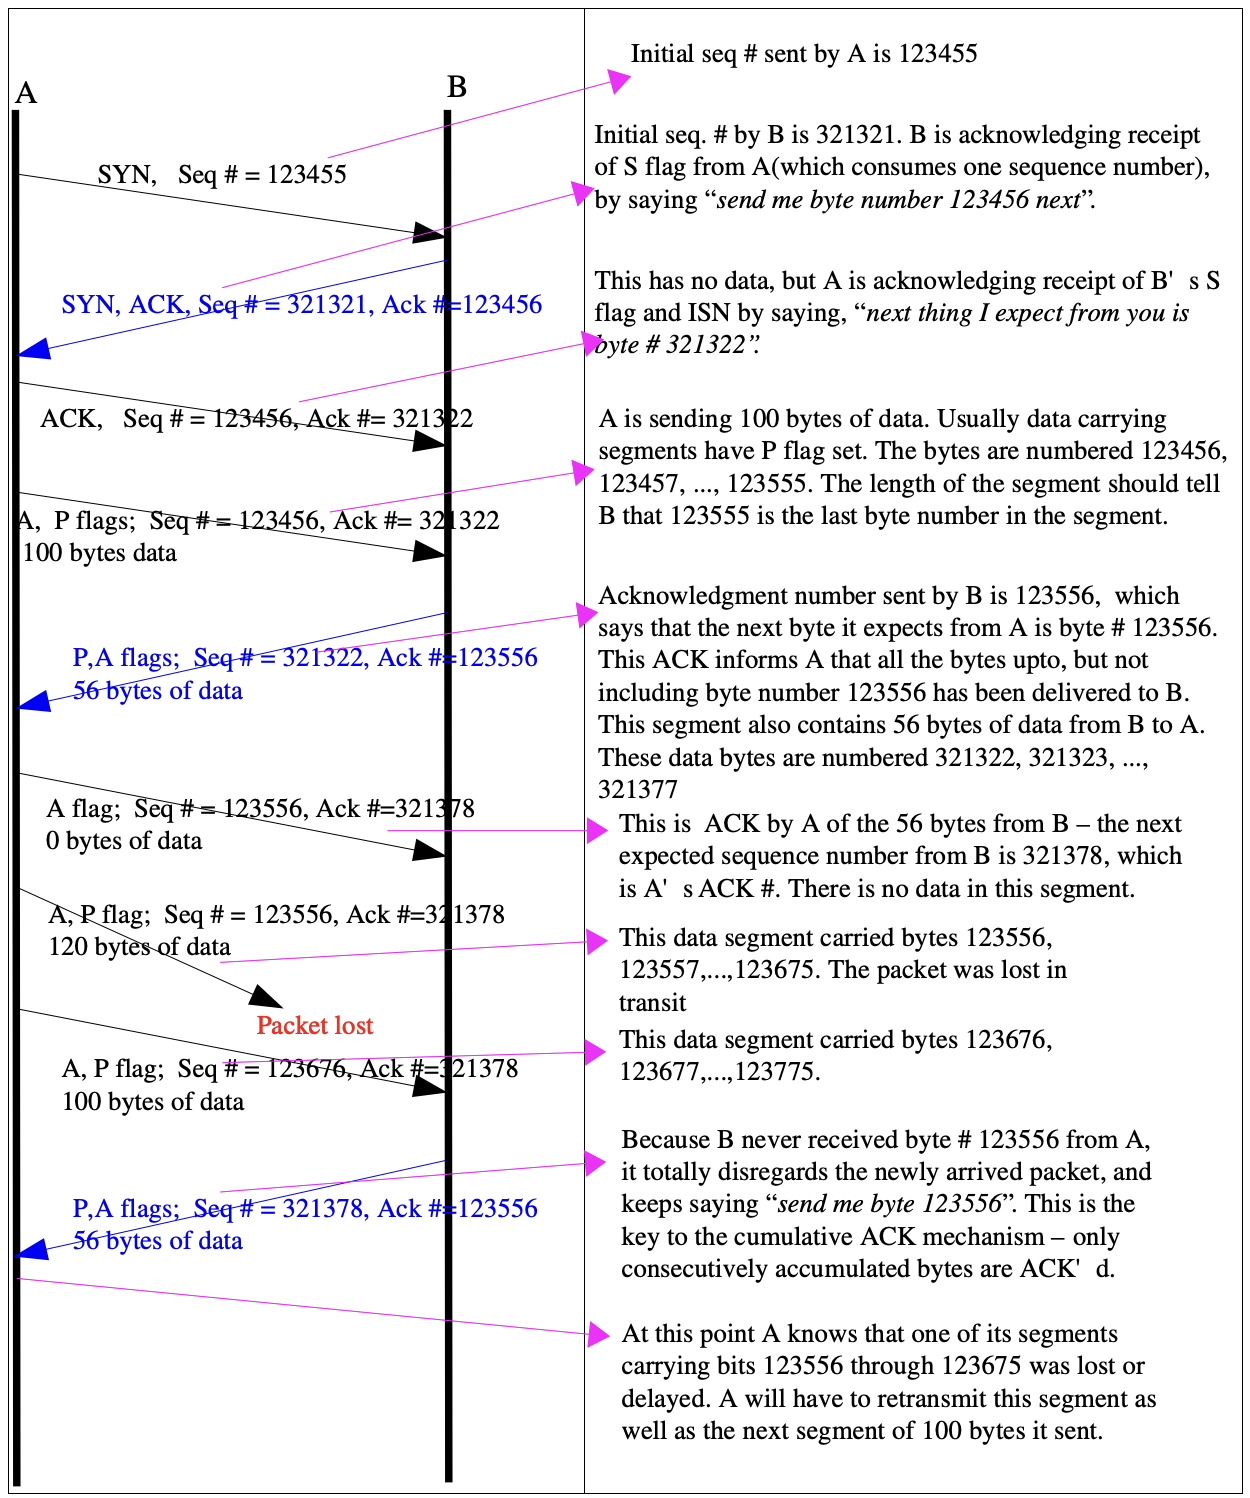
TCP 的序号按字节递增。如果主机 A 发送包含字节 0535 与 9001000 的报文段,而中间的 536~899 字节丢失:
- 主机 B 回复的确认号依然只能是
536。因为 TCP 采用累积确认(Cumulative Acknowledgment),确认号只代表“该序号之前的所有连续字节均已完好收到”。 - 现代 TCP 通常支持选择确认(SACK, RFC 2018),允许接收方在选项字段中通告失序的区间块,使发送方无需全量重传。
交互式应用:Telnet 实例分析
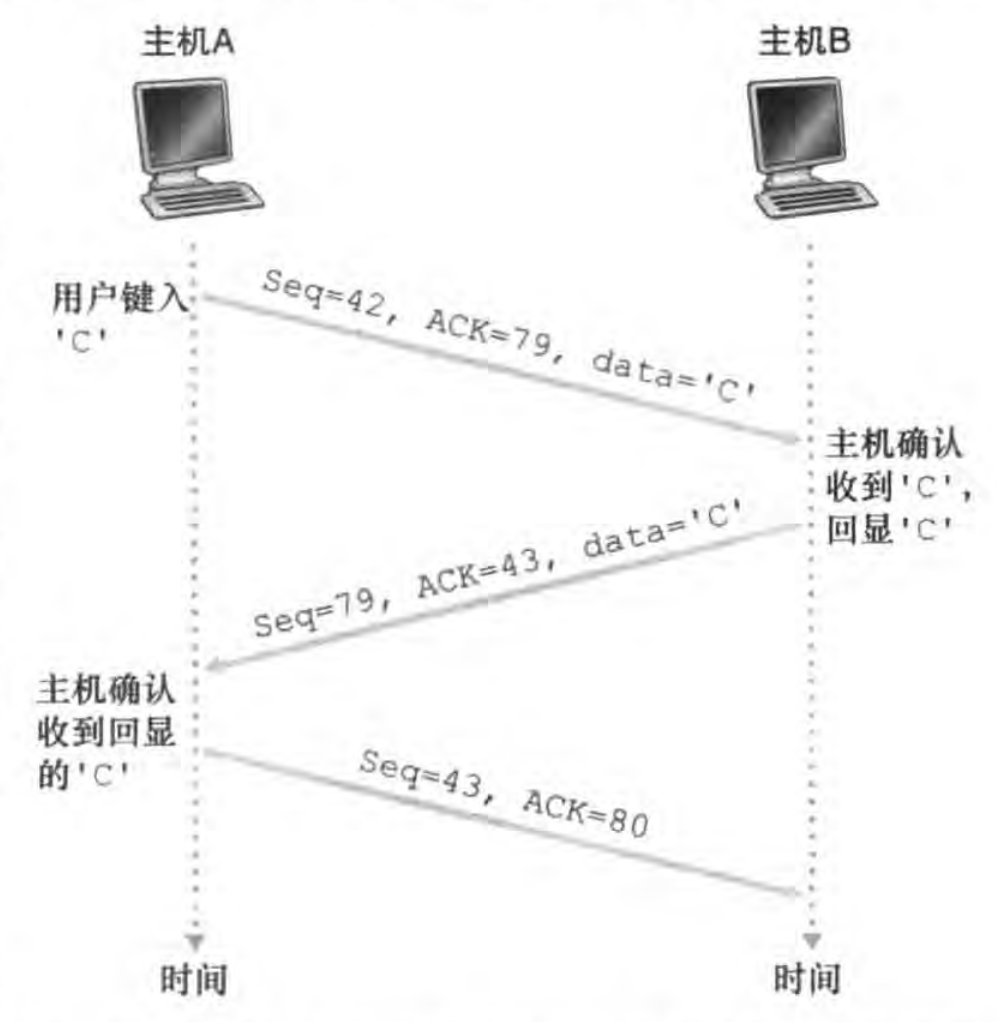
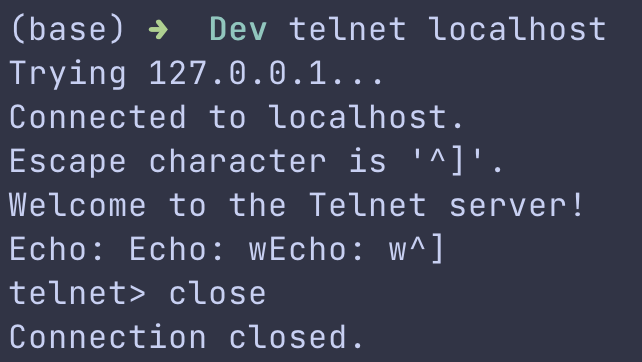
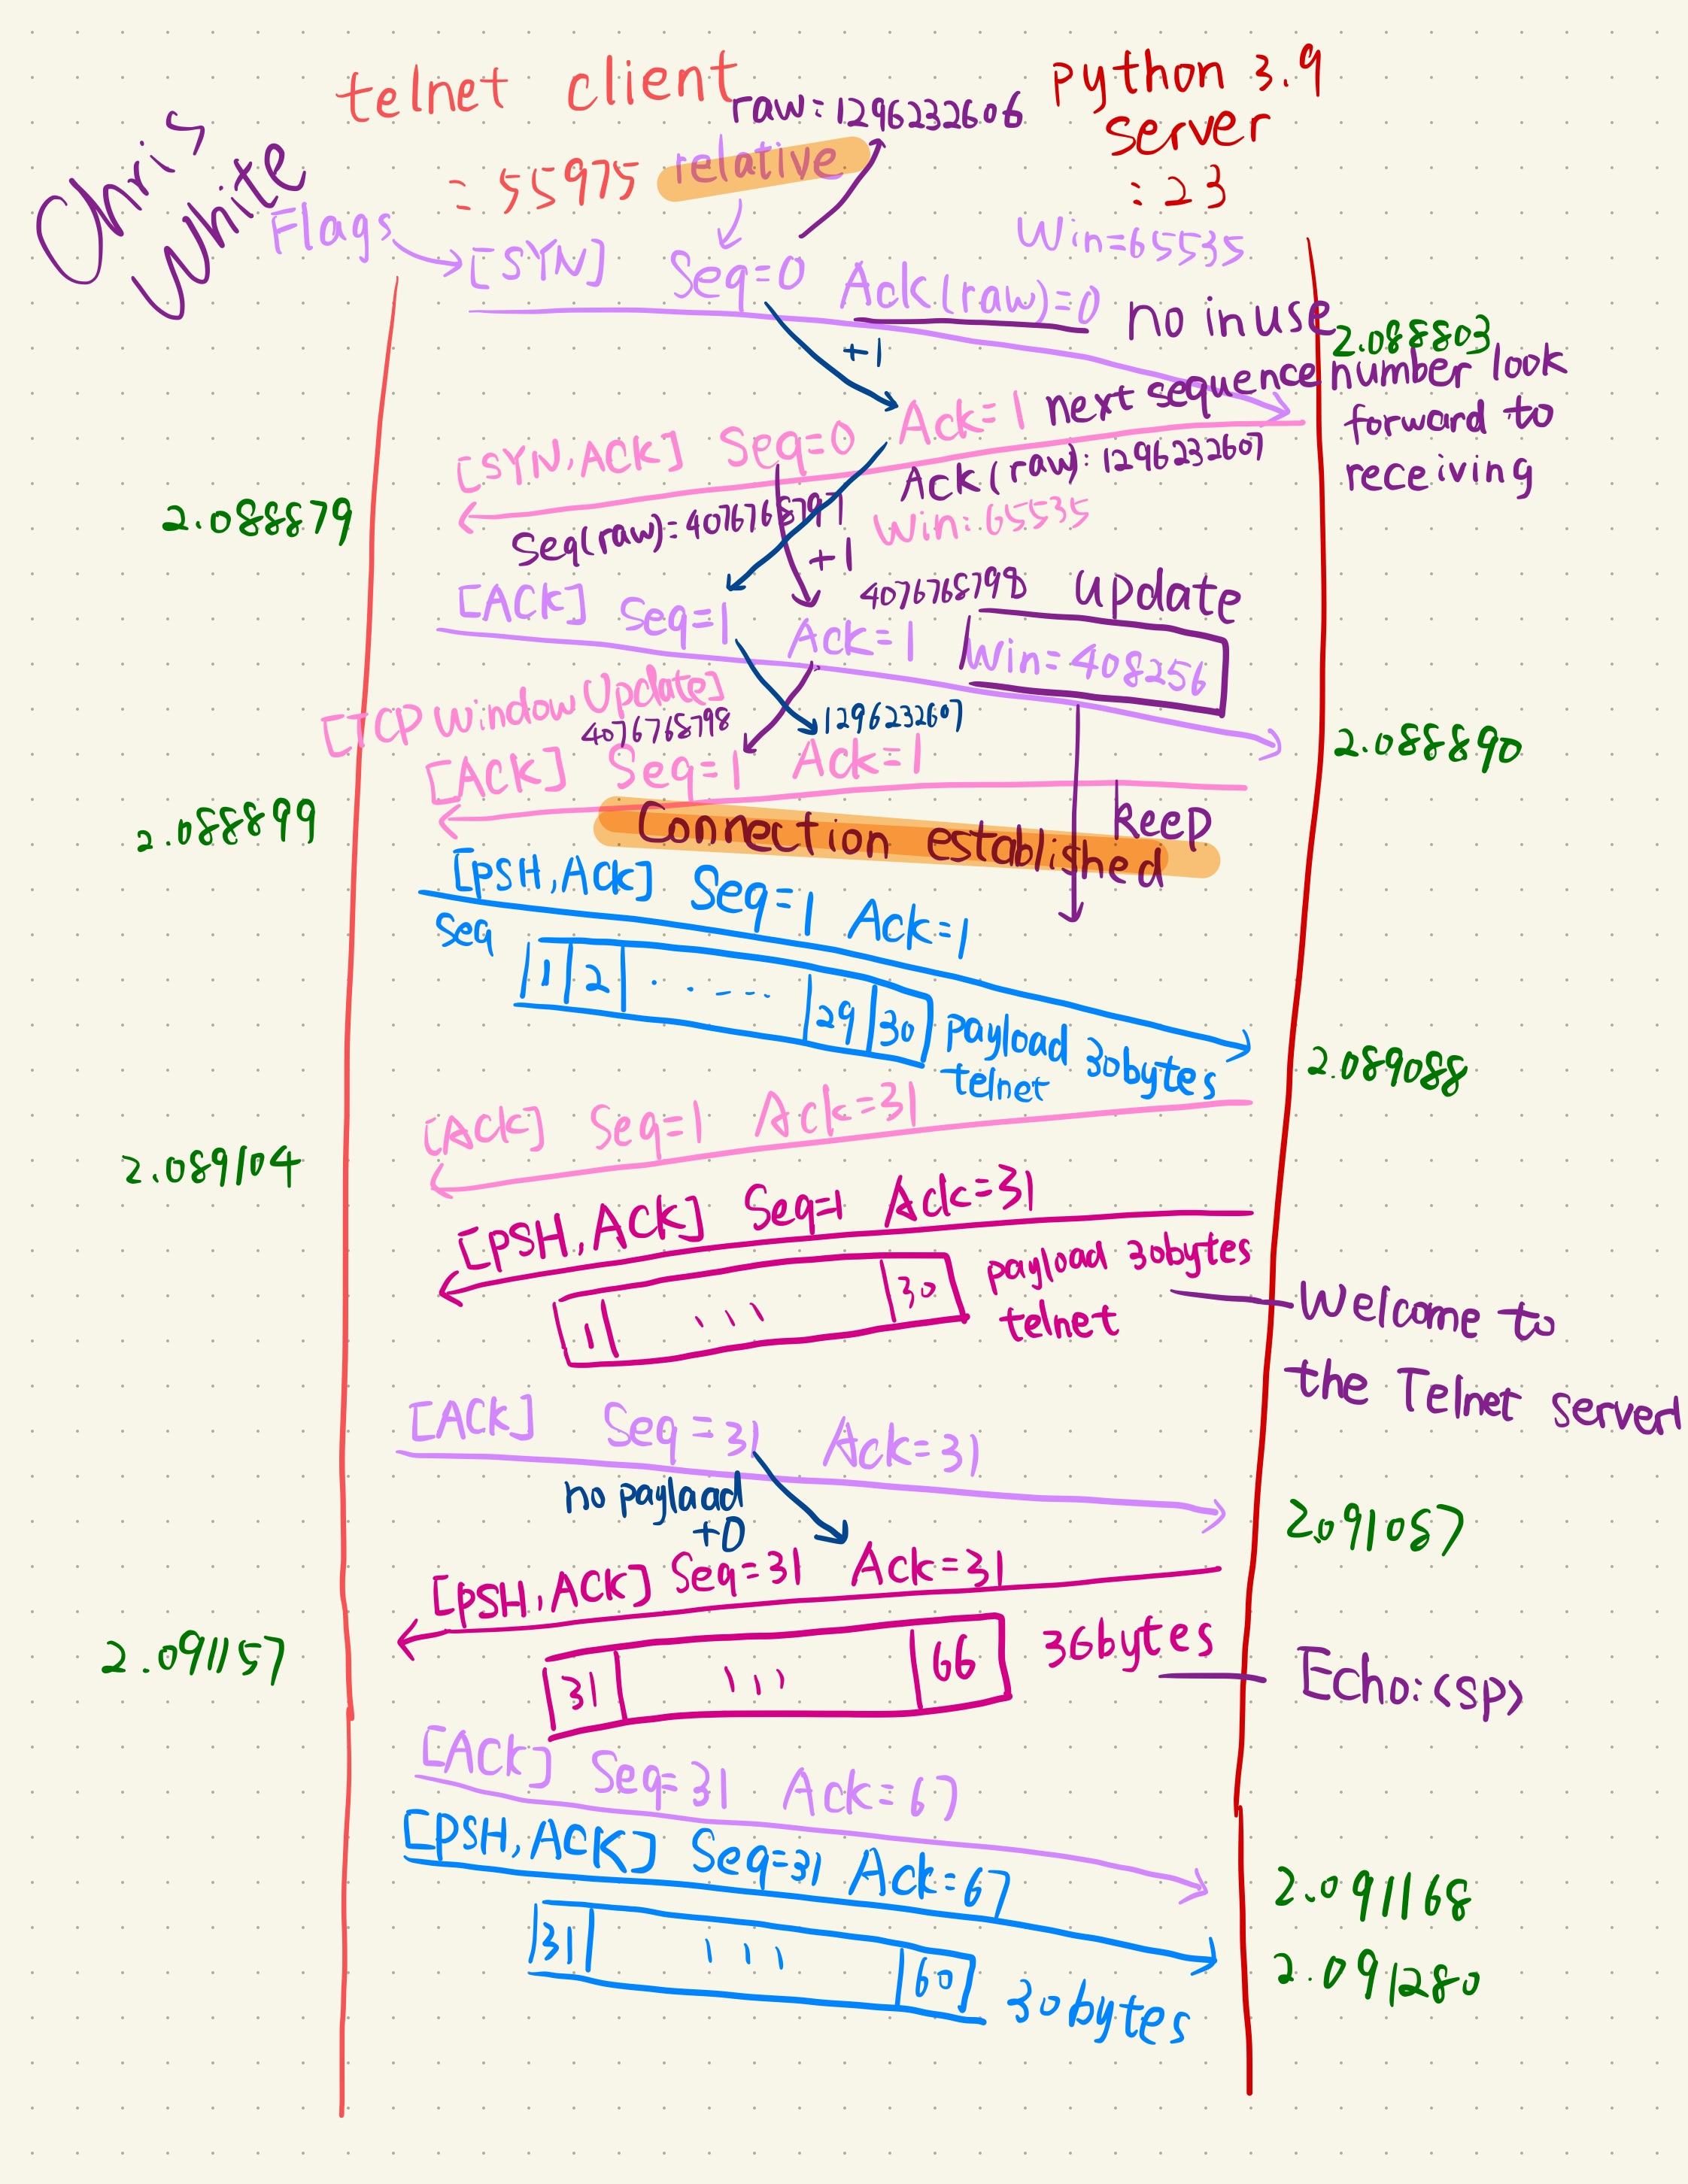
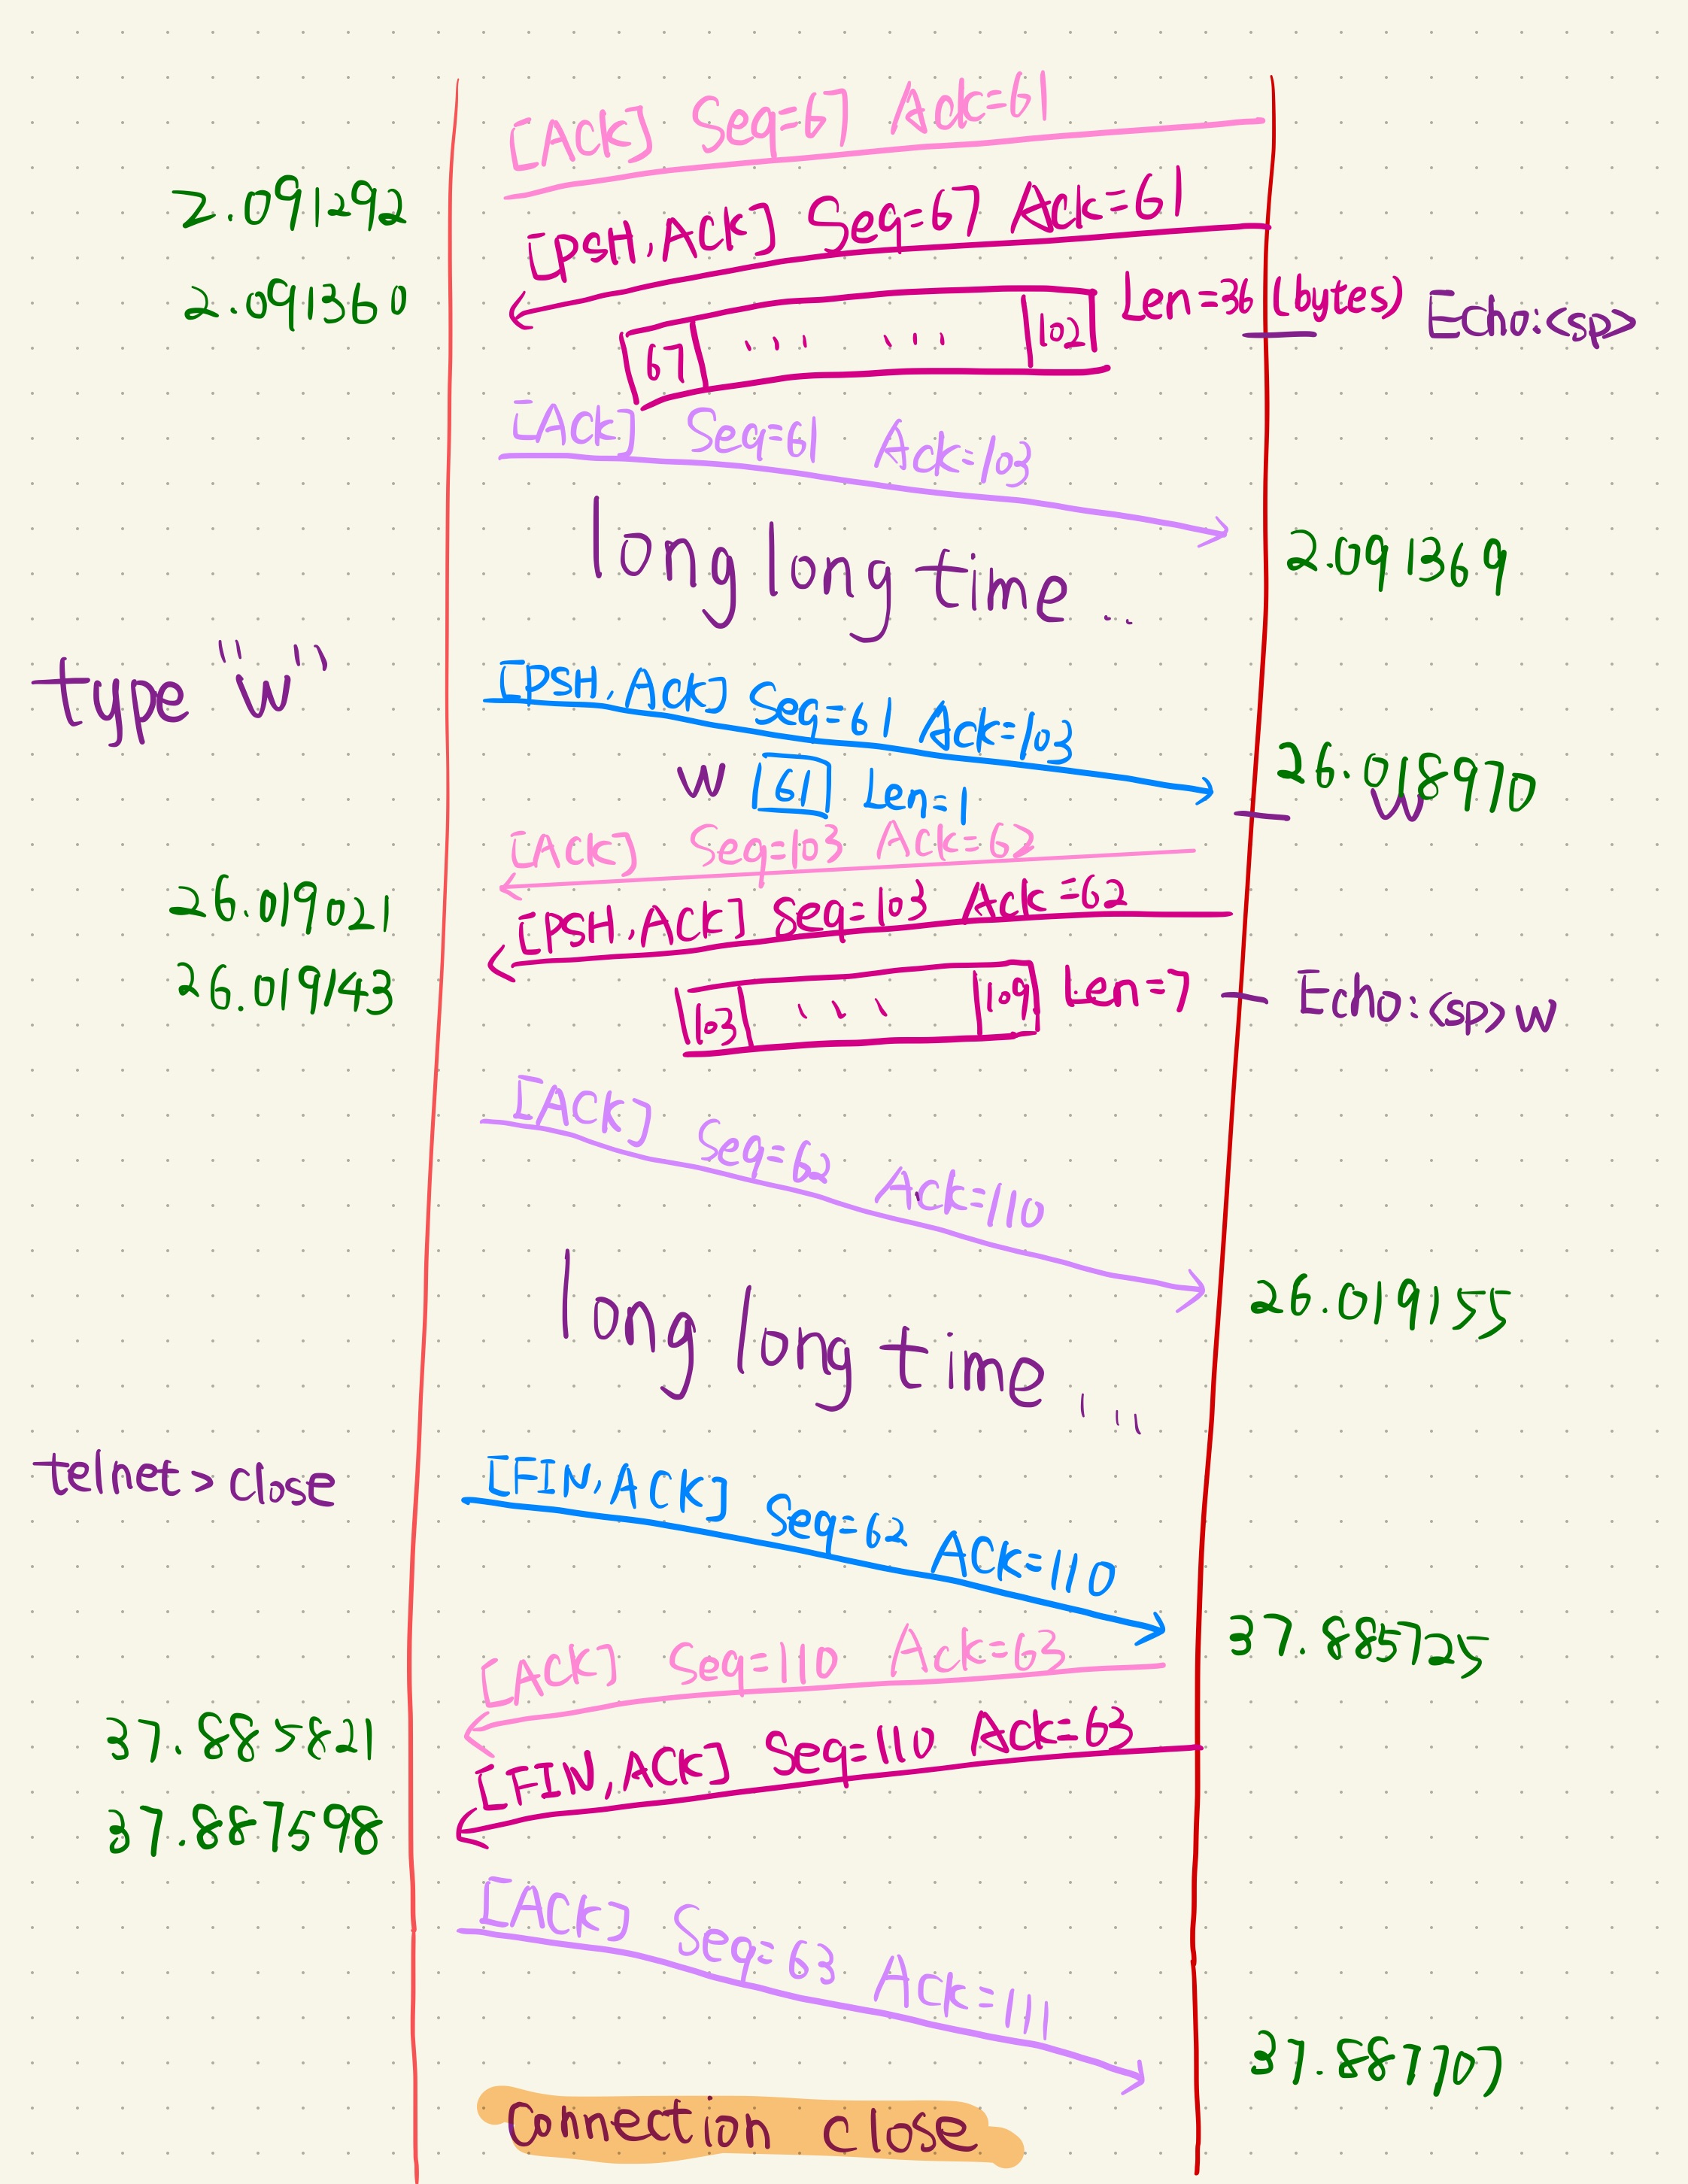
在经典的 Telnet 会话中,用户每敲击一个字符即发送一个报文段;服务端处理后将该字符回传给客户端在屏幕上 回显(Echo Back),同时将对用户输入的确认(ACK) 捎带(Piggybacked) 在回传报文段中。
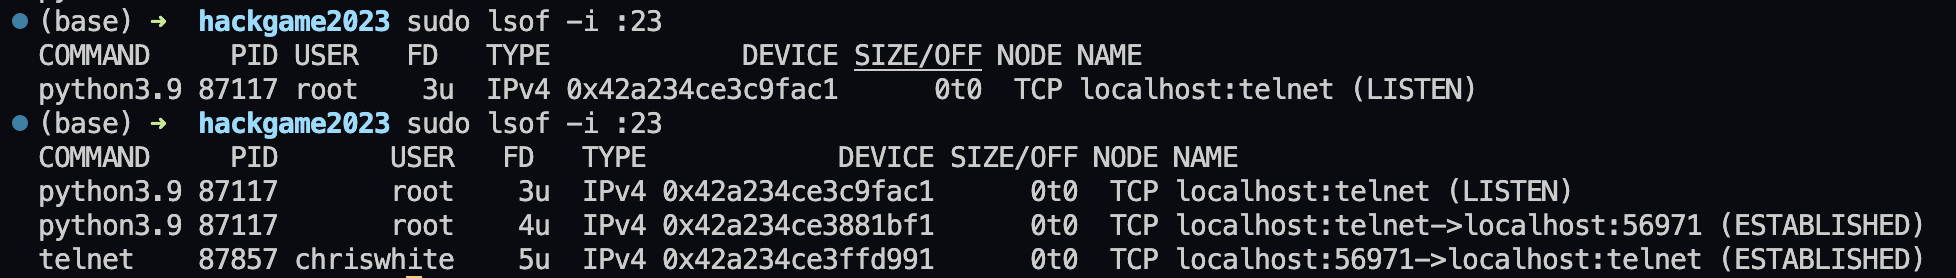
一个简单的多线程 Python Telnet 服务端实现:
import socket
import threading

def client_thread(conn, addr):
    print(f"Connected to {addr}")
    conn.send(b"Welcome to the Telnet server!\n")

    while True:
        try:
            data = conn.recv(1024)
            if not data:
                break
            conn.sendall(b"Echo: " + data)
        except ConnectionResetError:
            break

    print(f"Connection with {addr} closed")
    conn.close()

def start_telnet_server(host, port):
    server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    server_socket.bind((host, port))
    server_socket.listen(5)
    print(f"Telnet server started on {host}:{port}")

    try:
        while True:
            conn, addr = server_socket.accept()
            threading.Thread(target=client_thread, args=(conn, addr)).start()
    except KeyboardInterrupt:
        print("Shutting down the server...")
    finally:
        server_socket.close()

if __name__ == "__main__":
    HOST = "127.0.0.1"
    PORT = 23
    start_telnet_server(HOST, PORT)
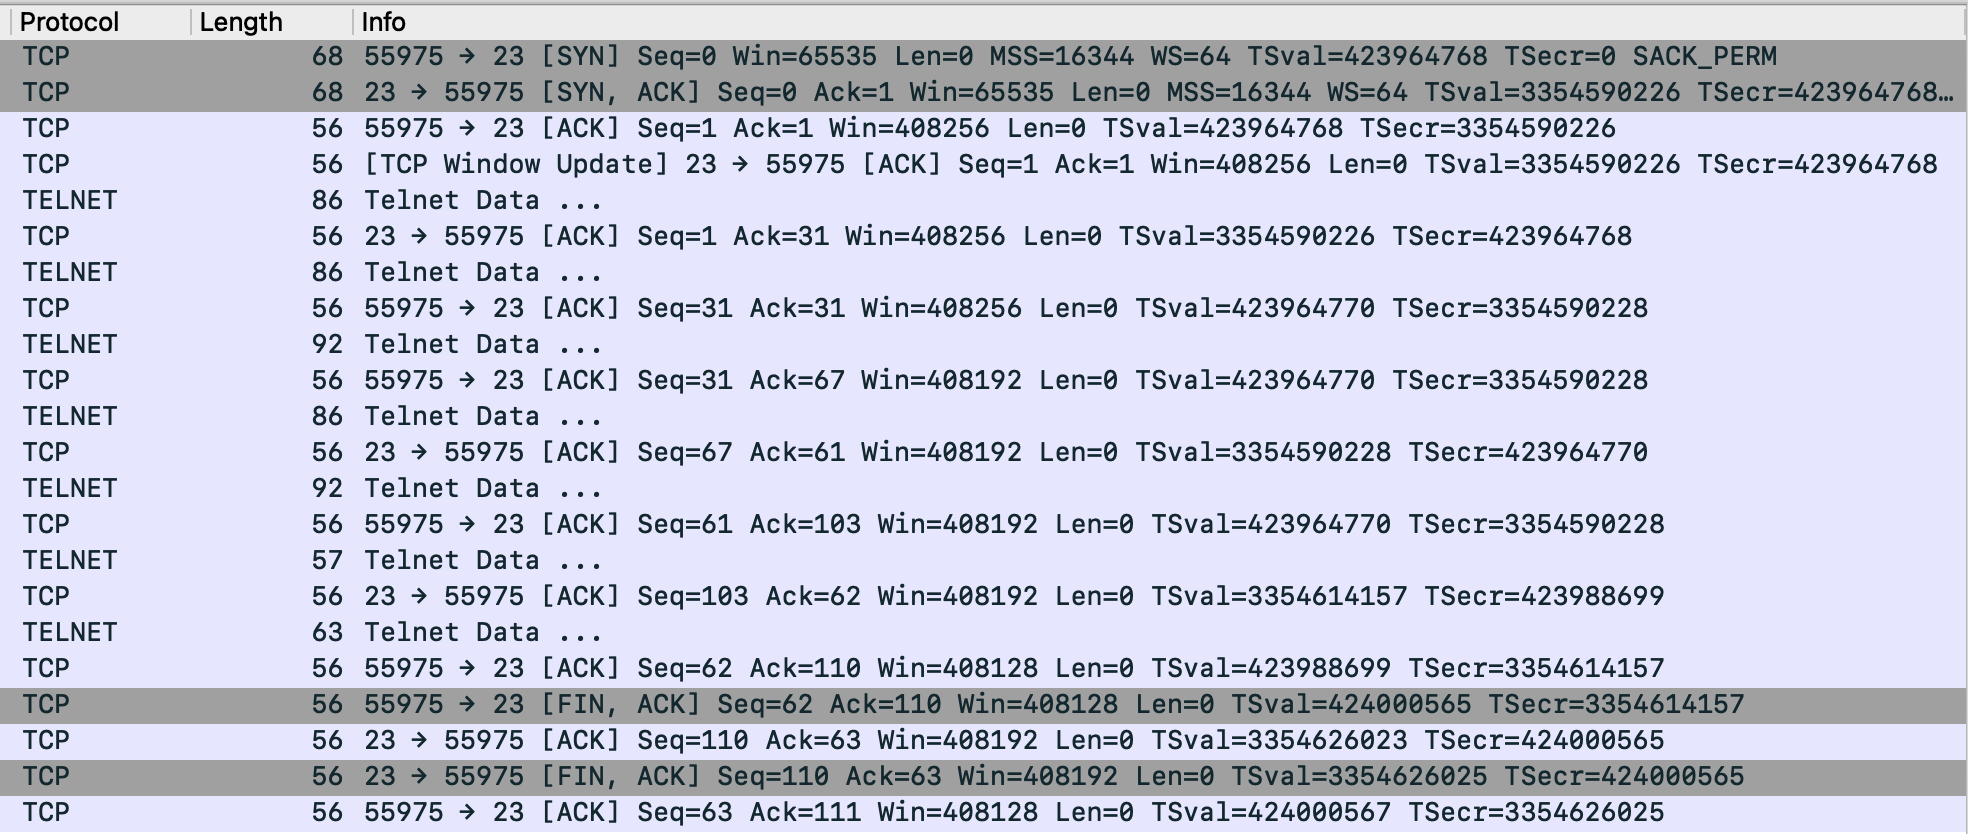
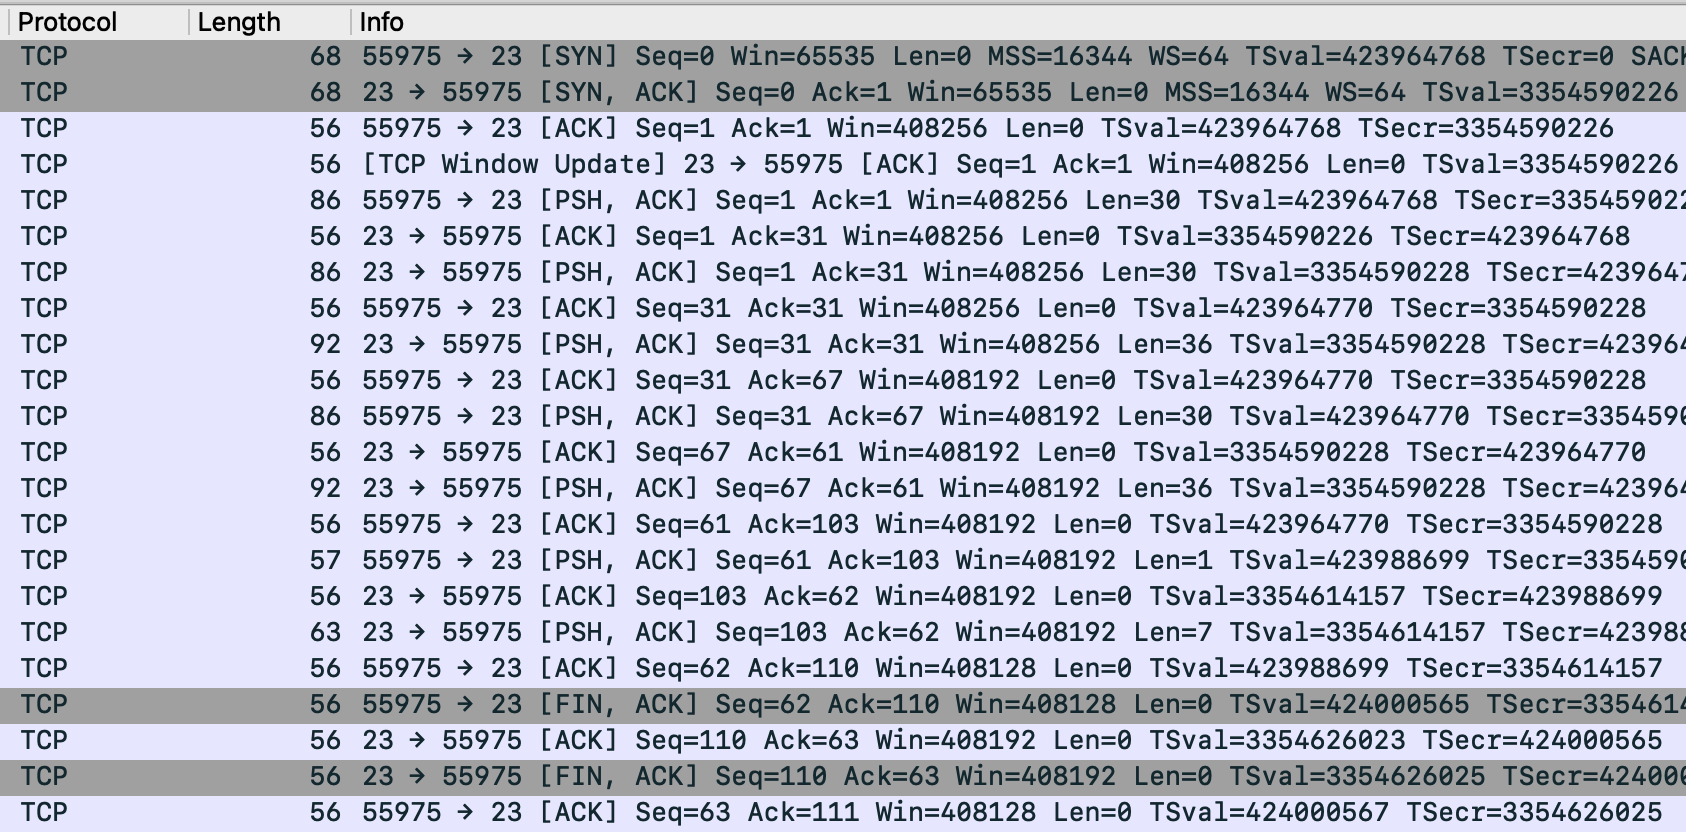
在本地回环接口上的连接状态与抓包分析:
往返时间(RTT)估计与超时设置
超时间隔(TimeoutInterval)不能过小(否则引发无谓虚假重传),也不能过大(否则丢包感知迟钝)。TCP 采用自适应的动态平滑估计:
- 样本 RTT 采集(SampleRTT):测量报文发出到收到 ACK 的时间差。遵循 Karn/Partridge 算法,严禁对发生过重传的报文段采集样本。
- 加权指数移动平均(EWMA) 更新均值:
- 估算 RTT 偏差度(DevRTT):
- 动态设定超时间隔:
TCP 可靠数据传输实现逻辑
实际操作系统中为了控制内存与中断开销,RFC 6298 推荐只维护一个单一的重传定时器,绑定到当前最早未确认的报文段上。
简化版发送端核心驱动循环:
NextSeqNum = InitialSeqNumber;
SendBase = InitialSeqNumber;

while (1) {
    switch (event) {
        case EVENT_DATA_FROM_APP: // 收到上层应用数据
            sndpkt[NextSeqNum] = make_pkt(NextSeqNum, data, checksum);
            if (isTimerInactive)
                timer_start();
            udt_send(sndpkt[NextSeqNum]);
            NextSeqNum = NextSeqNum + length(data);
            break;

        case EVENT_TIMEOUT: // 单一重传定时器超时
            udt_send(sndpkt[SendBase]); // 仅重传当前最早未应答的报文段
            timer_start();
            break;

        case EVENT_ACK_RCVD: // 收到 ACK,确认号为 y
            if (y > SendBase) {
                SendBase = y; // 累积确认向前滑动
                if (NextSeqNum > SendBase)
                    timer_start();
                else
                    timer_stop();
            }
            break;
    }
}
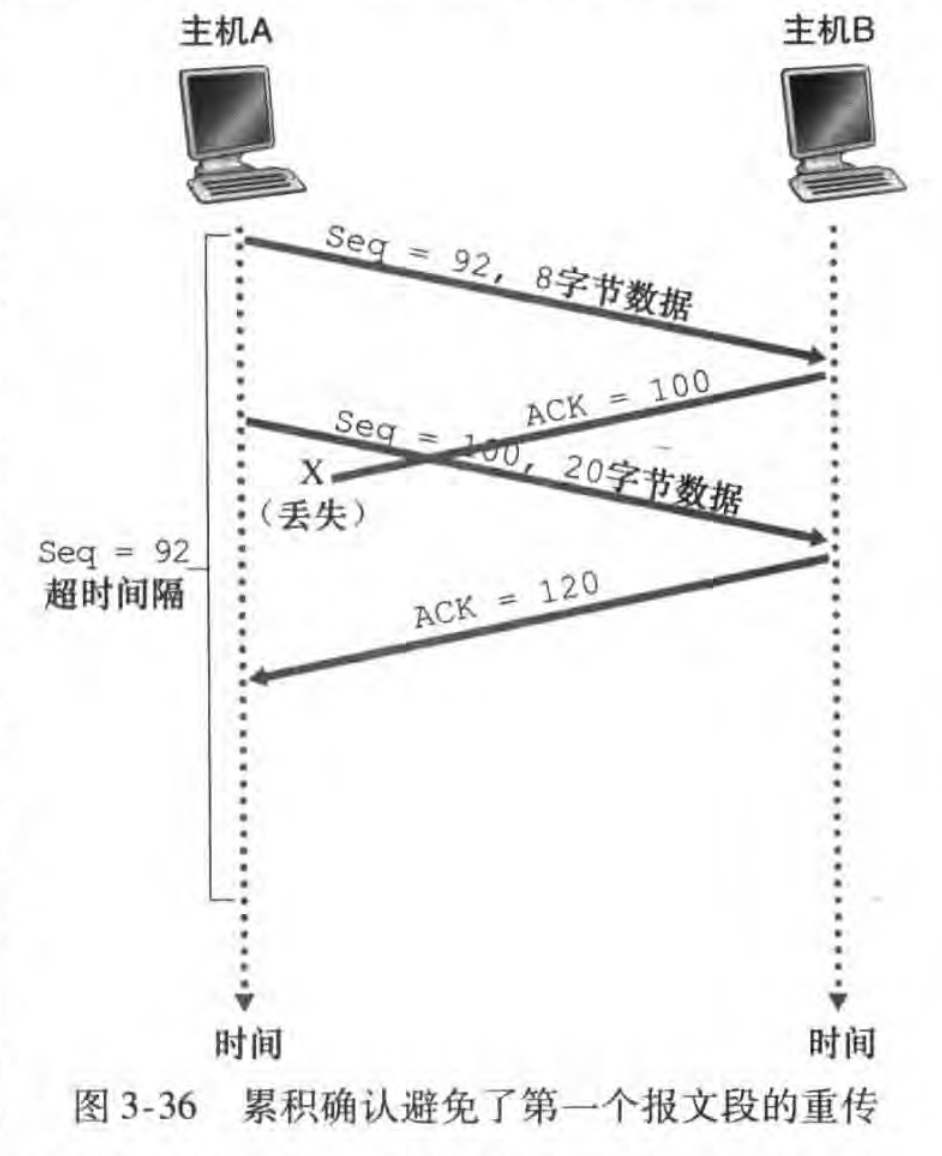
超时与累积确认的交互场景
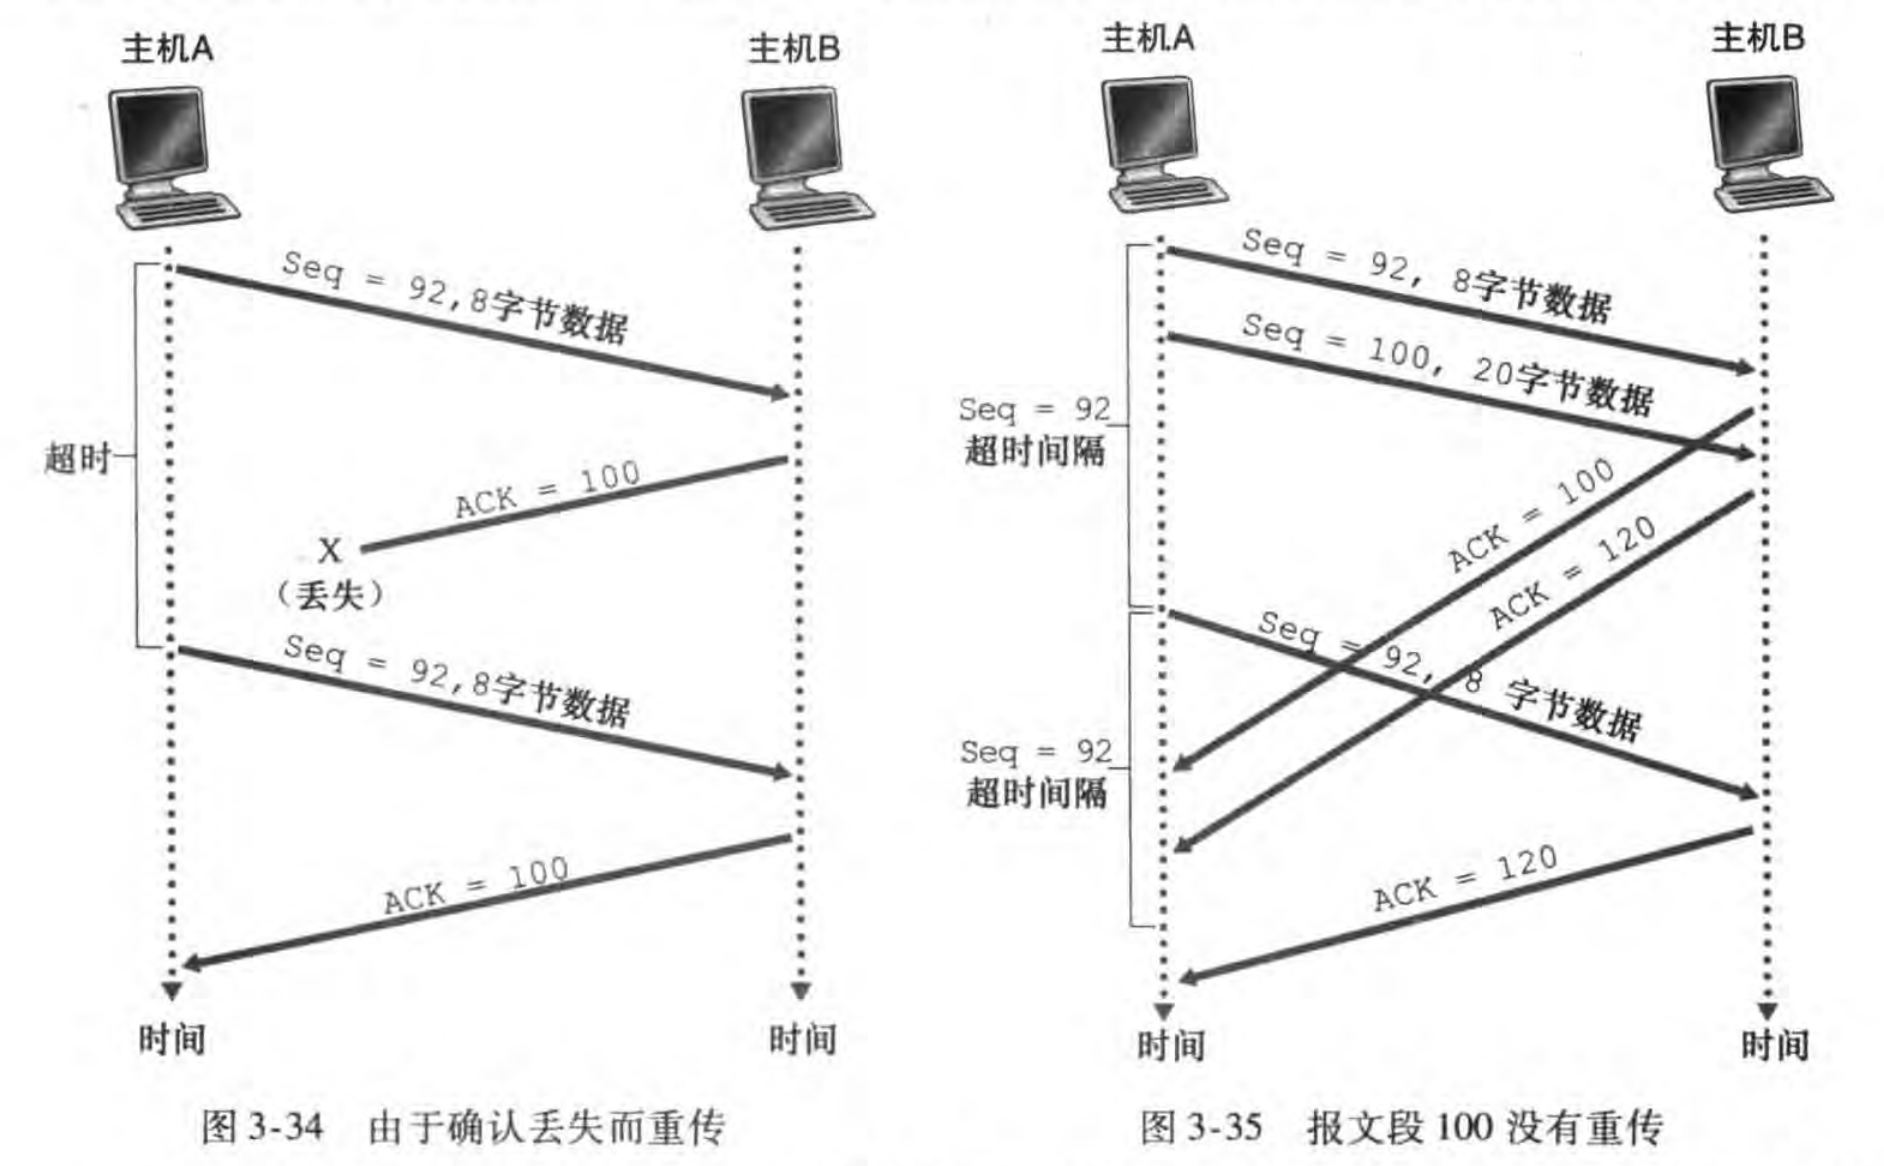
- 若连续发送两个报文段且第一个超时,发送端重传第一个;只要第二个报文段的 ACK 在新的超时到期前抵达,第二个报文段便无需重传。
- 若第一个报文段的 ACK 在网络中丢失,但第二个报文段的 ACK 成功抵达,累积确认会自动确认为止于第二个报文段的所有数据,发送端不会触发多余重传。
- 超时间隔翻倍:一旦发生超时重传,TCP 会强制将下次的超时间隔翻倍,这是一种在网络重度拥塞时的初级限流退避保护。
快速重传(Fast Retransmit)
等待定时器超时往往耗时较长。当一个报文段丢失而后续报文段正常到达时,接收端会持续发送指示当前最高有效字节的冗余 ACK(Duplicate ACK)。
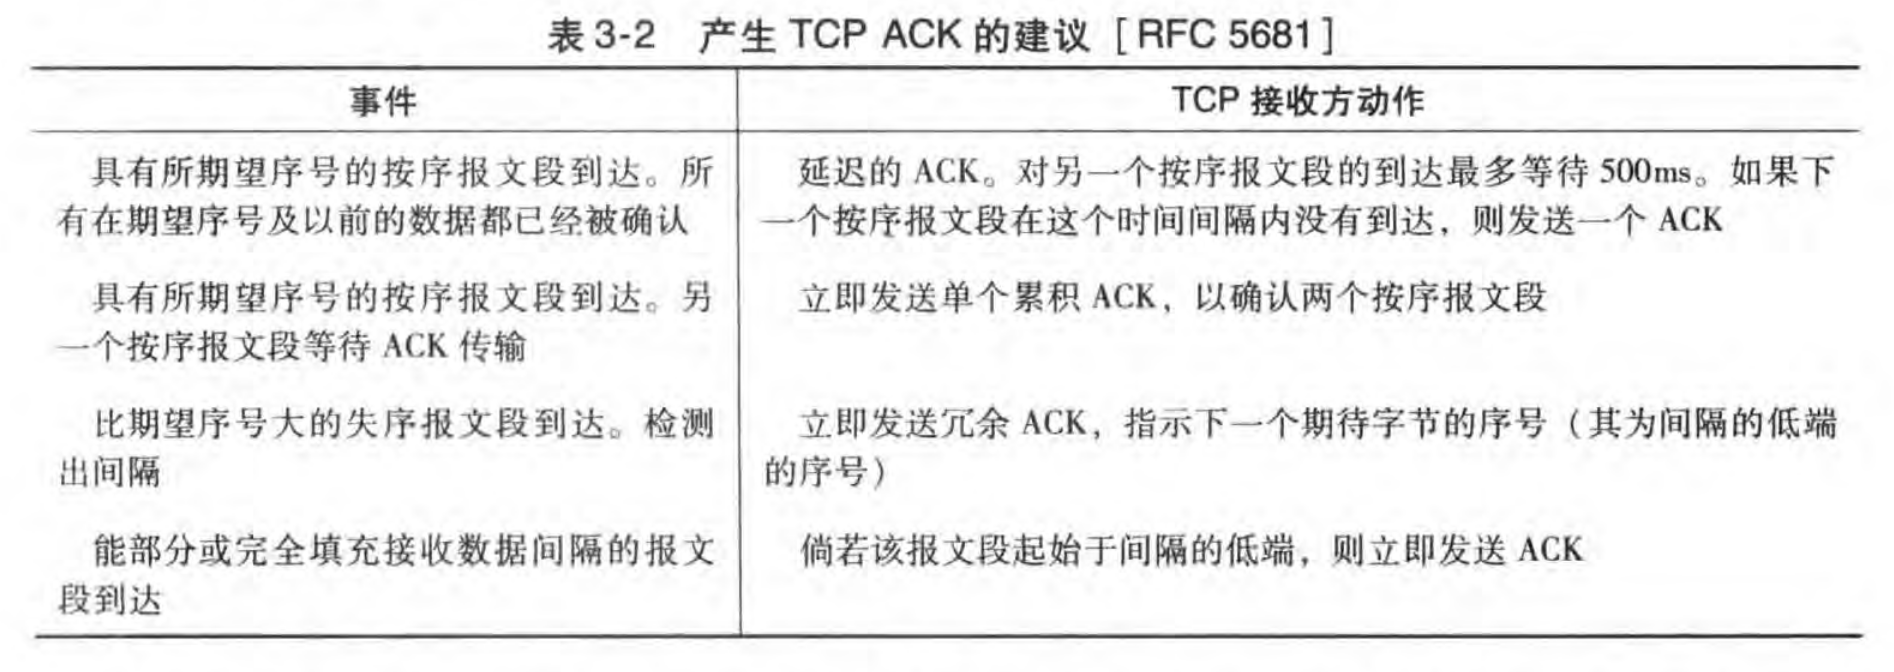
当发送方连续收到 3 个针对相同序号的冗余 ACK 时,协议断定该序号后面的报文段已经丢失,直接在定时器过期前立即触发快速重传:
if (y > SendBase) {
    SendBase = y;
    DupAck = 0;
    if (NextSeqNum > SendBase) timer_start();
} else { // 收到冗余 ACK(y == SendBase)
    DupAck++;
    if (DupAck == 3) {
        udt_send(sndpkt[y]); // 快速重传丢失的报文段
    }
}
流量控制
流量控制服务(Flow-Control)专门解决发送方因传输过快而撑爆接收方主机应用缓存的问题(这与底层网络拥塞控制有根本区别)。
发送方通过接收方在首部通告的 接收窗口(rwnd) 进行速率限制。设接收方已分配缓存为 RcvBuffer,LastByteRead 为应用读取的最大字节,LastByteRcvd 为网络收到的最大字节:
发送方必须保证未确认在飞数据量受限于 rwnd:
若 rwnd == 0,发送端会周期性发送 1 字节的探测报文,防止接收方后续在更新窗口时因 ACK 丢失而引发双方死锁。
TCP 连接管理:三次握手与四次挥手
三次握手建立连接:
- SYN 报文:客户端发送
SYN=1,随机选择初始序列号seq = client_isn。 - SYN-ACK 报文:服务器分配 TCP 缓存并回复
SYN=1, ACK=1, seq = server_isn, ack = client_isn + 1。 - ACK 报文:客户端分配缓存并回发
ACK=1, ack = server_isn + 1(此时可以开始携带实际数据)。
四次挥手释放连接:
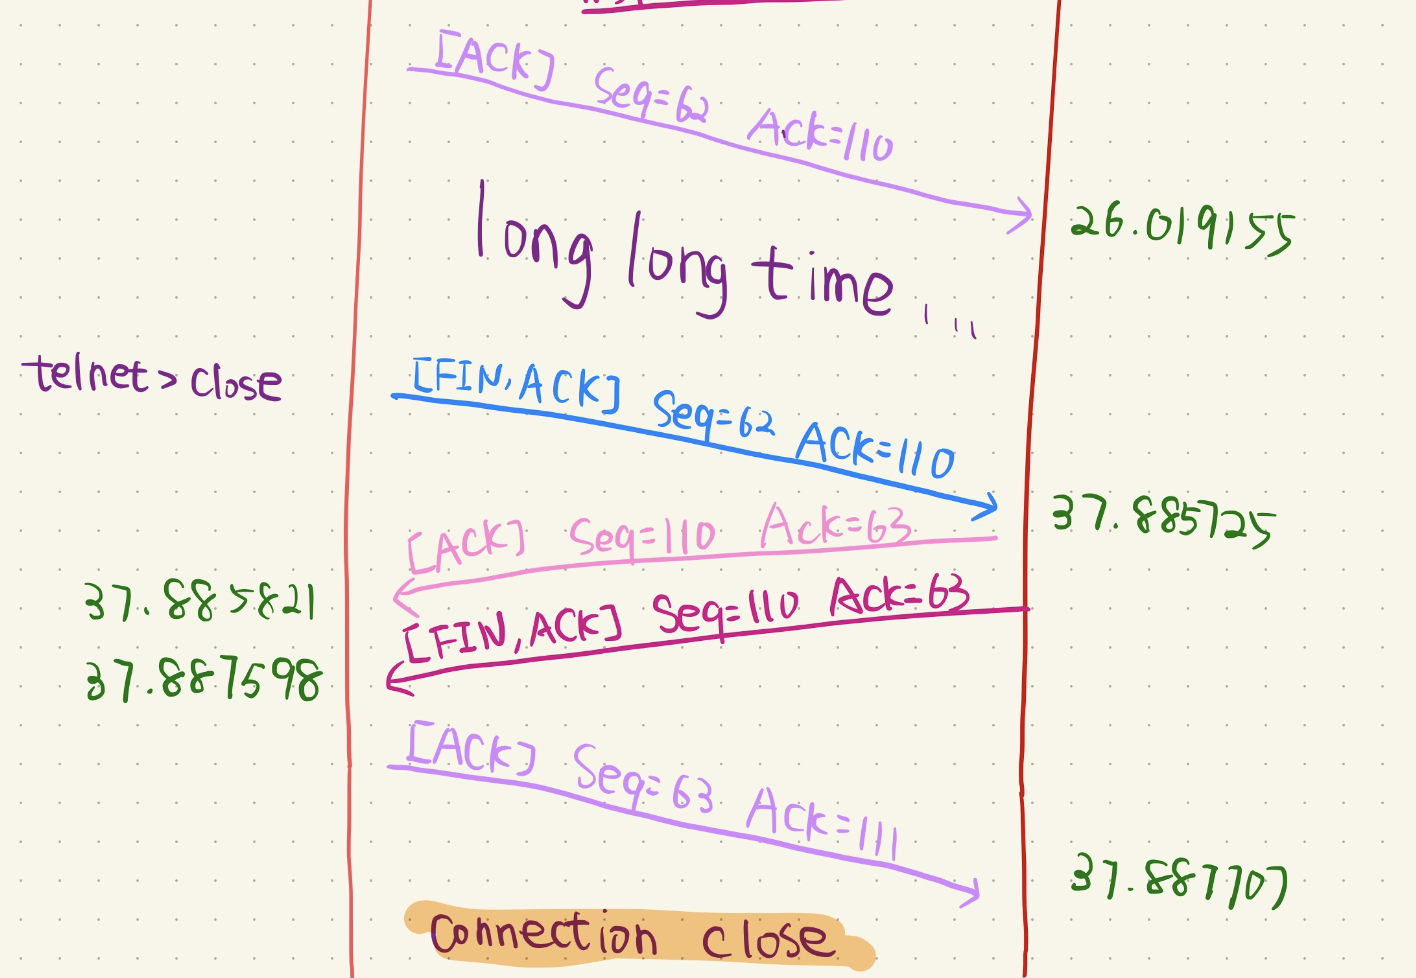
全双工连接必须在两个单向维度上分别关闭:一方发送 FIN=1 并由对方确认 ACK;对方准备就绪后再发出自己的 FIN=1 并由发起方完成最终确认。
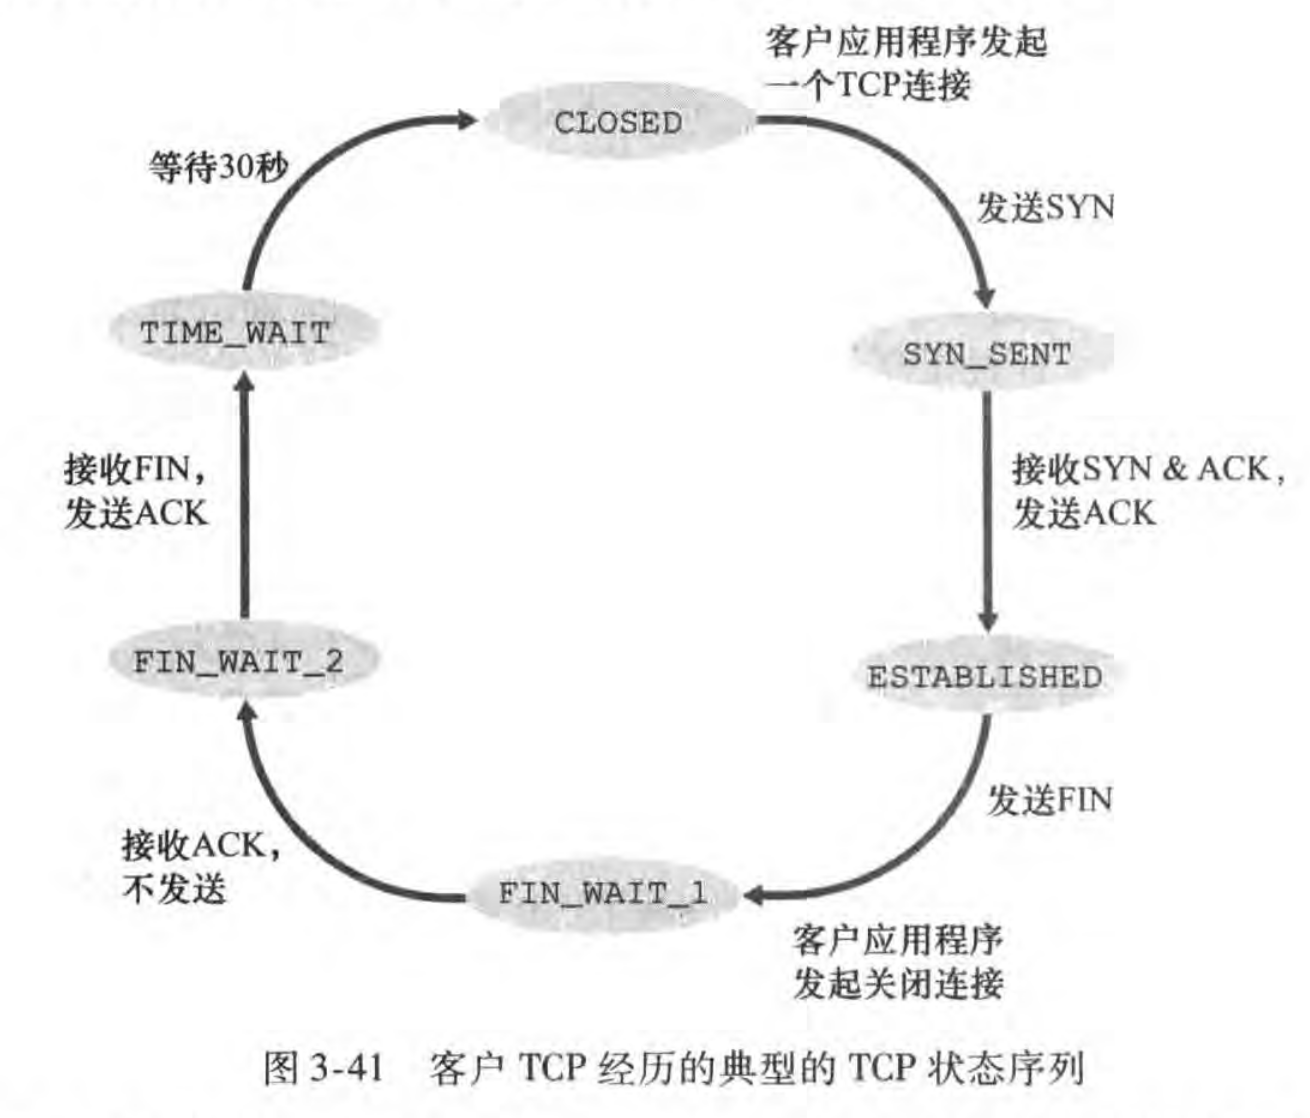
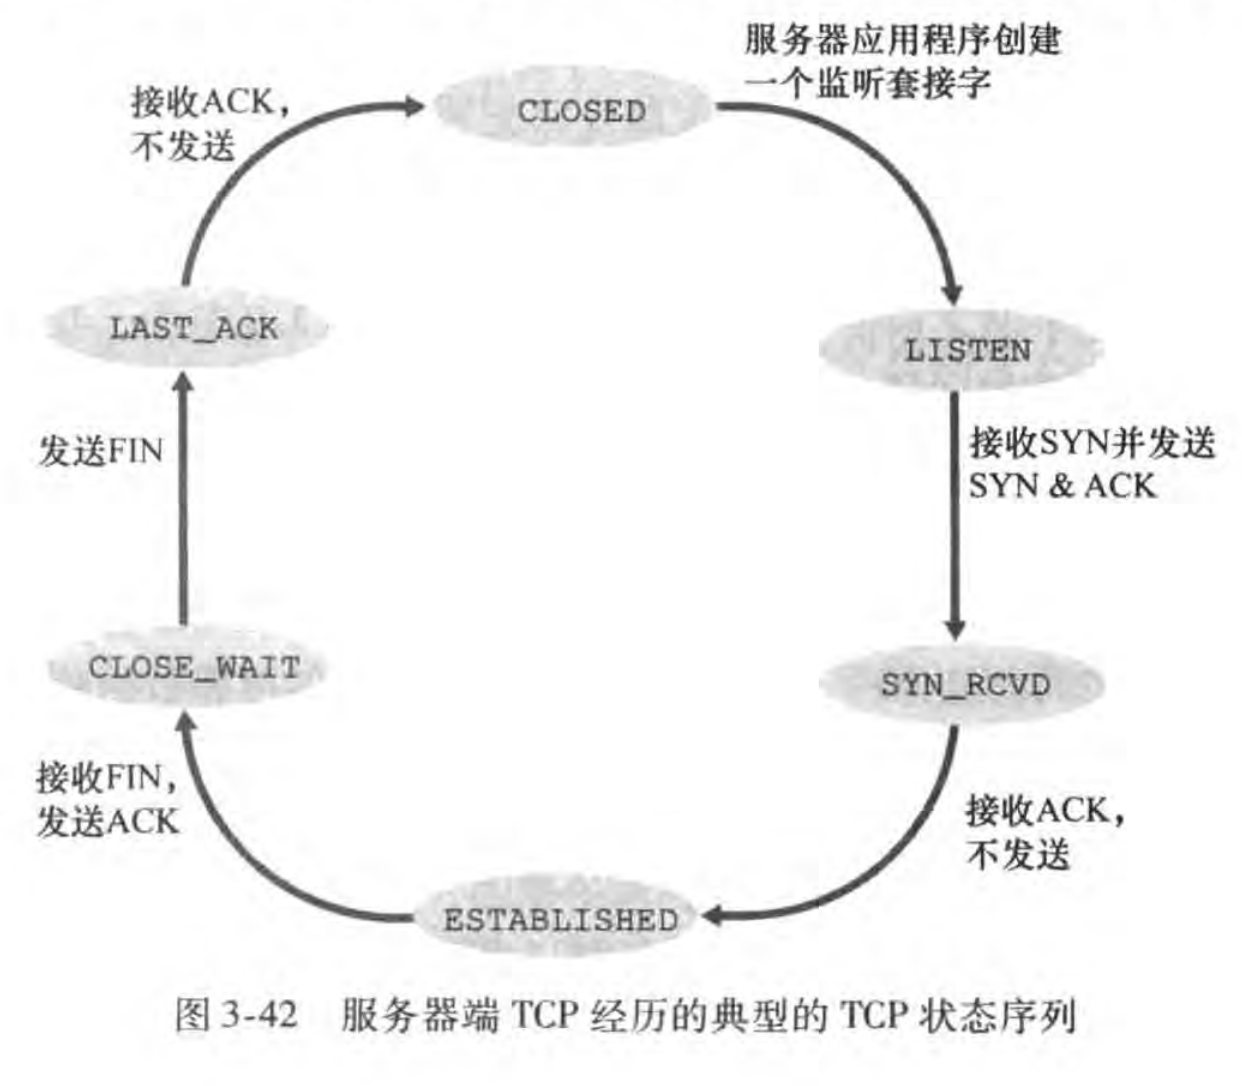
- SYN 洪泛攻击与防御:攻击者短时间内向服务器狂掷虚假源 IP 的 SYN 包而不回送第三次握手 ACK,消耗服务端的半开连接表资源。防御策略是启用 SYN Cookie 技术,在服务器端完全不分配半开连接状态,仅通过密码学哈希将状态压缩进握手报文的
server_isn中。
拥塞控制原理
当网络中过多主机向路由器注入超出链路承载能力的数据时,会引发中间路由器缓冲区队列持续积压、排队时延飙升以及大量丢包,导致网络吞吐量崩溃。
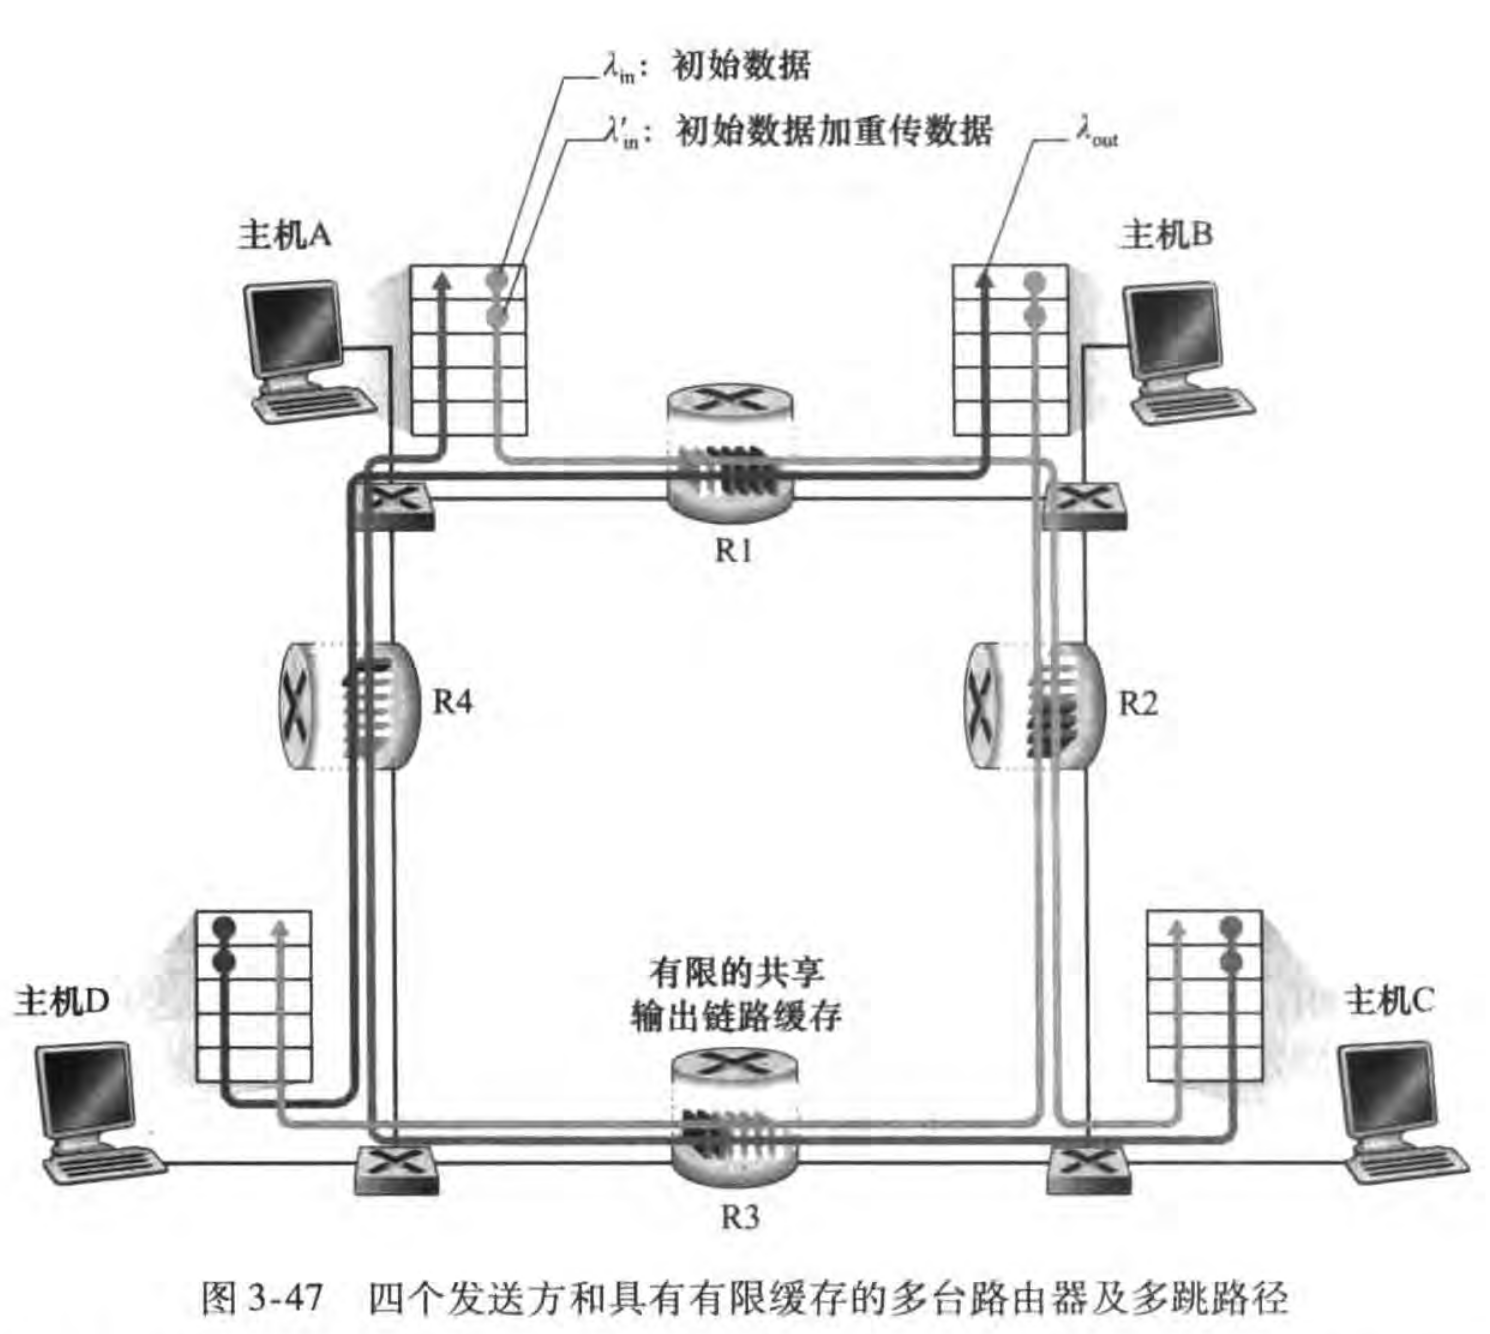
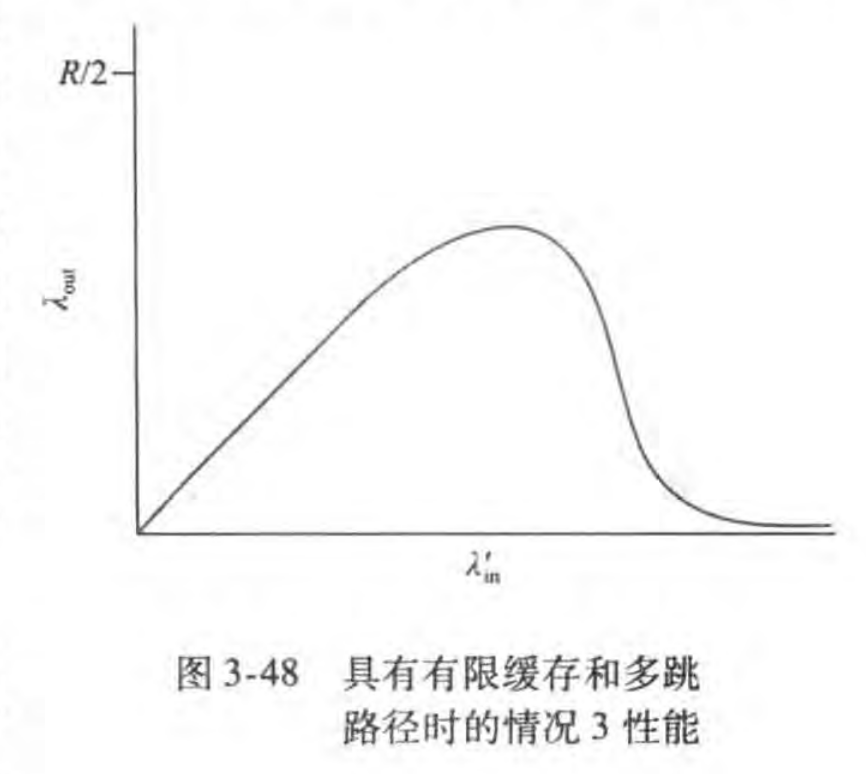
当供给载荷(Offered Load)持续增加时,下游路由器因为严重拥塞被迫丢弃上游已经消耗了多段链路带宽转发过来的分组,导致上游投入的传输容量被彻底白白浪费。
拥塞控制机制分类
- 端到端拥塞控制:网络层不给端系统任何显式提示,网络对端系统而言完全是黑盒。端系统仅通过感知分组丢包(超时或冗余 ACK)和 RTT 波动来隐式推断拥塞。经典 TCP 采取此方案。
- 网络辅助的拥塞控制:中间路由器直接在分组中标记字段通知端系统(如 ECN,显式拥塞通知,RFC 3168)。当路由器检测到排队拥塞时对 IP 首部打上 CE 标记,接收端在 TCP 首部中置位
ECE回传给发送端,发送端随即将窗口减半并将后续报文置位CWR进行确认。
TCP 拥塞控制算法(AIMD)
TCP 发送端维护一个拥塞窗口(cwnd, Congestion Window),与接收窗口共同约束当前在飞未确认的最大字节数:
发送速率约为 字节/秒。TCP 拥塞控制的核心状态机包含三个阶段:
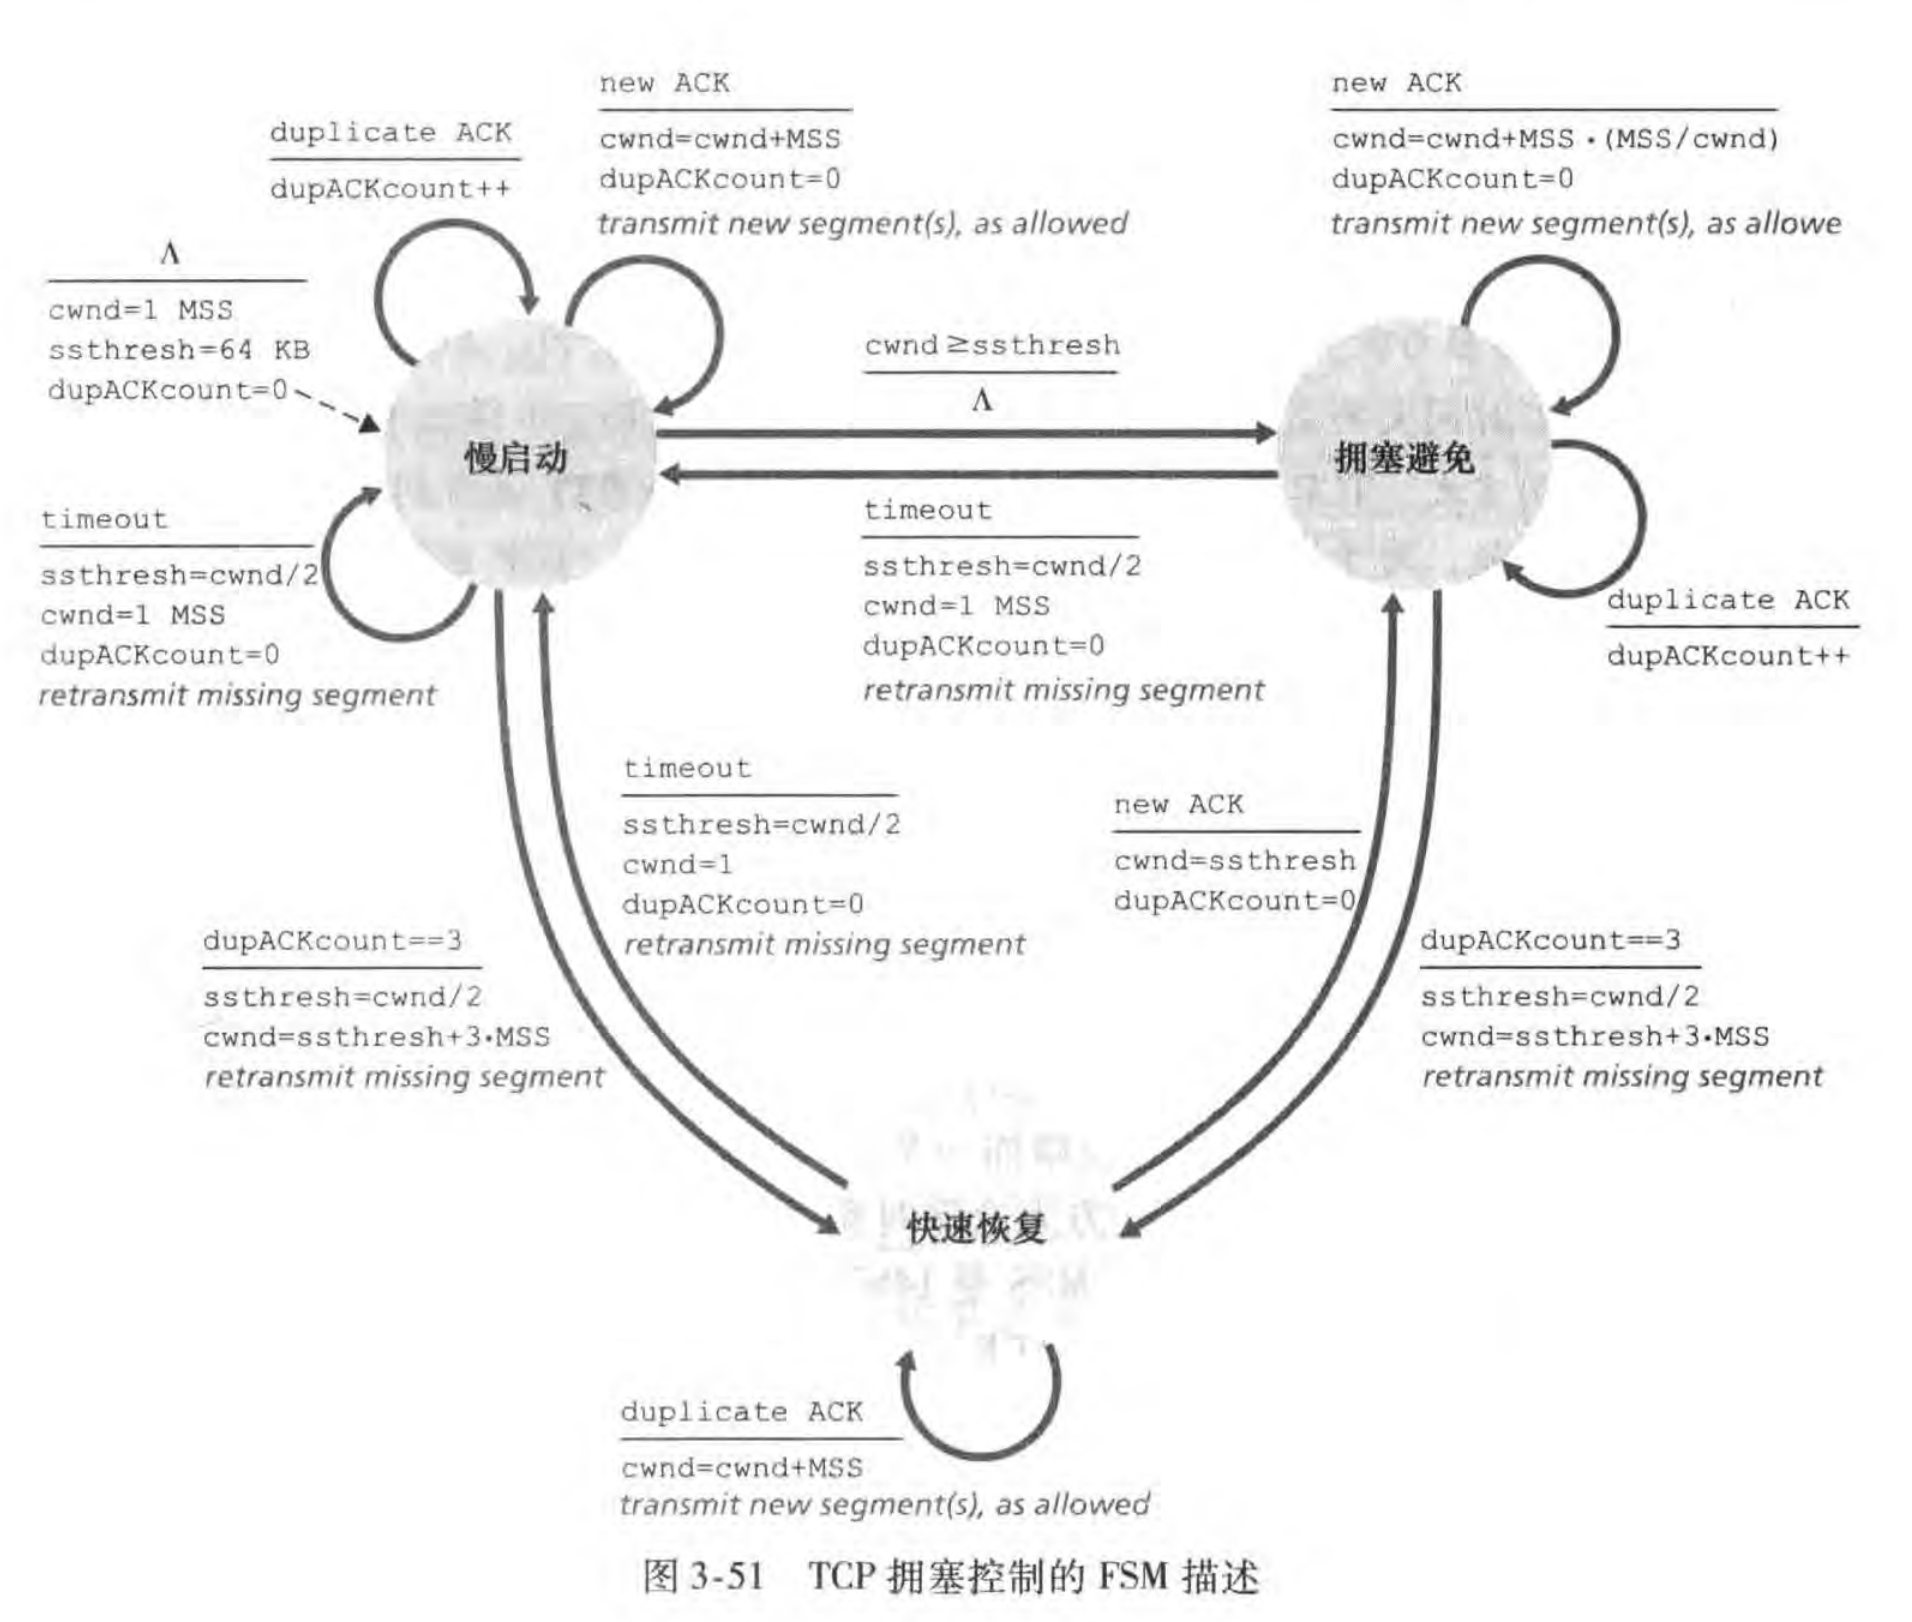
- 慢启动(Slow Start):
连接刚建立时,
cwnd设为较小的初始值(如 1 个 MSS)。每收到一个有效 ACK,cwnd增加 1 个 MSS。这使得cwnd在每个 RTT 内呈指数级成倍增长,直至达到慢启动门限ssthresh。 - 拥塞避免(Congestion Avoidance,加性增):
当
cwnd >= ssthresh时,进入线性探测阶段。每个 RTT 仅将cwnd增加 1 个 MSS,小心翼翼地探测网络可用容量。 - 快速恢复(Fast Recovery,乘性减):
- 当遭遇 3 个冗余 ACK 丢包事件时:
ssthresh被削减为当前cwnd的一半,cwnd减半后直接进入快速恢复与拥塞避免,避免退回至 1 MSS 重新慢启动。 - 当遭遇重度定时器超时丢包时:说明网络拥塞严重,
ssthresh设为cwnd / 2,cwnd被强制重置为 1 MSS,重新从慢启动开始爬升。
- 当遭遇 3 个冗余 ACK 丢包事件时:
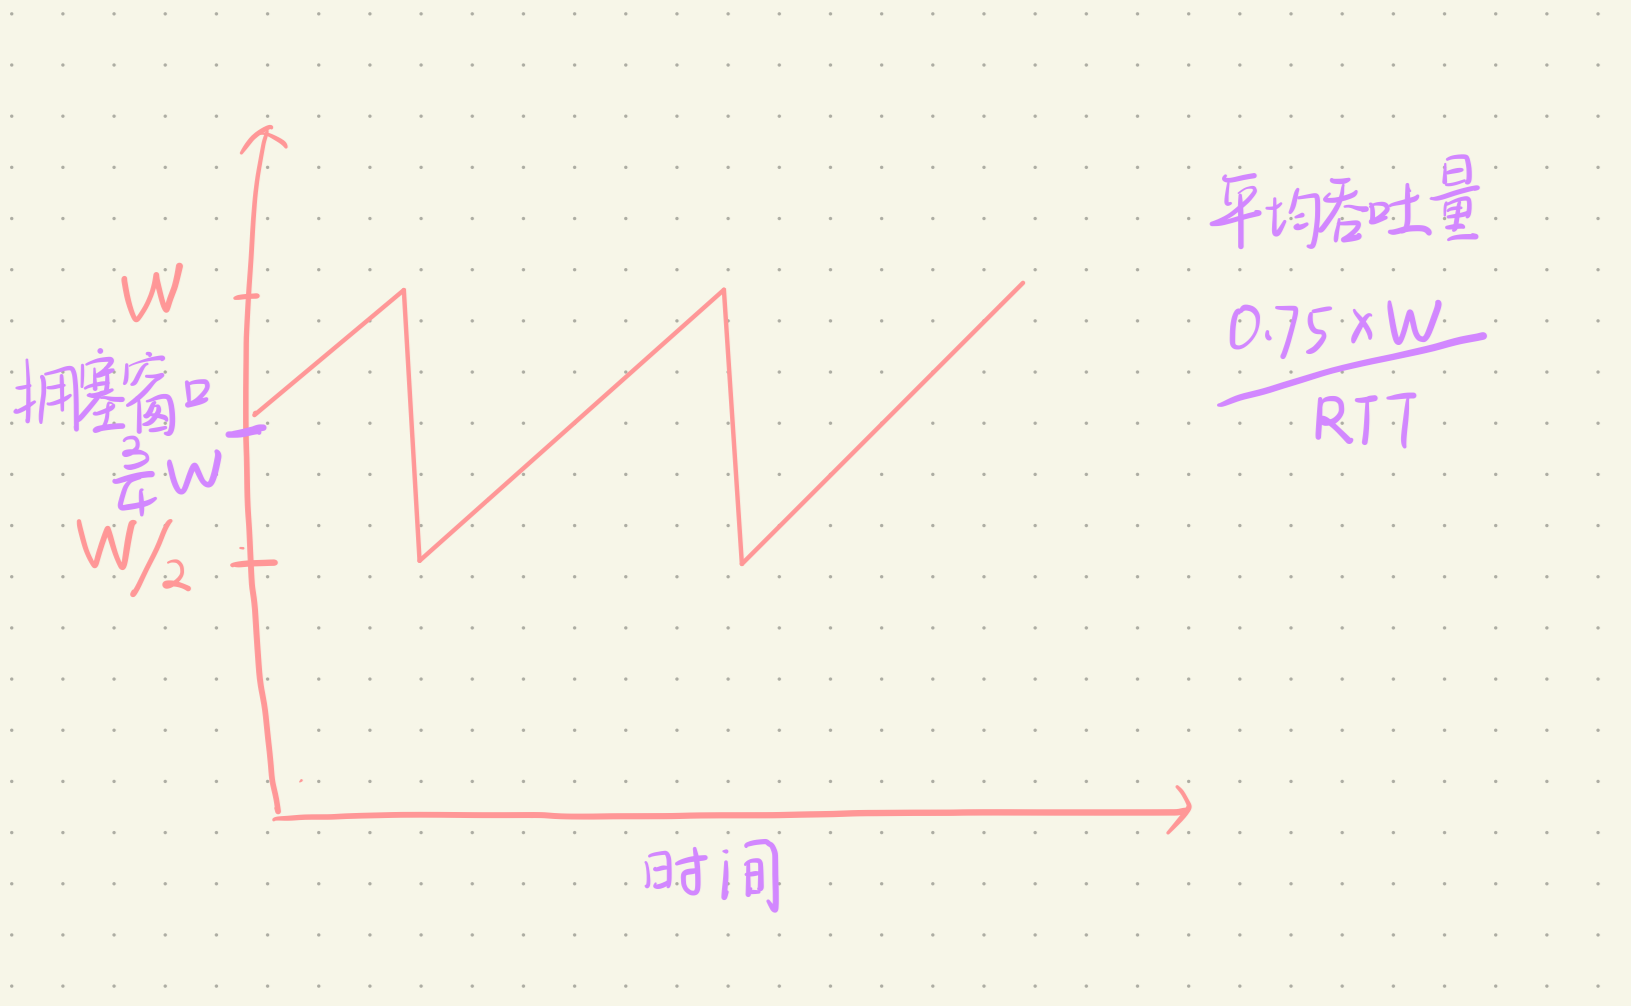
宏观上看,TCP 的拥塞控制曲线呈现典型的“锯齿状”(加性增、乘性减)。在无并发干扰的理想条件下,单连接长期运行的平均吞吐量公式约为: 其中 为丢包发生时的最大窗口尺寸。